O que a Engenharia de Dados ensina sobre persistência
Grandes pipelines não nascem prontos — eles começam com pequenos scripts, testes simples e muita persistência
01/07/2026 Engenharia de Dados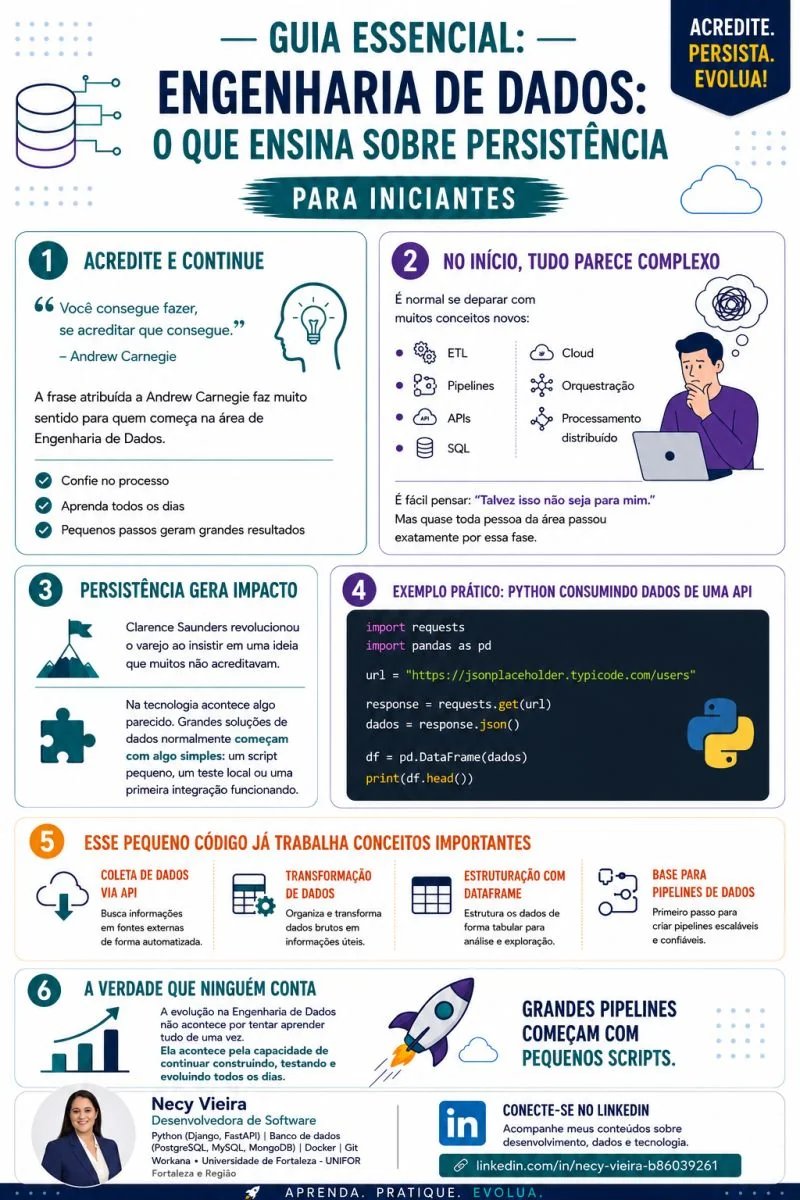
“Você consegue fazer, se acreditar que consegue.”
A frase atribuída a Andrew Carnegie faz muito sentido para quem está começando em Engenharia de Dados.
No início, tudo parece extremamente complexo.
Você começa a ouvir termos como:
ETL
Pipelines
APIs
SQL
Cloud
Orquestração
Processamento distribuído
E muitas vezes surge aquele pensamento:
“Talvez isso não seja para mim...”Mas existe algo importante que quase ninguém te conta no começo:
Quase todo profissional de Engenharia de Dados já passou exatamente por essa fase.
O começo quase sempre parece difícil
Quando olhamos para arquiteturas modernas de dados, tudo parece sofisticado demais.
Data Lakes, Data Warehouses, Spark, Kafka, Airflow, Databricks, Machine Learning...
Parece que todo mundo domina tudo.
Mas a realidade é diferente.
Todo especialista já foi iniciante.
Toda arquitetura robusta começou pequena.
Todo pipeline escalável começou com uma primeira linha de código.
Grandes transformações começam simples
Clarence Saunders revolucionou o varejo ao insistir em uma ideia que muitos não acreditavam.
Ele enxergou valor em algo que parecia improvável.
Na tecnologia acontece algo muito parecido.
Grandes soluções de dados raramente nascem grandes.
Elas normalmente começam como:
Um script simples
Um teste local
Uma consulta SQL básica
Uma API funcionando pela primeira vez
O importante não é começar perfeito.
O importante é continuar evoluindo.
Exemplo simples em Python consumindo uma API
Um pipeline de dados pode começar com algo tão simples quanto isso:
import requests
import pandas as pd

url = "https://jsonplaceholder.typicode.com/users"

response = requests.get(url)

dados = response.json()

df = pd.DataFrame(dados)

print(df.head())
À primeira vista, parece apenas um código pequeno.
Mas ele já introduz conceitos fundamentais da Engenharia de Dados.
O que esse código ensina?
Coleta de dados via API
Transformação de dados
Estruturação em DataFrame
Base para pipelines maiores
Em outras palavras:
API → Extração → Transformação → EstruturaçãoEsse fluxo representa a essência de muitos pipelines reais.
A evolução acontece em camadas
Depois de dominar scripts simples, você evolui para desafios maiores.
Por exemplo:
Consumir múltiplas APIs
Processar grandes volumes
Armazenar em Data Lake
Orquestrar com Airflow
Escalar com Spark
Percebe?
Ninguém começa no passo cinco.
A evolução vem em camadas.
Persistência vale mais que velocidade
Um erro comum de iniciantes é achar que precisam aprender tudo imediatamente.
Não precisam.
Engenharia de Dados não recompensa quem tenta absorver tudo em uma semana.
Ela recompensa quem consegue:
Continuar estudando
Testar na prática
Aprender com erros
Evoluir continuamente
Persistência gera profundidade.
Profundidade gera confiança.
Confiança gera oportunidades.
Engenharia de Dados ensina algo além de tecnologia
Muita gente pensa que Engenharia de Dados é apenas código.
Mas ela ensina algo muito maior:
Problemas complexos são resolvidos passo a passoIsso vale para pipelines.
Vale para carreira.
Vale para a vida.
Grandes sistemas não são construídos em um único dia.
Grandes profissionais também não.
A principal lição
A evolução na Engenharia de Dados não acontece tentando aprender tudo de uma vez.
Ela acontece pela capacidade de continuar construindo, testando e evoluindo todos os dias.
Pequenos scripts → Pequenos pipelines → Grandes soluçõesGrandes pipelines começam com pequenos scripts.
Continue construindo.
Continue aprendendo.
Continue persistindo.
Porque muitas vezes a única diferença entre quem conseguiu e quem desistiu foi justamente essa:
Persistência.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. No exemplo de código em Python apresentado no artigo, quais bibliotecas foram utilizadas para consumir uma API e estruturar os dados?
Resposta correta: B) requests e pandas
O código do artigo usa import requests para consumir a API e import pandas as pd para estruturar os dados em um DataFrame.
2. Segundo o artigo, qual fluxo é representado pelo exemplo de código que consome uma API?
Resposta correta: A) API → Extração → Transformação → Estruturação
O artigo apresenta exatamente esse fluxo como a essência de muitos pipelines reais de Engenharia de Dados.
3. Qual foi a principal lição destacada no artigo sobre a evolução de um profissional ou pipeline de Engenharia de Dados?
Resposta correta: B) Grandes soluções raramente nascem grandes; a evolução acontece em camadas, com persistência
O artigo reforça que "ninguém começa no passo cinco" e que a evolução acontece em camadas, do script simples ao pipeline escalável.
4. De acordo com o artigo, o que geralmente faz a diferença entre quem consegue evoluir em Engenharia de Dados e quem desiste?
Resposta correta: B) A persistência em continuar construindo, testando e aprendendo todos os dias
O artigo encerra afirmando que "a única diferença entre quem conseguiu e quem desistiu foi justamente essa: Persistência."