Engenharia de Dados: a base que sustenta a IA
Antes de qualquer modelo de Inteligência Artificial impressionar alguém, existe uma camada invisível de pipelines, arquitetura e qualidade de dados sustentando tudo.
30/08/2026 Engenharia de Dados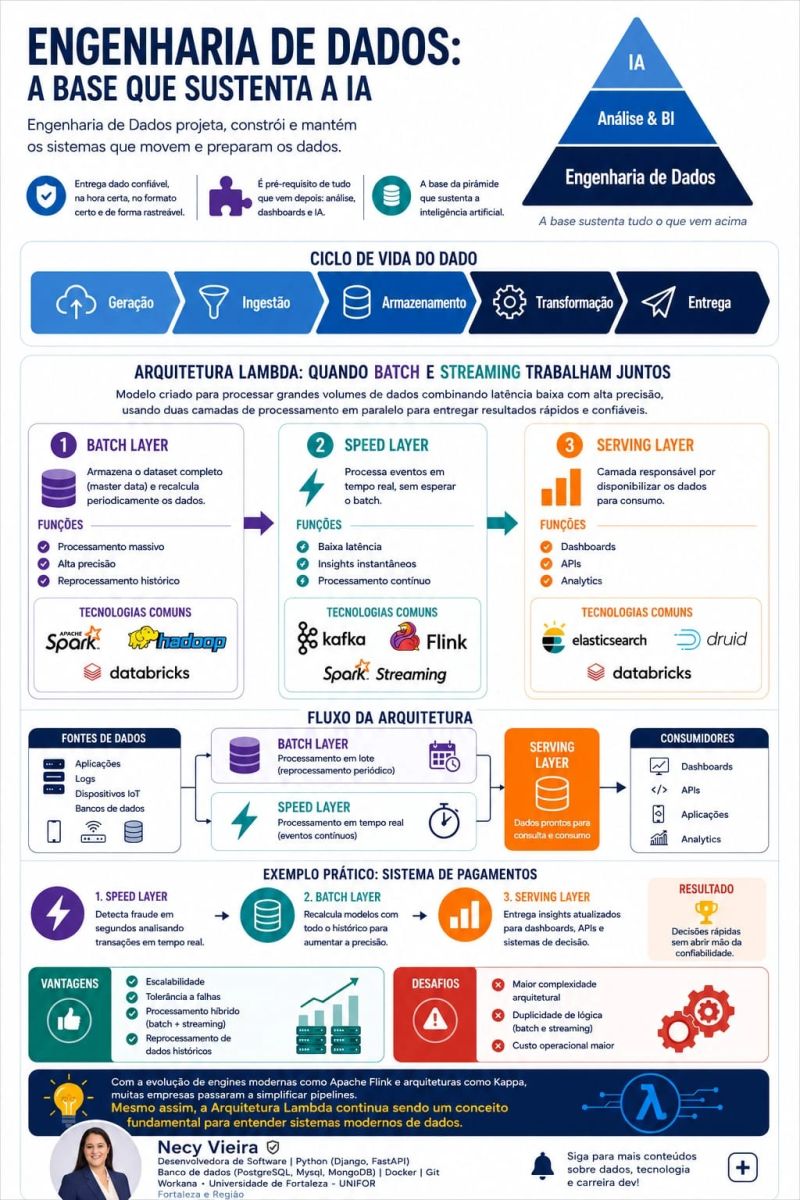
Muita gente fala sobre Inteligência Artificial, Machine Learning e Analytics. Pouca gente fala sobre o que realmente sustenta tudo isso.
Por trás de qualquer modelo — por mais sofisticado que seja — existe uma camada que raramente aparece nas manchetes: a Engenharia de Dados. Sem pipelines confiáveis, dados limpos e uma arquitetura escalável, até o melhor modelo de IA perde valor.
O que a Engenharia de Dados realmente entrega
Antes de qualquer treinamento de modelo, alguém precisa garantir que os dados certos cheguem no lugar certo, no formato certo e no momento certo. Essa é a responsabilidade central da Engenharia de Dados:
- Coletar dados de múltiplas fontes — sistemas transacionais, APIs, eventos, arquivos e serviços externos
- Processar grandes volumes com eficiência — sem comprometer performance nem custo
- Garantir qualidade, consistência e rastreabilidade — para que ninguém precise "confiar às cegas" em um número
- Disponibilizar dados para análises, dashboards e IA — na estrutura que cada consumidor final precisa
Arquitetura Lambda: unindo tempo real e histórico
Um dos conceitos mais importantes desse universo é a Arquitetura Lambda, que combina dois mundos que normalmente competem entre si: velocidade e precisão.
- Speed Layer — processamento em tempo real, focado em baixa latência
- Batch Layer — reprocessamento histórico, focado em alta precisão
- Serving Layer — camada responsável por entregar os dados processados para consumo
Esse modelo permite unir velocidade, escalabilidade e confiabilidade — três características que, isoladamente, quase nenhuma arquitetura simples consegue entregar ao mesmo tempo.
Um exemplo prático: detecção de fraude
Imagine um sistema de pagamentos. Fraudes precisam ser detectadas em segundos — não há espaço para esperar um job noturno terminar. Mas análises históricas também são fundamentais para melhorar continuamente os modelos de detecção, identificar padrões novos e retreinar o que já existe.
É exatamente aí que arquiteturas de dados bem desenhadas fazem diferença: a Speed Layer garante a resposta imediata, enquanto a Batch Layer garante que o modelo continue aprendendo com o histórico completo, sem viés de curto prazo.
Lambda ou Kappa?
Vale lembrar que a Arquitetura Lambda não é a única resposta para esse problema. Arquiteturas streaming-first, como a Kappa, tratam tudo como stream — inclusive o reprocessamento histórico — eliminando a necessidade de manter duas camadas de processamento separadas. A escolha entre as duas costuma depender da complexidade da equipe, do volume de dados e da maturidade da infraestrutura de streaming disponível.
Resumindo
IA sem dados bem preparados é apenas teoria. Dados bem engenheirados transformam informação em decisão — e é isso que separa um modelo impressionante em uma demonstração de um modelo que realmente sustenta um produto em produção.
E você?
Já trabalhou com Arquitetura Lambda ou hoje prefere Kappa / streaming-first?
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Segundo o artigo, o que acontece com um modelo de Inteligência Artificial sofisticado quando não há uma boa Engenharia de Dados por trás dele?
Resposta correta: B) Ele perde valor, porque sem pipelines confiáveis, dados limpos e arquitetura escalável, até o melhor modelo de IA falha.
O artigo afirma logo no início que, sem essa base de Engenharia de Dados, até o melhor modelo de IA perde valor.
2. Um sistema de detecção de fraude precisa identificar uma transação suspeita em segundos, mas também precisa aprender continuamente com o histórico completo de transações. Qual camada da Arquitetura Lambda, descrita no artigo, é responsável por cada uma dessas necessidades?
Resposta correta: B) A Speed Layer cuida da resposta em tempo real, e a Batch Layer cuida do reprocessamento histórico.
O artigo descreve a Speed Layer como processamento em tempo real de baixa latência, e a Batch Layer como reprocessamento histórico focado em alta precisão, exemplificando exatamente com o caso de detecção de fraude.
3. Qual é a principal diferença entre a Arquitetura Lambda e a Arquitetura Kappa, segundo o artigo?
Resposta correta: A) A Kappa trata tudo como stream, inclusive o reprocessamento histórico, eliminando a necessidade de duas camadas de processamento separadas.
O artigo explica que arquiteturas streaming-first como a Kappa tratam tudo como stream, ao contrário da Lambda, que mantém Speed Layer e Batch Layer separadas.
4. De acordo com o artigo, quais são as três características que a Arquitetura Lambda consegue unir, algo que uma arquitetura simples dificilmente entrega ao mesmo tempo?
Resposta correta: B) Velocidade, escalabilidade e confiabilidade.
O artigo afirma que a Arquitetura Lambda permite unir velocidade, escalabilidade e confiabilidade, características que uma arquitetura simples dificilmente entrega ao mesmo tempo.