Escalabilidade Vertical vs Horizontal: Quando o Banco Tradicional Não Aguenta Mais
Entenda por que uma única máquina tem limite físico e financeiro, e como o processamento distribuído do Big Data resolve isso com paralelismo e escala horizontal, com um exemplo prático de soma de vendas por região.
24/09/2026 Engenharia de Dados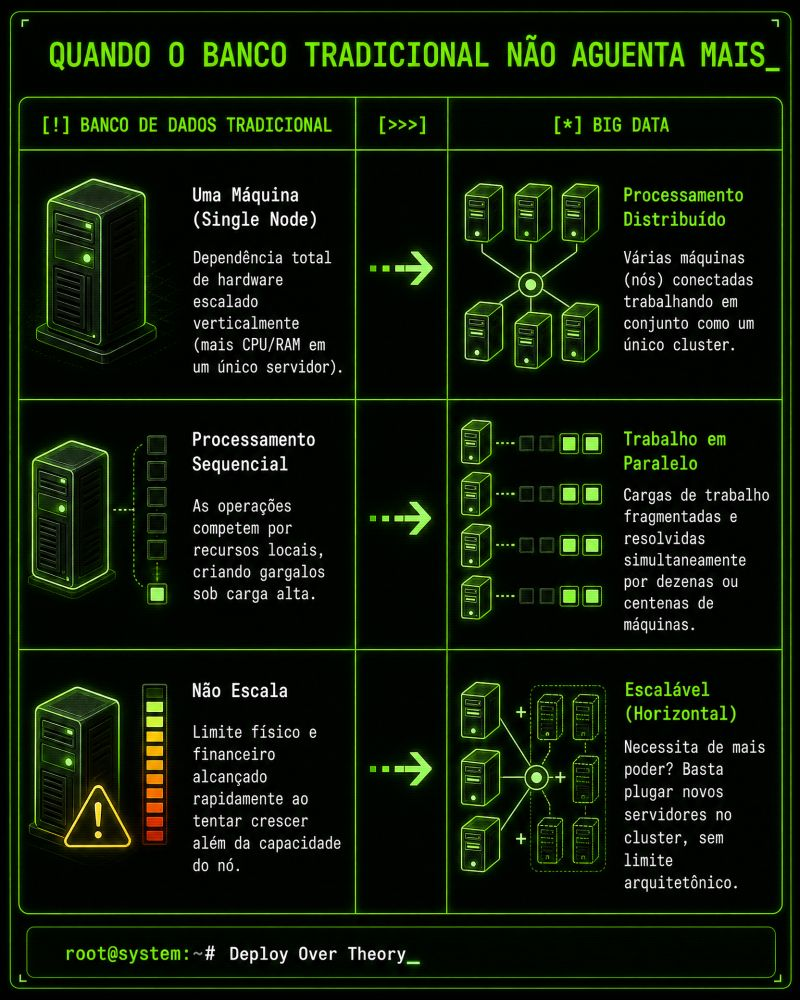
Todo sistema começa pequeno. Um único servidor de banco de dados dá conta do recado, as consultas voltam rápido e ninguém reclama. Só que o volume de dados cresce, o número de usuários aumenta e, em algum momento, aquele mesmo servidor que sempre funcionou bem começa a travar.
Antes de sair trocando de banco de dados ou de tecnologia, vale entender por que isso acontece. A resposta tem a ver com dois caminhos possíveis de escalabilidade: vertical e horizontal.
O caminho mais óbvio: escalar verticalmente
Quando um banco começa a engasgar, a primeira solução que vem à cabeça costuma ser: "vamos colocar uma máquina mais forte". Mais CPU, mais RAM, um disco mais rápido. Isso é escalabilidade vertical (scale up) — melhorar a capacidade de uma única máquina.
Funciona, e funciona bem por um tempo. O problema é que esse caminho tem dois limites que sempre aparecem:
- Limite físico: existe um teto de quanta CPU e RAM cabem em um único servidor. Cedo ou tarde, você esbarra no hardware mais potente que o mercado oferece.
- Limite financeiro: o custo de servidores de altíssima capacidade não cresce de forma linear — ele dispara. Dobrar a capacidade de uma máquina de ponta pode custar muito mais do que o dobro do preço.
Além disso, uma única máquina processa as operações de forma sequencial: as consultas competem pelos mesmos recursos locais (CPU, disco, memória). Sob carga alta, isso cria gargalos — uma consulta pesada pode deixar todas as outras mais lentas, porque todas disputam o mesmo hardware.
A virada de chave: pensar em Big Data
Foi justamente para resolver esse impasse que a área de Big Data se desenvolveu. A ideia central é simples de enunciar, mas poderosa na prática: em vez de uma máquina cada vez maior, use várias máquinas menores trabalhando juntas.
Esse conjunto de máquinas conectadas, funcionando como se fossem um único sistema, é chamado de cluster. Cada máquina do cluster é chamada de nó.
Ao invés de uma consulta ser processada do início ao fim por um único processador, o trabalho é fragmentado e distribuído entre os nós, que o executam em paralelo — dezenas ou centenas de máquinas resolvendo pedaços do mesmo problema ao mesmo tempo.
Escalabilidade horizontal: o antídoto para o limite
Esse modelo de crescimento é chamado de escalabilidade horizontal (scale out). Em vez de trocar uma máquina por outra mais forte, você simplesmente pluga mais servidores no cluster.
A diferença é estrutural: a escalabilidade vertical esbarra num teto arquitetônico (existe um limite de quanto uma máquina aguenta). Já a escalabilidade horizontal, em teoria, não tem limite arquitetônico — precisa de mais poder de processamento? Adicione mais nós ao cluster.
Isso não significa que escalar horizontalmente seja "de graça" — existe complexidade adicional em coordenar múltiplos nós, distribuir os dados corretamente e combinar os resultados. Mas o teto de crescimento deixa de ser o hardware de uma única máquina.
Exemplo prático: somando vendas por região
Para sair da teoria, vamos a um cenário concreto. Uma plataforma de e-commerce tem uma tabela pedidos com 500 milhões de linhas e precisa somar o valor total de vendas por região.
Abordagem tradicional: uma consulta, um nó, processamento sequencial
Em um banco relacional tradicional rodando em uma única máquina, a consulta seria algo assim:
SELECT regiao, SUM(valor) AS total_vendas
FROM pedidos
GROUP BY regiao;
Simples de escrever — mas o servidor precisa varrer as 500 milhões de linhas sequencialmente, competindo com todas as outras consultas que chegam ao mesmo tempo. Se essa tabela crescer para 2 bilhões de linhas, o tempo de resposta cresce junto, e a única saída dentro dessa arquitetura é colocar uma máquina ainda mais forte — até esbarrar no limite físico e financeiro que vimos antes.
Abordagem distribuída: particionar, paralelizar, combinar
Em uma arquitetura de Big Data, os mesmos 500 milhões de registros são particionados entre vários nós — por exemplo, 4 nós, cada um guardando cerca de 125 milhões de linhas. Um framework de processamento distribuído então executa a soma em paralelo, seguindo duas etapas:
- Map: cada nó soma o valor por região, mas apenas dentro da sua própria fatia de dados.
- Reduce: os resultados parciais de cada nó são combinados em um único resultado final.
Em pseudocódigo, cada nó roda algo equivalente a isto, de forma independente e simultânea:
# Etapa Map: cada nó processa só a sua partição, em paralelo
def map_soma_por_regiao(particao_do_no):
    parciais = {}
    for pedido in particao_do_no:
        parciais[pedido.regiao] = parciais.get(pedido.regiao, 0) + pedido.valor
    return parciais
# Etapa Reduce: o coordenador combina os resultados parciais dos nós
def reduce_soma_por_regiao(resultados_parciais_dos_nos):
total = {}
for parcial in resultados_parciais_dos_nos:
for regiao, valor in parcial.items():
total[regiao] = total.get(regiao, 0) + valor
return totalNote a diferença de raciocínio: em vez de uma máquina lendo 500 milhões de linhas em sequência, temos quatro máquinas lendo 125 milhões de linhas cada, ao mesmo tempo. Precisa ir mais rápido ou os dados dobraram de tamanho? Basta adicionar mais nós à conta — sem trocar hardware, sem redesenhar a arquitetura.
Vertical vs Horizontal: comparando os dois caminhos
| Aspecto | Escalabilidade Vertical | Escalabilidade Horizontal |
|---|---|---|
| Estratégia | Uma máquina mais forte | Mais máquinas trabalhando juntas |
| Processamento | Sequencial, em um único nó | Paralelo, distribuído entre nós |
| Limite de crescimento | Físico e financeiro (hardware de ponta) | Sem limite arquitetônico definido |
| Complexidade | Baixa — é só trocar a máquina | Maior — exige particionamento e coordenação entre nós |
| Cenário típico | Sistemas transacionais de porte pequeno/médio | Big Data, grandes volumes, alta concorrência |
Escalabilidade vertical ainda faz sentido?
Sim. Nem todo sistema precisa de um cluster distribuído. Se o volume de dados é administrável por uma única máquina bem dimensionada, escalar verticalmente é mais simples, mais barato de operar e evita a complexidade de coordenar múltiplos nós.
A escalabilidade horizontal compensa quando o volume de dados ou a carga de processamento já ultrapassou (ou vai ultrapassar em breve) o que uma única máquina consegue sustentar — é aí que "deploy over theory" vira prática: em vez de discutir infinitamente qual servidor comprar, você planeja a arquitetura para crescer adicionando nós.
Resumo Rápido
- Escalabilidade vertical: melhora a máquina existente; simples, mas esbarra em limites físicos e financeiros.
- Escalabilidade horizontal: adiciona mais máquinas ao cluster; mais complexa, mas sem teto arquitetônico.
- Processamento sequencial: uma máquina processando tudo, competindo por seus próprios recursos.
- Processamento paralelo: várias máquinas processando fatias diferentes dos dados ao mesmo tempo.
- Map-Reduce: um padrão comum em Big Data para paralelizar cálculos — cada nó processa sua parte (map) e os resultados são combinados no final (reduce).
E no seu projeto, o banco de dados atual ainda está confortável com o volume de dados, ou já é hora de pensar em processamento distribuído?
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Quais são os dois limites que a escalabilidade vertical sempre acaba enfrentando, segundo o artigo?
Resposta correta: B) Limite físico (hardware) e limite financeiro (custo).
O artigo explica que existe um teto de hardware disponível no mercado e que o custo de máquinas de altíssima capacidade não cresce de forma linear.
2. O que caracteriza a escalabilidade horizontal (scale out)?
Resposta correta: C) Adicionar mais máquinas (nós) ao cluster para dividir o trabalho.
O artigo define escalabilidade horizontal como plugar mais servidores no cluster, em vez de trocar por uma máquina mais forte.
3. No exemplo da soma de vendas por região, o que a etapa "Map" faz em cada nó?
Resposta correta: A) Soma os valores por região apenas dentro da partição de dados daquele nó.
Cada nó executa o "map" apenas sobre a sua própria fatia de dados, em paralelo com os outros nós; a combinação dos resultados acontece depois, na etapa "reduce".
4. Segundo o artigo, quando escalar verticalmente ainda é uma boa escolha?
Resposta correta: D) Quando o volume de dados é administrável por uma única máquina bem dimensionada, evitando a complexidade de coordenar múltiplos nós.
O artigo destaca que nem todo sistema precisa de um cluster distribuído — a escalabilidade horizontal compensa quando o volume já ultrapassa (ou vai ultrapassar) o que uma única máquina sustenta.