Modelagem SQL vs NoSQL: Como Mudar a Forma de Pensar
Tabelas normalizadas ou documentos com dados aninhados? Entenda a inversão de pensamento entre os dois mundos, com exemplos práticos de voos e de uma loja online.
18/09/2026 Bancos de Dados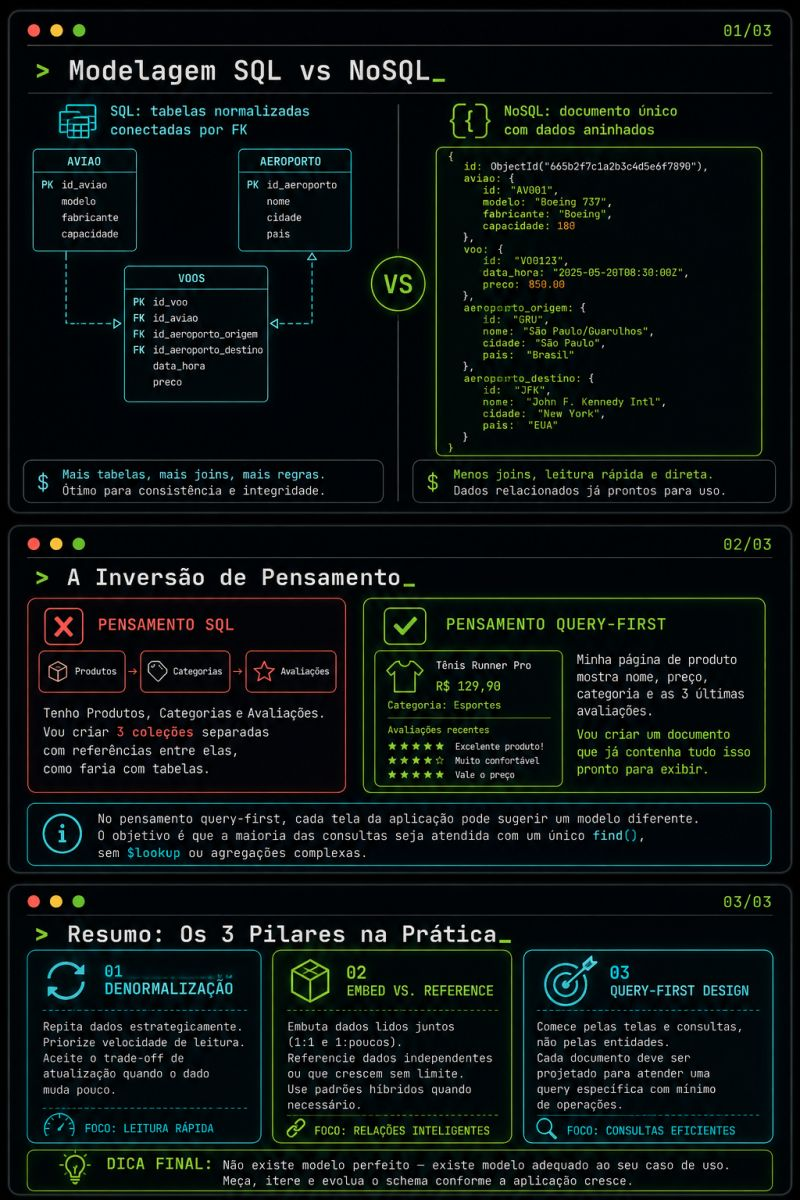
Quem aprendeu bancos de dados com SQL costuma cometer o mesmo erro ao chegar no NoSQL: desenhar as mesmas tabelas, só que chamando de "coleções". O banco muda, mas a cabeça continua a mesma — e o resultado é um modelo que funciona mal nos dois mundos.
A boa notícia é que existe uma lógica simples por trás da diferença. Neste post, vou mostrar essa lógica com exemplos práticos, do jeito mais direto possível. Os exemplos de NoSQL usam o formato de documentos JSON, como no MongoDB, o banco de documentos mais conhecido.
Se você quer uma visão geral das diferenças entre os dois tipos de banco, comece por SQL vs NoSQL: Entenda as Diferenças na Prática. Aqui o foco é outro: como modelar.
1. O Mesmo Problema, Dois Modelos
Imagine um sistema de passagens aéreas. Precisamos guardar aviões, aeroportos e voos. Um voo usa um avião e liga um aeroporto de origem a um de destino.
No SQL: dados separados e conectados por chaves
A abordagem SQL é normalizar: cada informação vive em um único lugar (sua própria tabela) e as tabelas se conectam por chaves estrangeiras (FK).
CREATE TABLE aviao (
  id_aviao   VARCHAR(10) PRIMARY KEY,
  modelo     VARCHAR(50),
  fabricante VARCHAR(50),
  capacidade INT
);

CREATE TABLE aeroporto (
  id_aeroporto CHAR(3) PRIMARY KEY,
  nome         VARCHAR(100),
  cidade       VARCHAR(50),
  pais         VARCHAR(50)
);

CREATE TABLE voo (
  id_voo               VARCHAR(10) PRIMARY KEY,
  id_aviao             VARCHAR(10) REFERENCES aviao (id_aviao),
  id_aeroporto_origem  CHAR(3)     REFERENCES aeroporto (id_aeroporto),
  id_aeroporto_destino CHAR(3)     REFERENCES aeroporto (id_aeroporto),
  data_hora            TIMESTAMP,
  preco                DECIMAL(10,2)
);
Para montar a tela de detalhes de um voo, precisamos juntar tudo com JOIN:
SELECT v.id_voo, v.data_hora, v.preco,
       a.modelo,
       o.cidade AS origem,
       d.cidade AS destino
FROM voo v
JOIN aviao a      ON a.id_aviao = v.id_aviao
JOIN aeroporto o  ON o.id_aeroporto = v.id_aeroporto_origem
JOIN aeroporto d  ON d.id_aeroporto = v.id_aeroporto_destino
WHERE v.id_voo = 'VO123';
Resumo do SQL: mais tabelas, mais joins, mais regras. Em troca, você ganha consistência e integridade: se o nome de um aeroporto mudar, basta atualizar uma única linha.
No NoSQL: um documento com tudo que a tela precisa
Em um banco de documentos, a abordagem é guardar os dados relacionados juntos, dentro de um único documento:
{
  "_id": "VO123",
  "data_hora": "2026-05-20T08:30:00Z",
  "preco": 850.00,
  "aviao": {
    "id": "AV001",
    "modelo": "Boeing 737",
    "fabricante": "Boeing",
    "capacidade": 180
  },
  "aeroporto_origem": {
    "id": "GRU",
    "nome": "São Paulo/Guarulhos",
    "cidade": "São Paulo",
    "pais": "Brasil"
  },
  "aeroporto_destino": {
    "id": "JFK",
    "nome": "John F. Kennedy Intl",
    "cidade": "Nova York",
    "pais": "EUA"
  }
}
E a consulta fica assim, sem nenhum join:
db.voos.find({ _id: "VO123" })Resumo do NoSQL: menos joins, leitura rápida e direta, com os dados relacionados já prontos para uso. O preço é a repetição: o aeroporto GRU aparece em todos os voos que saem de lá.
2. A Inversão de Pensamento
Aqui está a virada de chave mais importante do post:
- Pensamento SQL: "O que eu tenho?" Começo pelas entidades (produtos, categorias, avaliações) e depois descubro como consultá-las.
- Pensamento query-first (NoSQL): "O que eu preciso mostrar?" Começo pelas telas e consultas da aplicação e desenho o documento a partir delas.
Exemplo: a página de produto de uma loja online
Nossa página de produto precisa mostrar: nome, preço, categoria e as 3 últimas avaliações.
Pensando como SQL, eu diria: "tenho Produtos, Categorias e Avaliações, então vou criar 3 coleções separadas com referências entre elas". Para montar a página, o banco precisaria buscar nas três:
db.produtos.aggregate([
  { $match: { _id: "P1001" } },
  { $lookup: {
      from: "categorias",
      localField: "categoria_id",
      foreignField: "_id",
      as: "categoria"
  } },
  { $lookup: {
      from: "avaliacoes",
      localField: "_id",
      foreignField: "produto_id",
      as: "avaliacoes"
  } }
])
Funciona, mas é o "join do SQL" disfarçado, e ainda falta ordenar e limitar as avaliações às 3 mais recentes.
Pensando query-first, eu diria: "minha página mostra tudo isso junto, então vou criar um documento que já contenha tudo isso pronto para exibir":
{
  "_id": "P1001",
  "nome": "Tênis Runner Pro",
  "preco": 129.90,
  "categoria": { "id": "C10", "nome": "Esportes" },
  "avaliacoes_recentes": [
    { "usuario": "Ana",   "nota": 5, "comentario": "Excelente produto!" },
    { "usuario": "Bruno", "nota": 4, "comentario": "Muito confortável" },
    { "usuario": "Carla", "nota": 5, "comentario": "Vale o preço" }
  ]
}
db.produtos.find({ _id: "P1001" })
Uma consulta, um documento, a tela inteira. É por isso que, no NoSQL, cada tela pode sugerir um modelo diferente. O objetivo é que a maioria das consultas seja atendida com um único find(), sem $lookup nem agregações complexas.
3. Os 3 Pilares na Prática
Para modelar bem em NoSQL, três ideias se repetem o tempo todo.
Pilar 1: Denormalização (foco: leitura rápida)
Denormalizar é repetir dados de forma estratégica para que a leitura seja rápida. Foi o que fizemos ao copiar o nome da categoria para dentro do produto.
O custo aparece quando o dado muda. Se a categoria "Esportes" for renomeada, será preciso atualizar todos os produtos que a carregam:
db.produtos.updateMany(
  { "categoria.id": "C10" },
  { $set: { "categoria.nome": "Esportes e Lazer" } }
)
Por isso a regra prática é: repita dados que mudam pouco (nome de categoria, cidade de um aeroporto) e aceite o trade-off de atualizá-los em mais de um lugar. Dados que mudam o tempo todo e são compartilhados por muitos documentos pedem mais cuidado.
Pilar 2: Embed vs Reference (foco: relações inteligentes)
Sempre que dois dados se relacionam, você escolhe entre duas opções:
- Embed (embutir): colocar o dado relacionado dentro do documento.
- Reference (referenciar): guardar só o identificador e manter o dado em outra coleção.
Um guia rápido para decidir:
- Embuta quando os dados são lidos juntos e a relação é 1:1 ou 1:poucos. Exemplos: o endereço de entrega de um pedido, os 3 telefones de um cliente, as 3 últimas avaliações de um produto.
- Referencie quando os dados são independentes ou crescem sem limite. Exemplos: todas as avaliações de um produto muito popular, ou todos os pedidos de um cliente ao longo dos anos.
O segundo caso é importante: um documento não pode crescer para sempre. No MongoDB, por exemplo, cada documento tem limite de 16 MB, e listas que só aumentam também deixam as leituras e as atualizações mais pesadas.
Quando nenhuma das duas opções serve sozinha, use um padrão híbrido. No nosso exemplo, o produto embute apenas as 3 avaliações mais recentes (para a página abrir rápido) e todas as avaliações continuam guardadas em uma coleção própria, referenciando o produto:
// Coleção "avaliacoes": histórico completo
{ "_id": "A9001", "produto_id": "P1001", "usuario": "Ana", "nota": 5, "comentario": "Excelente produto!" }
Assim você tem o melhor dos dois: leitura rápida na tela principal e histórico completo sem estourar o documento do produto.
Pilar 3: Query-First Design (foco: consultas eficientes)
É a ideia que amarra as outras duas: comece pelas telas e consultas, não pelas entidades. Cada documento deve ser projetado para atender a uma consulta específica com o mínimo de operações.
Na prática, antes de modelar, faça uma lista de perguntas:
- Quais telas ou relatórios a aplicação terá?
- Que dados aparecem juntos em cada tela?
- Com que frequência cada consulta roda? E cada atualização?
- Quais dados mudam com frequência e quais quase nunca mudam?
As respostas indicam o que embutir, o que referenciar e o que vale repetir.
Erros Comuns ao Modelar em NoSQL
- Copiar o modelo relacional: criar uma coleção para cada tabela e depender de vários
$lookupdesperdiça a principal vantagem do modelo de documentos. - Embutir tudo, sem limite: listas que crescem para sempre (todos os pedidos dentro do cliente, por exemplo) acabam causando problemas.
- Repetir dados que mudam toda hora: manter cópias sincronizadas vira um pesadelo.
- Modelar sem conhecer as consultas: sem saber o que a aplicação precisa ler, é impossível escolher o modelo certo.
Quando o SQL Ainda É a Melhor Escolha?
Nada disso significa que o NoSQL seja "melhor". Se o seu sistema tem muitos relacionamentos, exige consistência forte entre várias entidades (como transações financeiras) e faz consultas variadas e imprevisíveis, o modelo relacional continua sendo uma ótima escolha. A modelagem NoSQL brilha quando você conhece bem os padrões de acesso e quer leitura rápida e escala.
Resumo Rápido
- SQL: começa pelas entidades, normaliza os dados e usa joins na leitura.
- NoSQL: começa pelas consultas, agrupa os dados que são lidos juntos e evita joins na leitura.
- Denormalização: repita dados com estratégia, priorizando velocidade de leitura.
- Embed vs Reference: embuta o que é lido junto e cresce pouco; referencie o que é independente ou cresce sem limite.
- Query-first: cada documento nasce para responder a uma consulta específica.
Dica Final
Não existe modelo perfeito — existe modelo adequado ao seu caso de uso. Meça, itere e evolua o schema conforme a aplicação cresce.
Uma das grandes vantagens dos bancos de documentos é justamente a flexibilidade: você pode começar simples, observar como a aplicação realmente lê e grava os dados, e ajustar o modelo com o tempo.
E no seu projeto, você costuma partir das entidades ou das telas ao modelar os dados? Conte nos comentários como você decide entre embutir e referenciar!
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Qual é a principal mudança de raciocínio do design query-first em NoSQL?
Resposta correta: A) Começar pelas telas e consultas da aplicação, e não pelas entidades
No pensamento query-first, o documento é desenhado a partir do que a tela precisa mostrar, para que a consulta seja atendida com o mínimo de operações.
2. Em qual situação faz mais sentido referenciar (reference) em vez de embutir (embed) os dados?
Resposta correta: C) Todas as avaliações de um produto muito popular, que crescem sem limite
Dados que crescem sem limite ou são independentes devem ser referenciados. Embutir só é indicado para dados lidos juntos e em relações 1:1 ou 1:poucos.
3. O que é denormalização e qual é o seu principal custo?
Resposta correta: B) Repetir dados estrategicamente para acelerar a leitura; o custo é atualizar mais de um lugar quando o dado muda
Como no exemplo da categoria "Esportes" copiada para os produtos: a leitura fica rápida, mas renomear a categoria exige atualizar todos os documentos que a carregam.
4. No exemplo do voo, qual é a vantagem de guardar avião, origem e destino dentro de um único documento?
Resposta correta: D) A leitura é rápida e direta, sem precisar de joins
Com os dados relacionados já dentro do documento, um único find() traz o voo completo. Em compensação, dados como o aeroporto ficam repetidos em vários voos.
5. Segundo a dica final do artigo, como escolher o modelo de dados ideal?
Resposta correta: B) Escolher o modelo adequado ao caso de uso, medindo, iterando e evoluindo o schema conforme a aplicação cresce
Não existe modelo perfeito, e sim o modelo adequado ao caso de uso. A flexibilidade dos bancos de documentos permite ajustar o schema com o tempo.