Star, Snowflake e Factless: Treine para Decidir como Modelar seu Data Warehouse
Star, Snowflake e Factless parecem três opções do mesmo cardápio, mas respondem a duas perguntas diferentes. Treine em cinco missões práticas até separar essas decisões por instinto.
07/10/2026 Engenharia de Dados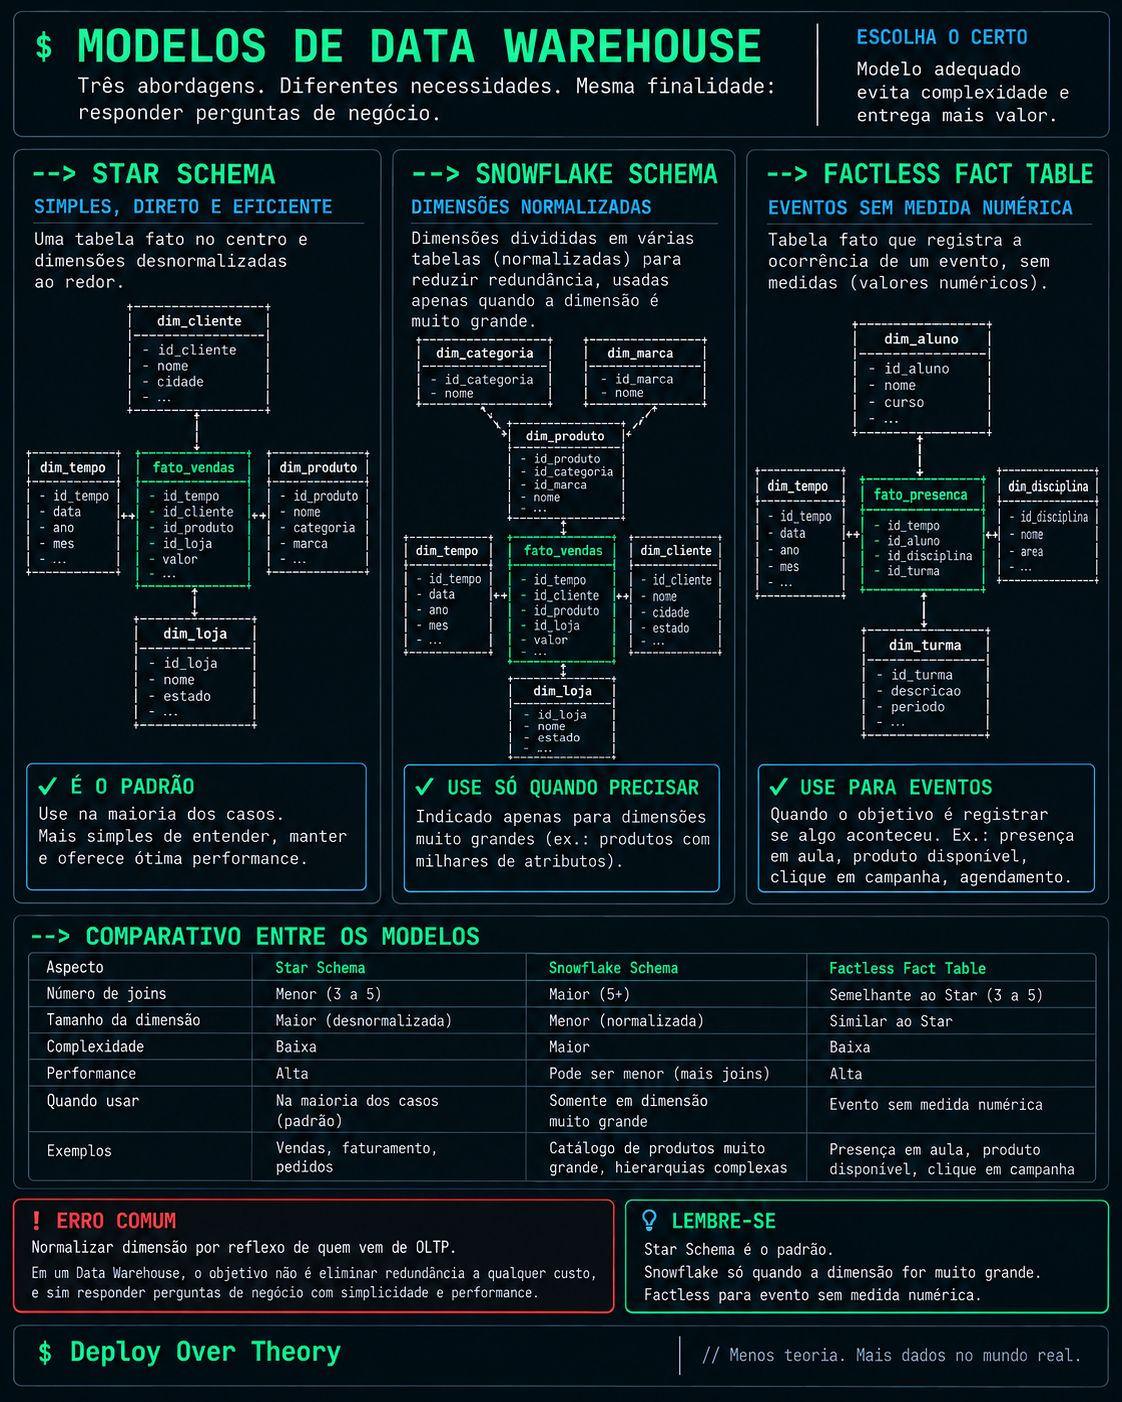
Poucas decisões de modelagem têm tanto impacto no dia a dia de um time de dados quanto a escolha do modelo do Data Warehouse. Ela influencia a estrutura das consultas, quanto tempo um analista leva para entender o modelo e se o dashboard responde em segundos ou em minutos. Mesmo assim, muita gente escolhe por hábito: quem vem de bancos transacionais tende a normalizar tudo, porque foi assim que aprendeu.
Neste artigo você vai treinar. São cinco missões, com XP, feedback imediato e um comparador de consultas que mostra o custo real de cada escolha. No final, um rank e um quiz de revisão. Reserve de 15 a 20 minutos.
- 1
- 2
- 3
- 4
- 5
Aquecimento: fatos, dimensões e a pergunta de negócio
A modelagem dimensional parte de uma ideia simples: todo evento de negócio (uma venda, uma presença, um clique) tem medidas (valores numéricos, como o valor da venda) e contexto (quem, o quê, onde, quando). As medidas ficam na tabela fato; o contexto fica nas dimensões. Star, Snowflake e Factless são variações dessa mesma estrutura, mas não são três opções mutuamente exclusivas: elas respondem a duas perguntas diferentes.
Um lembrete antes de começar: o nível de detalhe de cada linha da fato é o grão da tabela fato, e ele deve ser definido antes de escolher qualquer modelo. Se o grão está confuso, nenhum desenho de estrela vai salvar o resultado.
Decisão 1: o que a tabela fato registra? Medidas numéricas (valor, quantidade) ou apenas a ocorrência de um evento ou relação (um aluno esteve em uma aula)? Esse segundo caso é a Factless Fact Table, uma fato sem medidas numéricas.
Decisão 2: como as dimensões são organizadas? Desnormalizadas, em uma tabela larga por dimensão (Star Schema), ou normalizadas, divididas em várias tabelas (Snowflake Schema)?
Como as perguntas são independentes, uma fato factless pode participar de um esquema estrela ou de um esquema com dimensões normalizadas. Vamos ensinar nessa ordem.
Parte 1: conheça as três abordagens
Explore as três abordagens
Clique em cada abordagem para ver o diagrama, a ideia central e quando considerá-la. Objetivo: explorar as três.
Selecione uma abordagem acima para ver os detalhes.
0 de 3 abordagens exploradas.
Repare que o Star Schema e o Snowflake descrevem a organização das dimensões e podem compartilhar exatamente a mesma tabela fato. Já a Factless Fact Table descreve a natureza da fato: ela registra que algo aconteceu, sem nenhum valor para somar, e pode combinar com qualquer um dos dois esquemas.
Parte 2: fato, dimensão ou medida?
Antes de escolher entre modelos, é preciso saber ler cada peça. Imagine a pergunta de negócio: "Quanto vendemos por produto, loja e mês?". Classifique cada elemento do modelo que responde a ela.
Fato, dimensão ou medida?
Classifique cada elemento. A explicação aparece logo após cada resposta.
fato_vendas, com uma linha para cada item vendido.
É a tabela fato: registra o evento de negócio (a venda) no nível de detalhe definido pelo grão e fica no centro do modelo.
dim_produto, com nome, categoria e marca.
É uma dimensão: descreve o contexto do evento, respondendo 'o que foi vendido?'.
O valor da venda (coluna valor).
É uma medida: um valor numérico que fica na tabela fato e pode ser somado, média, contado.
dim_tempo, com data, mês e ano.
É uma dimensão: responde 'quando?'. Praticamente todo modelo dimensional tem uma dimensão de tempo.
A quantidade de itens vendidos.
É uma medida: valor numérico aditivo que vive na tabela fato.
dim_loja, com nome e estado.
É uma dimensão: responde 'onde?', dando contexto para filtrar e agrupar a medida.
0 de 6 respondidos.
Parte 3: duas decisões, duas perguntas
Agora o treino fica mais parecido com o trabalho real. O infográfico traz regras de bolso: Star Schema como padrão, Snowflake quando a dimensão for muito grande e Factless para evento sem medida numérica. São bons pontos de partida, mas lembre-se de que respondem a perguntas diferentes: primeiro, o que a fato registra?; depois, como organizar as dimensões?. Em cada cenário abaixo, repare qual das duas decisões está em jogo.
Qual decisão você está tomando?
Cada cenário trata da fato (o que ela registra) ou das dimensões (como se organizam). Escolha a melhor resposta.
A fato: faturamento por produto, loja e mês. A tabela precisa guardar valor e quantidade vendida.
Valor e quantidade são medidas numéricas somáveis: é uma fato comum, com medidas.
A fato: registrar a presença de alunos em aulas. Não há valor numérico para somar.
O evento (o aluno esteve na aula) é o fato. Sem medida numérica, é uma Factless Fact Table.
A fato: registrar em quais campanhas cada usuário clicou, sem nenhum valor associado ao clique.
Clique em campanha é um evento sem medida numérica, exemplo típico de factless.
A fato: registrar quais produtos estavam disponíveis em cada loja em cada dia, mesmo sem vendas.
Disponibilidade registra uma possibilidade, não um valor. É uma factless de cobertura.
As dimensões: uma equipe de BI nova quer simplicidade, manutenção fácil e dimensões de tamanho normal.
Sem motivo forte para normalizar, o ponto de partida é a dimensão desnormalizada: mais simples de entender e de manter.
As dimensões: o catálogo de produtos é enorme, com milhares de atributos e hierarquias complexas, e a redundância está pesando.
Dimensão muito grande é um motivo para avaliar a normalização, não uma decisão automática. Normalizar reduz redundância, mas acrescenta tabelas e complexidade, e dependendo da ferramenta pode até aumentar o tamanho do modelo. Meça antes de decidir.
Uma factless de presença em aula, com a dimensão de disciplina pequena, pode usar qual organização de dimensões?
As decisões são independentes: a factless define o que a fato registra; Star ou Snowflake define como as dimensões são organizadas. Ela pode participar de qualquer um dos esquemas.
0 de 7 respondidos.
Parte 4: compare a estrutura das consultas
Teoria é uma coisa; escrever a consulta é outra. No comparador abaixo, execute os três exemplos e observe o SQL que cada um exige. Para vendas por categoria, marca, cidade e mês, o exemplo estrela usa 3 joins e o exemplo snowflake usa 5. Esses números são exemplos, não características universais: o número de joins depende do desenho do modelo e da pergunta feita.
Importante: esta atividade compara a estrutura das consultas (quantas tabelas entram e como elas se ligam). Ela não executa benchmarks, e contar joins, sozinho, não mede desempenho. O impacto real depende do volume de dados, dos índices, do otimizador e do motor que você usa; para decidir, meça no seu ambiente.
Comparador de estrutura das consultas
Execute os três exemplos para comparar o SQL, o número de tabelas envolvidas e o trade-off de cada desenho. Nenhum deles mede tempo de execução.
0 de 3 exemplos executados. Rode todos para comparar.
O comparativo do infográfico, em tabela. Leia como tendências e pontos de partida, não como garantias:
| Aspecto | Star Schema | Snowflake Schema | Factless Fact Table |
|---|---|---|---|
| O que descreve | Organização das dimensões (desnormalizadas) | Organização das dimensões (normalizadas) | Natureza da fato (sem medidas numéricas); combina com os dois esquemas |
| Joins (exemplos típicos) | Tende a ser menor (ex.: 3 a 5) | Tende a ser maior (ex.: 5+) | Depende do esquema de dimensões adotado |
| Tamanho da dimensão | Maior (desnormalizada, com redundância) | Menor em redundância (normalizada), mas com mais tabelas | Depende do esquema de dimensões |
| Complexidade | Baixa | Maior | Baixa a moderada |
| Desempenho | Costuma ser bom; confirme medindo | Depende do volume, dos índices e do motor; meça | Depende do volume e da consulta; meça |
| Quando considerar | Ponto de partida na maioria dos casos | Quando o ganho compensar a complexidade, por exemplo em dimensões muito grandes ou com hierarquias complexas | Evento ou relação sem medida numérica |
| Exemplos | Vendas, faturamento, pedidos | Catálogo de produtos muito grande, hierarquias complexas | Presença em aula, produto disponível, clique em campanha |
Parte 5: diagnostique erros comuns
O erro mais frequente em Data Warehouse não é técnico, é de hábito: normalizar dimensão por reflexo de quem vem de OLTP. Em sistemas transacionais, eliminar redundância protege a integridade dos dados. Em um Data Warehouse, o objetivo é outro: responder perguntas de negócio com simplicidade e boa performance. Nos casos abaixo, aponte o problema que você enxerga.
Diagnostique o modelo
Cada caso descreve um sintoma. Escolha a causa mais provável.
Todas as dimensões foram normalizadas 'por reflexo' de quem vem de OLTP, inclusive as pequenas, e agora cada consulta junta muitas tabelas sem nenhum ganho visível.
É o erro comum do infográfico: normalizar por hábito de OLTP. Em Data Warehouse o objetivo não é eliminar redundância a qualquer custo, e sim responder perguntas de negócio com simplicidade e boa performance. Normalizar só vale quando traz um benefício que justifique a complexidade.
A fato_presenca tem grão 'um aluno, em uma aula, em uma data', mas a mesma presença foi inserida duas vezes, e as contagens saem infladas.
O problema é a duplicidade: o grão define uma linha por presença, e cada ocorrência deve existir uma única vez. Observação: uma coluna constante presente = 1 somada com SUM aparece em algumas documentações de factless; é redundante com a contagem de linhas, mas não é, por si só, um erro de modelagem.
A tabela fato mistura linhas por pedido e linhas por item de pedido, e os totais saem duplicados.
Problema de grão. Cada tabela fato deve ter um único nível de detalhe, definido antes de modelar (veja o post sobre grão da tabela fato).
O time quer saber quais produtos estavam disponíveis em cada dia e não venderam, mas só guarda vendas: dias sem venda 'somem'.
Vendas só registram o que aconteceu. A tabela de cobertura registra as possibilidades (produto disponível na loja, no dia). Para descobrir o que estava disponível e não vendeu, é preciso comparar a cobertura com a atividade efetivamente registrada, como no exemplo de SQL abaixo.
0 de 4 respondidos.
O que não aconteceu: cobertura x atividade
Há dois usos clássicos de factless: registrar eventos (presença, clique, agendamento) e registrar cobertura (o que estava disponível ou elegível, por exemplo produtos em promoção em cada loja e dia). A tabela de cobertura sozinha mostra as possibilidades. Para achar o que estava disponível e não aconteceu, compare-a com a tabela de atividade, por exemplo com um LEFT JOIN e um filtro para as linhas sem correspondência:
SELECT c.id_produto, c.id_loja, c.id_tempo
FROM fato_cobertura c
LEFT JOIN fato_vendas v
  ON  v.id_produto = c.id_produto
  AND v.id_loja    = c.id_loja
  AND v.id_tempo   = c.id_tempo
WHERE v.id_produto IS NULL;
O resultado lista os produtos que estavam disponíveis, em cada loja e dia, mas não tiveram venda registrada.
Resumindo o treino
As três abordagens servem à mesma pergunta de fundo: como organizar os dados para que o negócio consiga fazer perguntas e obter respostas? Mas elas não são alternativas entre si: duas descrevem as dimensões e uma descreve a fato.
- Star Schema: organização de dimensões desnormalizadas, ponto de partida na maioria dos casos. Simples e fácil de manter.
- Snowflake Schema: organização de dimensões normalizadas. Vale avaliar quando a dimensão é muito grande ou tem hierarquias complexas, pesando redundância, volume e complexidade; meça antes de decidir.
- Factless Fact Table: um tipo de tabela fato, sem medidas numéricas, para eventos e coberturas (presença, disponibilidade, clique, agendamento). Pode participar de um esquema estrela ou snowflake.
Em resumo: responda duas perguntas, nesta ordem. A fato registra medidas ou só ocorrências? As dimensões ficam desnormalizadas ou serão normalizadas? Comece pelo mais simples, normalize quando houver motivo claro e medido, e lembre-se do lema que fecha o infográfico: menos teoria, mais dados no mundo real.
Resultado do treino
Bloqueado
Conclua as cinco missões para desbloquear seu rank e ver sua pontuação final.
Teste seu conhecimento
Rodada final de revisão: responda e corrija tudo de uma vez.
1. Qual organização de dimensões costuma ser o ponto de partida na maioria dos casos de Data Warehouse?
Resposta correta: A) Star Schema
Star Schema é o padrão: simples, direto e eficiente.
2. Em que situação vale avaliar o Snowflake Schema?
Resposta correta: C) Quando a dimensão é muito grande ou tem hierarquias complexas e o ganho compensa a complexidade extra, depois de avaliar
Dimensão grande é um motivo para avaliar, não uma decisão automática: normalizar acrescenta tabelas e complexidade, e o benefício depende do caso.
3. O que caracteriza uma Factless Fact Table?
Resposta correta: B) Ela registra a ocorrência de um evento sem medidas numéricas
A própria existência da linha é a informação, como presença em aula ou clique em campanha.
4. Qual é o erro comum apontado no infográfico?
Resposta correta: D) Normalizar dimensão por reflexo de quem vem de OLTP
O objetivo do DW não é eliminar redundância a qualquer custo, e sim responder perguntas de negócio com simplicidade e performance.
5. Na consulta de exemplo do artigo (vendas por categoria, marca, cidade e mês), qual desenho envolve mais tabelas?
Resposta correta: B) Snowflake Schema
Neste exemplo, categoria e marca em tabelas próprias exigem mais joins. Mas o número de joins depende do desenho e da pergunta e, sozinho, não mede desempenho.
6. Qual afirmação descreve corretamente a relação entre Star, Snowflake e Factless?
Resposta correta: C) Star e Snowflake descrevem a organização das dimensões; Factless descreve uma fato sem medidas e pode combinar com ambos
São duas decisões independentes: o que a fato registra e como as dimensões são organizadas.