Pandas ou PySpark?
As duas ferramentas são fundamentais no ecossistema de dados, mas cada uma resolve problemas diferentes.
10/06/2026 Engenharia de Dados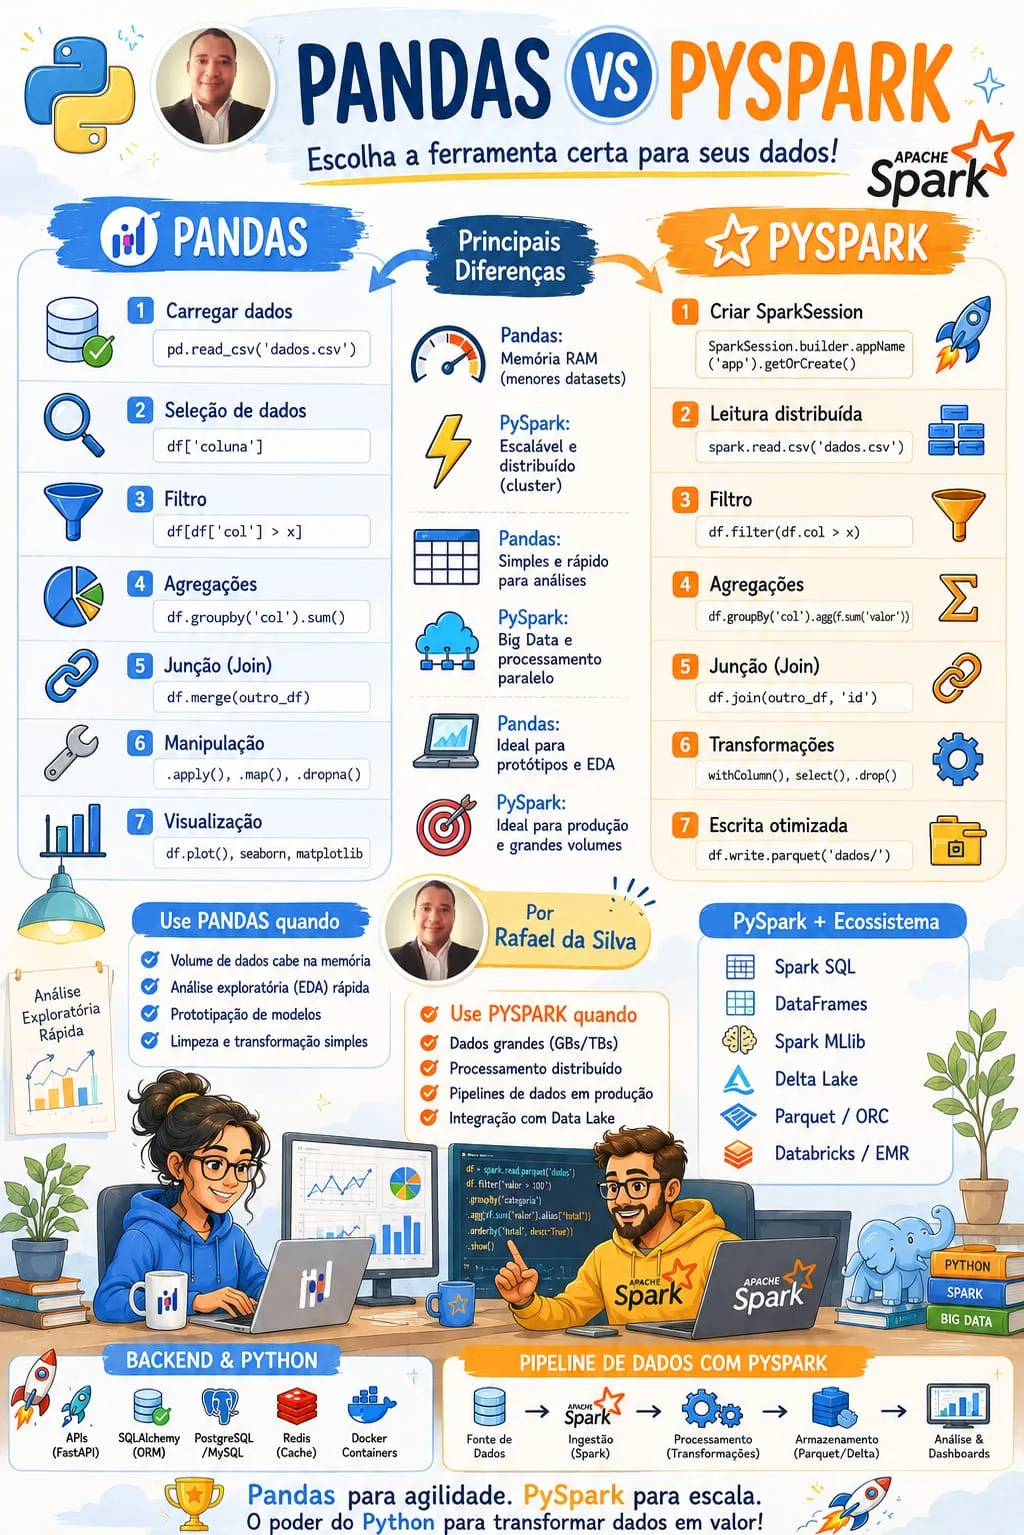
Pandas ou PySpark?
Muita gente aprende Pandas primeiro.
E, durante um bom tempo, ele resolve praticamente tudo.
Mas existe um momento em que a ferramenta que acelerava seu trabalho passa a ser justamente o que limita sua evolução.
É aí que entra o PySpark.
Quando comecei a trabalhar com processamento de dados, o Pandas era minha escolha padrão.
Simples. Produtivo. Poucas linhas de código para gerar muito resultado.
Exemplo:
df = pd.read_csv('dados.csv')

df.groupby('categoria').sum()
Para análises exploratórias, limpeza de dados e protótipos rápidos, é difícil encontrar algo tão eficiente.
Mas existe uma condição:
Os dados precisam caber na memória.
E nem sempre isso acontece.
Onde o Pandas brilha
Análises exploratórias (EDA)
Limpeza e transformação de dados
Desenvolvimento rápido
Prototipação de modelos
Bases pequenas e médias
Se o objetivo é ganhar velocidade e obter insights rapidamente, Pandas continua sendo uma das melhores ferramentas do ecossistema Python.
Quando o PySpark se torna necessário
À medida que os dados crescem, surgem os sintomas conhecidos:
Notebook travando
Memória RAM no limite
Processamentos demorados
Dificuldade para escalar
Nesse cenário, não basta otimizar código.
É preciso mudar a estratégia.
O PySpark foi criado exatamente para isso.
spark.read.csv("dados.csv")Em vez de processar tudo em uma única máquina, ele distribui a carga entre vários nós do cluster.
O resultado?
Mais escala. Mais performance. Mais capacidade de crescimento.
A principal diferença
Pandas
Processamento local
Tudo em memória RAM
Simples e produtivo
Ideal para análises e exploração
PySpark
Processamento distribuído
Escala para bilhões de registros
Preparado para produção
Ideal para pipelines de dados
O erro que vejo com frequência
Alguns profissionais insistem em usar Pandas quando os dados já cresceram além do razoável.
Outros fazem o contrário: implementam Spark para processar arquivos pequenos.
Nos dois casos existe desperdício.
A melhor ferramenta não é a mais poderosa.
É a mais adequada para o problema.
Minha regra prática
Use Pandas quando:
Os dados cabem confortavelmente na memória
Você está explorando informações
Precisa de rapidez no desenvolvimento
Use PySpark quando:
O volume começa a crescer significativamente
Há necessidade de processamento distribuído
Existem pipelines em produção
Escalabilidade é requisito
O mercado não procura especialistas em ferramentas.
Procura profissionais que sabem tomar decisões.
Saber quando usar Pandas, quando migrar para Spark, como construir pipelines escaláveis e transformar dados em produtos vale mais do que dominar apenas uma tecnologia.
Stack cada vez mais presente no mercado
Python
SQL
Pandas
PySpark
Docker
Data Lakes
Databricks
Cloud
Essa combinação aparece constantemente em projetos de Engenharia de Dados, Analytics, Inteligência Artificial, Backend Moderno e Plataformas de Dados.
Conclusão
Pandas entrega velocidade.
PySpark entrega escala.
Os dois são fundamentais.
O diferencial está em saber quando utilizar cada um.
E você?
Qual foi o maior volume de dados que já processou usando Pandas antes de migrar para Spark?
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Qual é a principal condição para usar o Pandas com eficiência, segundo o artigo?
Resposta correta: B) Os dados precisam caber na memória
O artigo destaca que o Pandas processa tudo localmente e em memória RAM, o que funciona bem enquanto os dados cabem confortavelmente nesse espaço.
2. Um analista percebe que seu notebook está travando, a memória RAM está no limite e os processamentos ficam cada vez mais demorados ao trabalhar com Pandas. Segundo o artigo, qual é a atitude mais adequada nesse cenário?
Resposta correta: C) Migrar para o PySpark, que distribui a carga entre vários nós do cluster
O artigo explica que, diante desses sintomas, não basta otimizar código: é preciso mudar de estratégia e usar o PySpark, criado justamente para processar dados em escala.
3. De acordo com o artigo, qual é a principal diferença entre Pandas e PySpark?
Resposta correta: A) Pandas processa localmente e em memória; PySpark distribui o processamento entre vários nós
O artigo resume essa diferença diretamente: Pandas é processamento local em memória RAM, enquanto PySpark é processamento distribuído, preparado para escalar.
4. Qual "erro comum" o autor destaca no artigo em relação ao uso dessas ferramentas?
Resposta correta: B) Usar Pandas quando os dados já cresceram além do razoável, ou usar Spark para processar arquivos pequenos
O artigo afirma que, nos dois casos, existe desperdício: a melhor ferramenta não é a mais poderosa, é a mais adequada para o problema.
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Pandas ou PySpark?