Pgpool-II: o load balancer que conecta sua aplicação ao PostgreSQL
Entenda como o Pgpool-II atua como intermediário entre sua aplicação e o PostgreSQL, distribuindo conexões entre nó primário e réplicas para ganhar performance, disponibilidade e escalabilidade.
24/09/2026 Bancos de Dados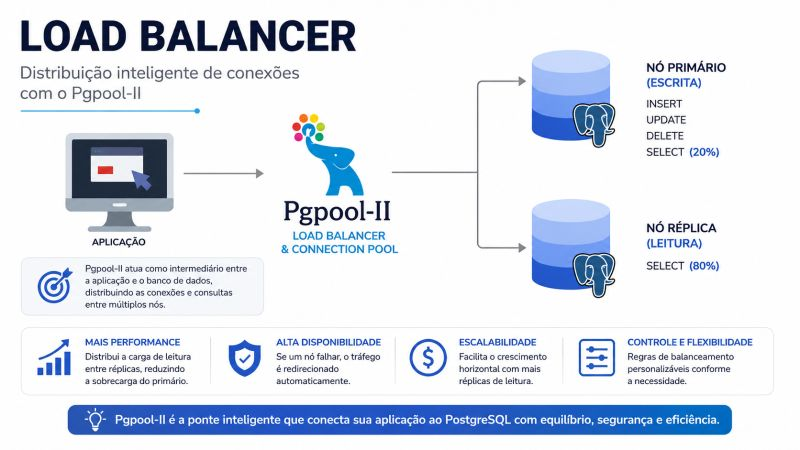
Imagine uma aplicação que cresceu rápido: o número de usuários aumentou, as consultas ao banco se multiplicaram e, de repente, um único servidor PostgreSQL passa a receber toda a carga — leituras e escritas, ao mesmo tempo, sem distinção.
É nesse ponto que muitas equipes descobrem o Pgpool-II: um middleware que fica entre a aplicação e o PostgreSQL, funcionando como uma espécie de "recepcionista inteligente" que decide para qual servidor cada conexão deve ser encaminhada.
O que é o Pgpool-II?
Pgpool-II é um proxy de banco de dados criado especificamente para o PostgreSQL. Ele não substitui o banco — ele fica na frente dele, recebendo as conexões da aplicação antes que elas cheguem até o PostgreSQL.
Do ponto de vista da aplicação, nada muda: ela continua se conectando normalmente, usando o mesmo driver e a mesma string de conexão. A diferença é que, por trás dos panos, o Pgpool-II decide qual servidor vai processar cada consulta.
Connection pooling: reaproveitando conexões
Abrir e fechar uma conexão com o banco de dados não é uma operação gratuita. Ela envolve handshake de rede, autenticação e alocação de recursos no servidor.
Em aplicações com muitas requisições simultâneas, abrir uma conexão nova a cada requisição pode se tornar um gargalo sério. O Pgpool-II resolve isso mantendo um pool de conexões já estabelecidas com o PostgreSQL e as reaproveitando entre as requisições, em vez de criar e destruir conexões o tempo todo.
Load balancing: separando leitura de escrita
Esse é o ponto central do Pgpool-II. Em uma arquitetura com
replicação — um nó primário e uma ou mais réplicas —
a maior parte do tráfego de um sistema típico costuma ser de leitura
(SELECT), enquanto escritas (INSERT,
UPDATE, DELETE) representam uma fatia menor.
O Pgpool-II identifica automaticamente o tipo de consulta e roteia:
- Escritas sempre vão para o nó primário, que é o único autorizado a alterar dados.
- Leituras são distribuídas entre o primário e as réplicas, de acordo com pesos configuráveis.
Com isso, o nó primário deixa de ser sobrecarregado por consultas de leitura que poderiam perfeitamente ser respondidas por uma réplica.
Exemplo prático: uma loja virtual
Para tornar isso mais concreto, imagine uma loja virtual com dois tipos de operação:
- A página de catálogo, que gera milhares de
SELECTpor minuto para listar produtos, preços e estoque. - O checkout, que gera um volume bem menor de
INSERTeUPDATEao confirmar pedidos.
Sem Pgpool-II, tanto o catálogo quanto o checkout se conectam diretamente ao nó primário. Resultado: o primário processa 100% da carga, mesmo que a maior parte sejam simples consultas de leitura que qualquer réplica poderia responder.
Com Pgpool-II, basta configurar os nós no arquivo
pgpool.conf, definindo pesos (backend_weight)
para cada servidor:
backend_hostname0 = 'db-primary'
backend_port0 = 5432
backend_weight0 = 1
backend_flag0 = 'ALWAYS_PRIMARY'

backend_hostname1 = 'db-replica1'
backend_port1 = 5432
backend_weight1 = 4
backend_flag1 = 'DISALLOW_TO_FAILOVER'

load_balance_mode = on
Nesse exemplo, o peso 1 no primário contra 4
na réplica faz com que, aproximadamente, 80% das leituras
sejam direcionadas para a réplica e apenas 20% permaneçam no
primário — enquanto todas as escritas continuam indo
exclusivamente para o nó marcado como ALWAYS_PRIMARY.
O resultado prático: a página de catálogo passa a ser respondida, em sua maioria, pela réplica, liberando o primário para focar no que realmente precisa de consistência forte — os pedidos do checkout.
Alta disponibilidade
Além de balancear carga, o Pgpool-II monitora continuamente a saúde dos nós configurados. Se o nó primário falhar, ele pode disparar um processo de failover, redirecionando o tráfego para um nó saudável e evitando que a aplicação fique fora do ar.
Escalabilidade horizontal
Como o volume de leitura cresce, adicionar mais réplicas é uma forma natural de escalar horizontalmente. Cada nova réplica registrada no Pgpool-II passa a receber uma fatia do tráfego de leitura, sem que a aplicação precise saber quantos servidores existem por trás dele.
Pgpool-II não é mágica
Vale destacar alguns pontos importantes antes de adotar o Pgpool-II em produção:
- Ele depende de uma replicação em streaming já configurada e funcionando entre o primário e as réplicas.
- Réplicas de leitura normalmente têm replicação assíncrona, então podem ficar alguns milissegundos "atrasadas" em relação ao primário.
- Para operações que exigem ler exatamente o dado que acabou de ser escrito, pode ser necessário forçar a leitura no primário.
- O próprio Pgpool-II se torna um componente crítico da infraestrutura, então costuma ser executado em alta disponibilidade também.
Resumindo
| Recurso | O que o Pgpool-II faz |
|---|---|
| Connection pooling | Reaproveita conexões já abertas com o PostgreSQL |
| Load balancing | Distribui leituras entre primário e réplicas |
| Separação leitura/escrita | Envia escritas apenas para o nó primário |
| Alta disponibilidade | Monitora os nós e pode disparar failover |
| Escalabilidade | Facilita adicionar novas réplicas de leitura |
Em resumo, o Pgpool-II funciona como uma ponte inteligente entre a aplicação e o PostgreSQL: sem exigir mudanças no código, ele distribui as conexões de forma equilibrada, aproveita melhor a infraestrutura que já existe e ajuda o banco de dados a continuar respondendo bem mesmo quando o sistema cresce.
E você?
Sua aplicação já separa leituras de escritas entre nós diferentes,
ou tudo ainda passa por um único servidor de banco de dados?
Saiba mais:
Documentação oficial do Pgpool-II: https://www.pgpool.net/docs/latest/en/html/
PostgreSQL - Replicação em streaming: https://www.postgresql.org/docs/current/warm-standby.html#STREAMING-REPLICATION
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que é o Pgpool-II, segundo o artigo?
Resposta correta: B) Um middleware/proxy que fica entre a aplicação e o PostgreSQL, distribuindo as conexões.
O artigo descreve o Pgpool-II como um proxy que recebe as conexões da aplicação antes que elas cheguem ao PostgreSQL, decidindo para qual servidor encaminhá-las.
2. No exemplo da loja virtual, para onde o Pgpool-II direciona as consultas de escrita (INSERT/UPDATE) do checkout?
Resposta correta: C) Sempre para o nó primário, marcado como ALWAYS_PRIMARY.
Apenas o nó primário pode processar escritas; réplicas recebem somente leituras, conforme mostrado no exemplo de configuração do pgpool.conf.
3. No exemplo de configuração do artigo, backend_weight0 = 1 (primário) e backend_weight1 = 4 (réplica). O que isso representa?
Resposta correta: A) A proporção de leituras que cada nó deve receber (aproximadamente 20% no primário e 80% na réplica).
O artigo explica que os pesos configuram a distribuição do tráfego de leitura entre os nós, sem afetar as escritas, que sempre vão para o primário.
4. Segundo o artigo, o que é importante ter em mente antes de adotar o Pgpool-II em produção?
Resposta correta: B) Ele depende de replicação em streaming já configurada, e as réplicas podem ficar levemente atrasadas em relação ao primário.
O artigo destaca que o Pgpool-II não é mágica: ele pressupõe replicação assíncrona funcionando, o que pode gerar pequenas defasagens entre primário e réplicas.