Domando o Oceano de Dados: Big Data e Gestão Inteligente
Volume não é sinônimo de valor. Entenda os 4 pilares do Big Data, a diferença entre inventário e mapeamento de dados e como uma arquitetura em camadas transforma dados dispersos em inteligência.
29/09/2026 Engenharia de Dados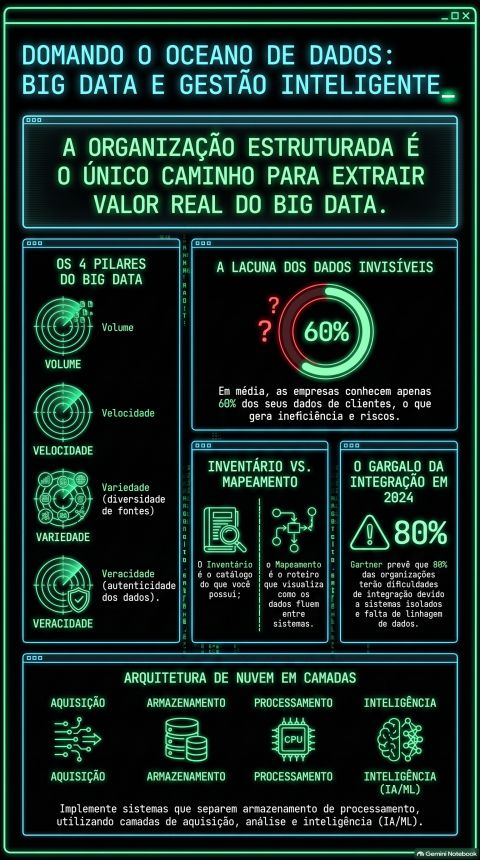
Toda empresa hoje gera dados em uma quantidade que seria impensável alguns anos atrás. Sistemas transacionais, aplicativos, sensores, redes sociais, logs — é um verdadeiro oceano. O problema é que ter muitos dados não significa, por si só, ter valor. Sem organização, esse oceano vira um lugar onde é fácil se perder.
A ideia central deste artigo é simples: a organização estruturada é o único caminho para extrair valor real do Big Data. Vamos ver por quê.
Os 4 pilares do Big Data
Big Data costuma ser descrito a partir de quatro características, os chamados 4 Vs:
- Volume: a quantidade de dados gerada e armazenada, que hoje facilmente chega a terabytes e petabytes.
- Velocidade: o ritmo com que os dados são gerados e precisam ser processados, muitas vezes em tempo real.
- Variedade: a diversidade de fontes e formatos — tabelas, JSON, logs, imagens, áudio, texto livre.
- Veracidade: a autenticidade e a confiabilidade dos dados. Dado em grande volume, mas errado, só acelera decisões ruins.
Repare que os três primeiros pilares falam de escala, enquanto o quarto fala de confiança. É justamente a veracidade que costuma ser esquecida — e é ela que determina se o dado serve para alguma coisa.
A lacuna dos dados invisíveis
Um dos problemas mais comuns nas empresas não é a falta de dados, e sim a falta de visibilidade sobre eles. O infográfico traz um número que ilustra bem isso: em média, as empresas conhecem apenas cerca de 60% dos seus dados de clientes.
Os outros 40% estão espalhados em planilhas, sistemas legados, cópias esquecidas e integrações que ninguém documentou. Isso gera ineficiência (retrabalho, dados duplicados, relatórios que não batem) e riscos (vazamentos, descumprimento da LGPD, decisões baseadas em informação incompleta).
Inventário vs. Mapeamento
Para fechar essa lacuna, dois conceitos andam juntos, mas são diferentes:
- Inventário é o catálogo do que você possui: quais bases existem, quais tabelas, quais campos, quem é o responsável por cada uma.
- Mapeamento é o roteiro que mostra como os dados fluem entre sistemas: de onde vêm, por quais transformações passam e para onde vão.
Uma forma prática de pensar: o inventário responde "o que eu tenho?", e o mapeamento responde "por onde isso passa?". Ter só o inventário é como ter a lista de cidades sem o mapa das estradas. Ter só o mapeamento é saber das estradas sem saber o que existe em cada cidade. Os dois juntos formam a base da governança de dados — e é o mapeamento que dá origem à linhagem de dados (data lineage).
O gargalo da integração
Quando não existe inventário nem mapeamento, o sintoma aparece na hora de integrar. Uma previsão do Gartner, destacada no infográfico, apontava que 80% das organizações teriam dificuldades de integração em 2024 por causa de sistemas isolados e da falta de linhagem de dados.
Na prática, isso significa times gastando mais tempo tentando entender de onde vem um número do que efetivamente analisando esse número. Cada nova integração vira um projeto de arqueologia.
Arquitetura de nuvem em camadas
A resposta técnica para esse cenário é organizar a arquitetura em camadas, cada uma com uma responsabilidade clara:
- Aquisição: coleta e ingestão dos dados das diversas fontes, em lote ou em streaming.
- Armazenamento: onde os dados ficam guardados, como um Data Lake ou um Lakehouse, de forma escalável e barata.
- Processamento: limpeza, transformação, enriquecimento e agregação dos dados, normalmente de forma distribuída.
- Inteligência (IA/ML): a camada que consome os dados tratados para gerar análises, dashboards e modelos de machine learning.
Um princípio importante dessa arquitetura é separar armazenamento de processamento. Quando os dois estão acoplados, escalar um obriga a escalar o outro — e pagar por isso. Separados, você guarda muito dado a baixo custo e liga o poder de processamento apenas quando precisa, escalando cada camada de forma independente.
Resumindo
Big Data não é sobre acumular dados, é sobre organizá-los. Os 4 Vs descrevem o desafio; o inventário e o mapeamento dão visibilidade sobre o que existe e como flui; e a arquitetura em camadas cria a estrutura para transformar esse volume em inteligência.
Sem essa organização, o oceano de dados continua sendo só um oceano. Com ela, vira uma fonte real de valor para o negócio.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Quais são os 4 pilares do Big Data apresentados no artigo?
Resposta correta: C) Volume, velocidade, variedade e veracidade.
O artigo apresenta esses quatro Vs como os pilares do Big Data.
2. Qual a diferença entre inventário e mapeamento de dados?
Resposta correta: A) O inventário é o catálogo do que você possui; o mapeamento mostra como os dados fluem entre sistemas.
O inventário responde "o que eu tenho?", e o mapeamento responde "por onde isso passa?".
3. Segundo o artigo, quais fatores causam o gargalo de integração nas organizações?
Resposta correta: D) Sistemas isolados e falta de linhagem de dados.
O artigo cita a previsão do Gartner que associa as dificuldades de integração a sistemas isolados e à falta de linhagem.
4. Qual a vantagem de separar armazenamento de processamento na arquitetura em camadas?
Resposta correta: B) Escalar cada camada de forma independente, guardando muito dado a baixo custo e usando processamento só quando necessário.
Quando estão acoplados, escalar um obriga a escalar o outro; separados, cada camada cresce conforme a necessidade.