Fluxo do Pipeline de Dados: Da Origem à Análise
Entenda as cinco etapas que levam um dado bruto até virar uma decisão: origem, ingestão, armazenamento, processamento e análise.
28/09/2026 Engenharia de Dados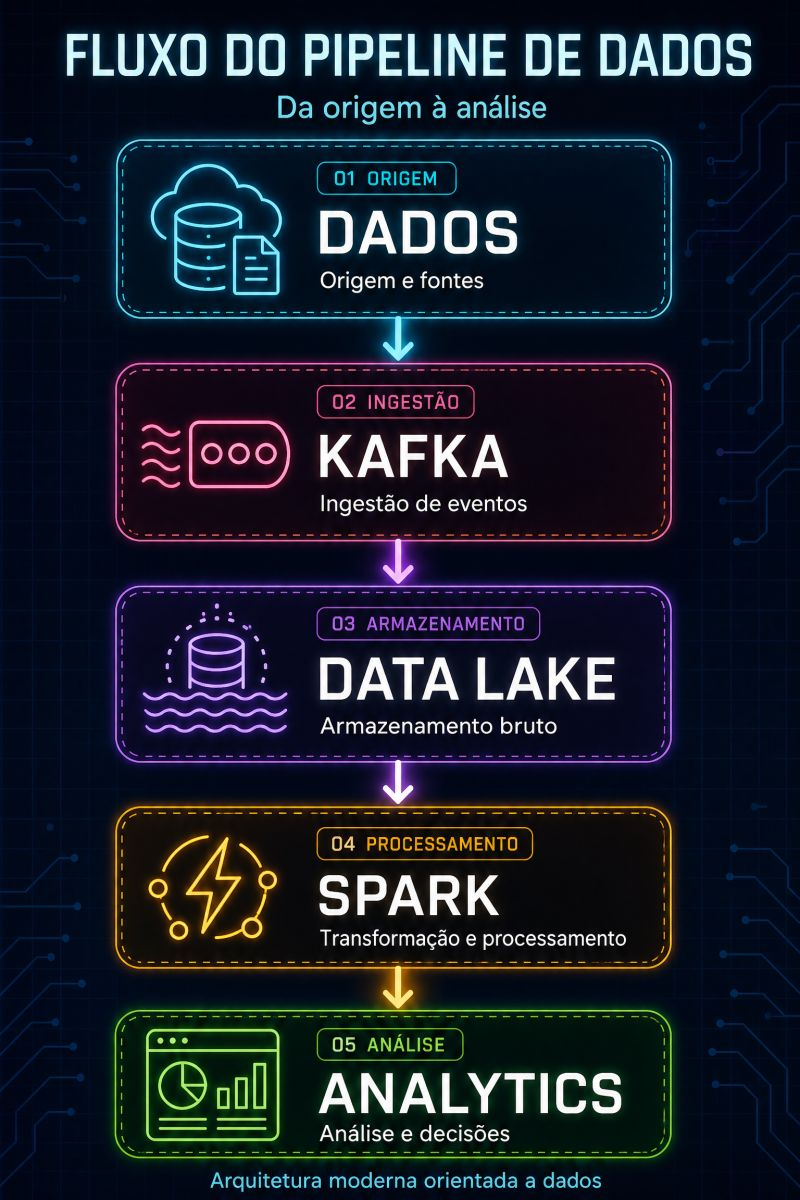
Quando alguém me pergunta o que é, na prática, uma arquitetura de dados moderna, costumo responder com uma imagem: um fluxo. Dado bruto entra em um lado, decisão sai do outro, e no meio existem etapas bem definidas que garantem que esse caminho seja confiável.
Esse fluxo pode ser resumido em cinco etapas: origem, ingestão, armazenamento, processamento e análise. Vamos passar por cada uma delas.
01. Origem: de onde vêm os dados
Todo pipeline começa em algum lugar. A origem é o conjunto de fontes que geram dados: bancos de dados transacionais, aplicações, sensores, arquivos, APIs de terceiros. Nessa etapa, o importante é mapear de onde os dados vêm e com que frequência eles são gerados, porque isso define todo o desenho das etapas seguintes.
02. Ingestão: Kafka
Com as fontes mapeadas, o próximo passo é trazer esses dados para dentro da arquitetura. É aqui que entra a ingestão de eventos, e o Apache Kafka é uma das ferramentas mais usadas para isso.
O Kafka funciona como um grande barramento de mensagens: produtores publicam eventos em tópicos, e consumidores leem esses eventos no seu próprio ritmo. Isso desacopla quem gera o dado de quem processa o dado, e permite lidar com grandes volumes de eventos em tempo real, sem que um sistema lento derrube o outro.
03. Armazenamento: Data Lake
Depois de ingeridos, os dados precisam de um lugar para ficar. Essa é a etapa de armazenamento bruto, normalmente feita em um Data Lake.
Diferente de um banco relacional tradicional, o Data Lake aceita dados em qualquer formato — estruturado, semiestruturado ou não estruturado — sem exigir um esquema definido antes da gravação. Isso dá flexibilidade para guardar tudo primeiro e decidir depois como esse dado será modelado e consumido.
04. Processamento: Spark
Dado armazenado ainda não é dado útil. É preciso transformar esse dado bruto em algo consumível, e é aí que entra o processamento, com ferramentas como o Apache Spark.
O Spark permite processar grandes volumes de dados de forma distribuída, seja em lote (batch) ou em streaming. Nessa etapa acontecem limpeza, enriquecimento, junções entre diferentes fontes e agregações — tudo o que prepara o dado para ser analisado.
05. Análise: Analytics
A última etapa é onde o pipeline entrega valor de fato: a análise. É o momento em que os dados processados alimentam dashboards, relatórios e modelos, e viram decisão para o negócio.
Sem essa etapa final, todo o esforço de ingestão, armazenamento e processamento não tem propósito. É a análise que transforma dado em informação acionável.
Por que pensar em pipeline como fluxo
Enxergar essas cinco etapas como um fluxo contínuo, e não como blocos isolados, muda a forma como você projeta arquiteturas de dados. Cada etapa depende da anterior ter funcionado corretamente, e um problema em qualquer ponto do caminho se propaga para as etapas seguintes.
É por isso que arquiteturas modernas orientadas a dados investem tanto em observabilidade, controle de qualidade e monitoramento em cada uma dessas fases, e não apenas no resultado final.
Resumindo
Origem, ingestão, armazenamento, processamento e análise. Essas cinco etapas formam a espinha dorsal de praticamente qualquer arquitetura de dados moderna, independentemente das ferramentas específicas usadas em cada uma delas.
Entender esse fluxo de ponta a ponta é o que separa quem apenas usa ferramentas isoladas de quem consegue desenhar arquiteturas de dados realmente confiáveis.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Segundo o artigo, quais são as cinco etapas do fluxo de um pipeline de dados?
Resposta correta: B) Origem, ingestão, armazenamento, processamento e análise.
O artigo resume o fluxo do pipeline exatamente nessas cinco etapas.
2. Qual é o papel do Apache Kafka na etapa de ingestão, segundo o artigo?
Resposta correta: C) Funcionar como um barramento de mensagens que desacopla produtores e consumidores de eventos.
O artigo explica que o Kafka funciona como um barramento de mensagens, desacoplando quem gera o dado de quem o processa.
3. O que diferencia um Data Lake de um banco relacional tradicional, segundo o artigo?
Resposta correta: A) O Data Lake aceita dados em qualquer formato, sem exigir um esquema definido antes da gravação.
O artigo destaca essa flexibilidade como a principal diferença em relação a um banco relacional tradicional.
4. Por que a etapa de análise é considerada essencial, segundo o artigo?
Resposta correta: D) Porque é nela que os dados processados viram dashboards, relatórios e decisões para o negócio.
O artigo afirma que sem a etapa de análise, todo o esforço das etapas anteriores não tem propósito.