Apache Kafka + Spark Streaming: como funciona esse fluxo em tempo real?
Entenda como Kafka e Spark Streaming trabalham juntos para processar milhões de eventos em tempo real com escalabilidade.
13/06/2026 Engenharia de Dados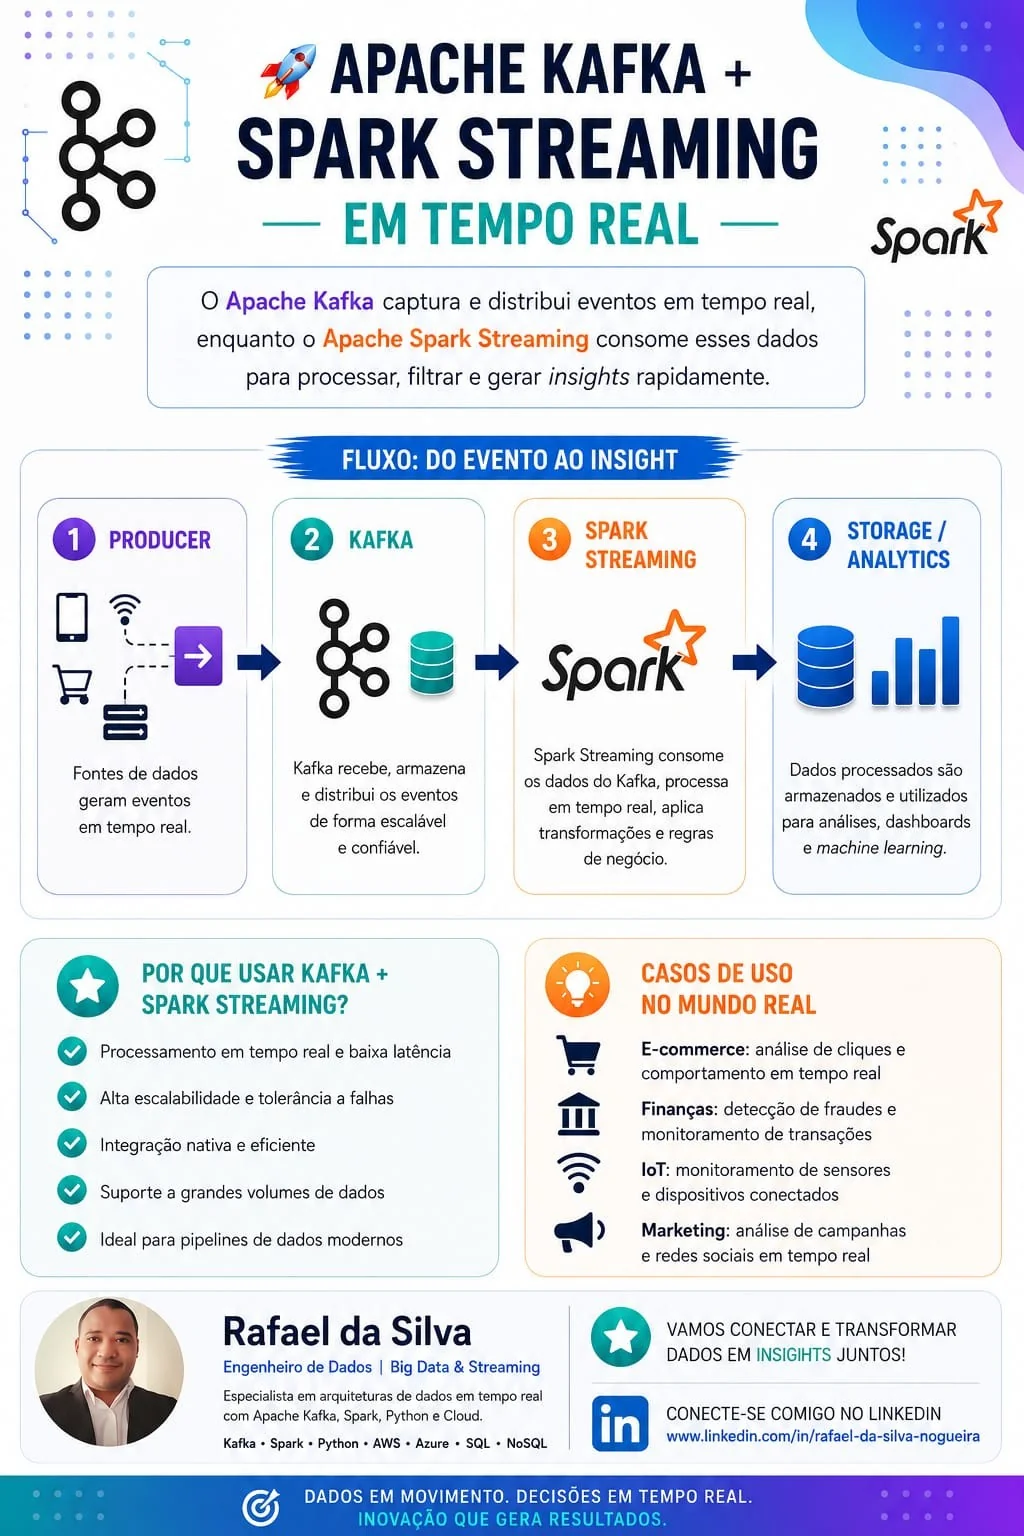
Quando falamos de pipelines de dados em tempo real, duas tecnologias aparecem com muita frequência: Apache Kafka e Apache Spark.
Elas são amplamente utilizadas em arquiteturas modernas de Engenharia de Dados para ingestão, processamento e análise de eventos em escala.
Mas como essas tecnologias trabalham juntas na prática?
A resposta está no fluxo entre produção, ingestão, processamento e armazenamento dos dados.
Fluxo de ponta a ponta
Producers enviam eventos para o Kafka
Tudo começa com aplicações que geram eventos continuamente.
Esses eventos podem vir de:
- Cliques em e-commerce
- Transações bancárias
- Logs de aplicações
- Sensores IoT
Cada evento é enviado para um topic dentro do Kafka.
Pense nos topics como canais especializados para diferentes tipos de dados.
Kafka atua como camada de ingestão distribuída
O Kafka recebe, organiza e persiste essas mensagens em partições.
Essa arquitetura permite:
- Alta escalabilidade
- Tolerância a falhas
- Alta taxa de throughput
- Persistência de eventos
O grande benefício aqui é o desacoplamento entre produtores e consumidores.
Quem gera o dado não precisa conhecer quem irá processá-lo.
Spark Streaming consome eventos em tempo real
Depois, o Spark consome os dados diretamente do Kafka usando micro-batches ou Structured Streaming.
Nesse estágio acontecem transformações como:
- Filtragem
- Enriquecimento
- Join com outras fontes
- Agregações
- Cálculo de métricas
Exemplo em PySpark:
df = (
    spark.readStream
         .format("kafka")
         .option("kafka.bootstrap.servers", "localhost:9092")
         .option("subscribe", "transacoes")
         .load()
)
Processamento distribuído no cluster Spark
O Spark distribui o processamento entre múltiplos executores no cluster.
Isso permite:
- Processar milhões de eventos por segundo
- Reduzir latência
- Escalar horizontalmente
É essa capacidade distribuída que torna o Spark tão poderoso para workloads de streaming.
Dados processados seguem para o destino
Após o processamento, os dados enriquecidos seguem para o destino final (sink).
Alguns destinos comuns:
- Databricks / Data Lake
- PostgreSQL
- Dashboards de BI
- Sistemas de alerta
- APIs
Casos de uso incluem:
- Detecção de fraude em tempo real
- Dashboards live
- Monitoramento de IoT
- Notificações automáticas
Kafka
- Captura eventos
- Transporta mensagens
- Armazena streams
Spark Streaming
- Consome eventos
- Transforma dados
- Gera insights em tempo real
Resumindo o pipeline
Producer → Kafka Topic → Spark Streaming → Processing → Storage / Analytics
O Kafka funciona como o sistema nervoso dos eventos.
O Spark atua como o motor de processamento distribuído.
Juntos, eles formam uma arquitetura extremamente poderosa para aplicações orientadas a eventos.
Essa combinação é uma das bases de pipelines modernos de dados em empresas que precisam operar em tempo real.
Mais do que velocidade, estamos falando de escalabilidade, resiliência e capacidade de gerar insights instantâneos.
E você?
Já trabalhou com pipelines usando Kafka + Spark?
Saiba mais:
Apache Kafka: https://kafka.apache.org/documentation/
Apache Spark Streaming: https://spark.apache.org/streaming/
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Qual é o papel do Apache Kafka no fluxo descrito no artigo?
Resposta correta: B) Capturar, transportar e armazenar eventos, funcionando como camada de ingestão distribuída.
O artigo descreve o Kafka como responsável por receber, organizar e persistir mensagens em partições.
2. Segundo o artigo, qual é o principal benefício de o Kafka desacoplar produtores e consumidores de eventos?
Resposta correta: A) Quem gera o dado não precisa conhecer quem irá processá-lo.
O artigo destaca esse desacoplamento como um dos grandes benefícios da arquitetura com Kafka.
3. Uma empresa quer processar milhões de eventos vindos do Kafka usando micro-batches ou Structured Streaming para gerar insights quase em tempo real. Qual tecnologia, segundo o artigo, é responsável por essa etapa?
Resposta correta: B) Apache Spark Streaming.
O artigo explica que o Spark consome os dados do Kafka usando micro-batches ou Structured Streaming e realiza as transformações.
4. Como o artigo descreve, de forma metafórica, os papéis de Kafka e Spark na arquitetura?
Resposta correta: B) Kafka funciona como o sistema nervoso dos eventos, e Spark atua como o motor de processamento distribuído.
Essa é exatamente a metáfora usada no artigo para resumir o pipeline Kafka + Spark.
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Apache Kafka + Spark Streaming em Tempo Real