RDD no Apache Spark: a base de tudo
Entender RDD é compreender os fundamentos que tornam o Spark tão poderoso para processamento distribuído
11/06/2026 Engenharia de Dados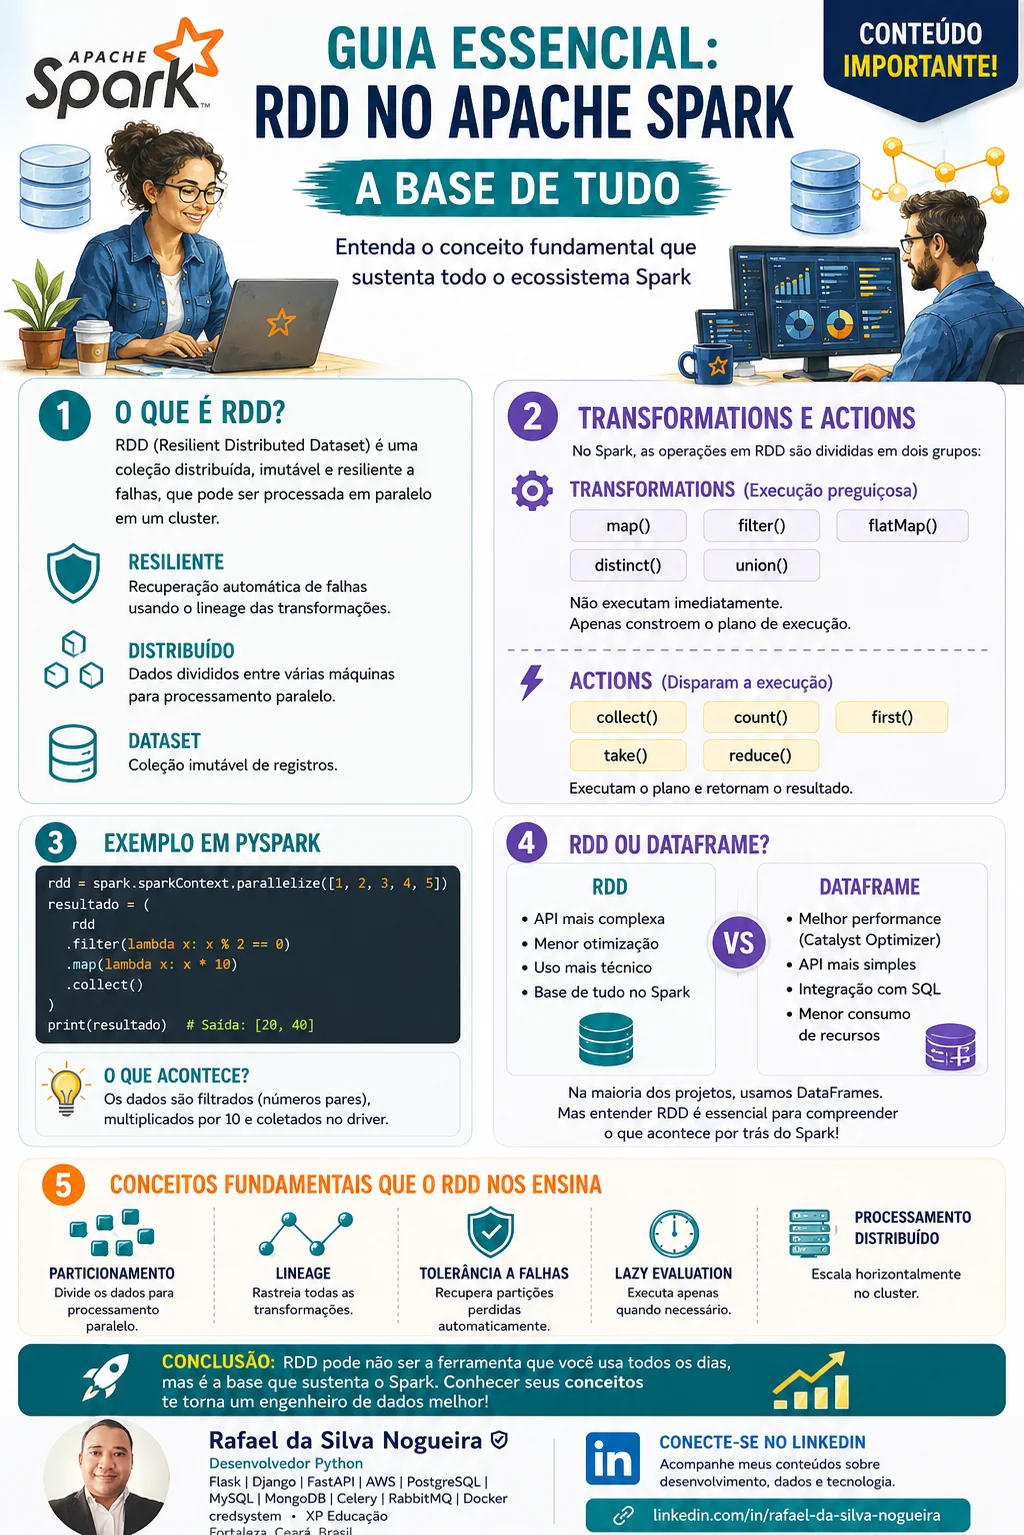
RDD no Apache Spark: a base de tudo.
Quando começamos a estudar Apache Spark, é comum focarmos diretamente em DataFrames, Spark SQL e nas ferramentas utilizadas no dia a dia da Engenharia de Dados.
Mas existe um conceito fundamental por trás de todo o ecossistema Spark: o RDD (Resilient Distributed Dataset).
Ele foi a primeira grande abstração criada pelo Spark e continua sendo uma peça essencial para compreender como o framework funciona internamente.
Mesmo que hoje a maioria dos projetos utilize DataFrames, entender RDD ajuda a compreender conceitos que aparecem constantemente em ambientes distribuídos.
O que é um RDD?
Resilient (Resiliente)
- Recuperação automática em caso de falhas
- Utiliza lineage para reconstrução dos dados
- Maior confiabilidade em ambientes distribuídos
Distributed (Distribuído)
- Dados divididos entre vários nós do cluster
- Processamento paralelo em larga escala
- Melhor aproveitamento dos recursos computacionais
Dataset (Conjunto de Dados)
- Coleção imutável de registros
- Operações realizadas através de transformações
- Base para o processamento distribuído do Spark
O próprio nome já descreve perfeitamente sua proposta: um conjunto de dados distribuído, resiliente e preparado para processamento paralelo.
Por que o RDD foi revolucionário?
Antes do Spark, frameworks como Hadoop MapReduce dependiam fortemente de operações de leitura e escrita em disco.
Isso tornava muitos processos lentos, especialmente quando grandes volumes de dados precisavam passar por múltiplas etapas de transformação.
O Spark mudou esse cenário ao introduzir processamento em memória, permitindo que os dados permanecessem disponíveis durante toda a execução.
E os RDDs foram a primeira abstração responsável por viabilizar essa mudança.
Transformations e Actions
Um dos conceitos mais importantes do Spark é a separação entre Transformations e Actions.
Transformations
- map()
- filter()
- flatMap()
- distinct()
- union()
Característica principal
- Lazy Execution
- Não executam imediatamente
- Apenas constroem o plano de execução
Actions
- collect()
- count()
- first()
- take()
- reduce()
Somente quando uma Action é executada o Spark dispara o processamento no cluster.
Esse comportamento é conhecido como Lazy Evaluation e é um dos fatores que contribuem para a eficiência do Spark.
RDD ou DataFrame?
Atualmente, a maioria dos projetos utiliza DataFrames devido às otimizações oferecidas pelo Catalyst Optimizer.
Vantagens dos DataFrames
- Melhor performance
- API mais amigável
- Integração com Spark SQL
- Menor consumo de recursos
- Otimizações automáticas
Por que aprender RDD?
- Entender particionamento
- Compreender lineage
- Aprender tolerância a falhas
- Dominar Lazy Evaluation
- Entender processamento distribuído
Embora DataFrames sejam a escolha natural para a maioria dos cenários modernos, o conhecimento sobre RDD continua extremamente valioso.
Afinal, muitos dos conceitos fundamentais do Spark nasceram justamente nessa camada mais baixa de abstração.
Uma lição que aprendi estudando Spark
"Você pode trabalhar diariamente com DataFrames, mas entender RDD é o que permite compreender o que realmente acontece por trás das otimizações do Spark."
É semelhante a aprender ponteiros em C ou entender como o Git funciona internamente.
Talvez você não utilize diretamente todos os dias, mas conhecer os fundamentos ajuda a tomar decisões melhores e a resolver problemas com muito mais confiança.
Para quem trabalha com Engenharia de Dados, compreender RDD significa entender a base sobre a qual o Apache Spark foi construído.
E você?
Já estudou os conceitos de RDD ou utiliza apenas DataFrames no seu dia a dia com Spark?
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que significa a sigla RDD, segundo o artigo?
Resposta correta: B) Resilient Distributed Dataset
O artigo explica cada parte do nome (Resilient, Distributed, Dataset) para mostrar por que essa abstração é resiliente, distribuída e organizada em conjunto de dados.
2. Segundo o artigo, o que diferenciou o Spark do Hadoop MapReduce e tornou o processamento mais rápido?
Resposta correta: A) O uso de processamento em memória, em vez de depender fortemente de leitura e escrita em disco
O artigo conta que o Hadoop MapReduce dependia de disco, o que tornava tudo mais lento, e que o Spark mudou isso com processamento em memória através dos RDDs.
3. Um desenvolvedor escreve várias operações como map() e filter() em um RDD, mas nada é processado até que ele chame count(). Segundo o artigo, qual conceito explica esse comportamento?
Resposta correta: B) Lazy Evaluation
O artigo explica que Transformations como map() e filter() só constroem o plano de execução, e que o Spark só processa de fato quando uma Action, como count(), é chamada.
4. Apesar de a maioria dos projetos atuais usar DataFrames por causa do Catalyst Optimizer, por que o artigo defende que ainda vale a pena aprender RDD?
Resposta correta: B) Porque entender RDD ajuda a compreender particionamento, lineage, tolerância a falhas e processamento distribuído
O artigo compara isso a aprender ponteiros em C: você pode não usar diretamente todo dia, mas entender os fundamentos ajuda a tomar decisões melhores.
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ RDD no Apache Spark: a base de tudo