Connection Pooling: Como o Pgpool-II Reaproveita Conexões com o PostgreSQL
Entenda por que abrir e fechar conexões com o banco de dados a cada requisição é caro, e como o pooling de conexões do Pgpool-II resolve esse problema.
28/09/2026 Bancos de Dados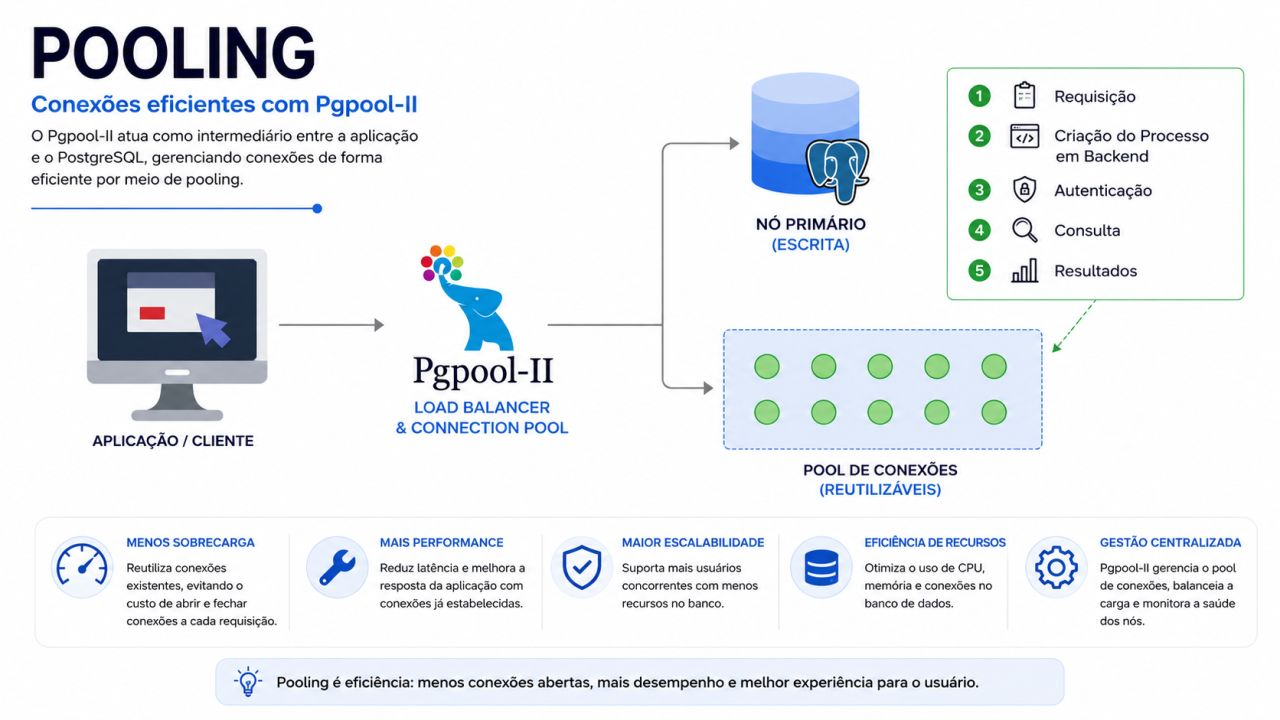
Já falei aqui sobre como o Pgpool-II distribui conexões entre o nó primário e as réplicas do PostgreSQL. Mas existe uma outra peça, tão importante quanto o load balancing, que costuma passar despercebida: o pooling de conexões.
O que é connection pooling?
Connection pooling é a técnica de manter um conjunto de conexões já abertas com o banco de dados e reutilizá-las entre diferentes requisições, em vez de abrir uma conexão nova a cada vez e descartá-la logo em seguida.
O Pgpool-II atua exatamente como esse intermediário: ele fica entre a aplicação e o PostgreSQL, gerenciando esse pool de conexões de forma eficiente.
Por que abrir uma conexão nova é caro
Quando uma aplicação faz uma requisição ao banco sem pooling, o caminho costuma seguir estes passos:
- Requisição — a aplicação pede uma conexão com o banco;
- Criação do processo em backend — o PostgreSQL cria um novo processo para atender essa conexão;
- Autenticação — as credenciais são validadas;
- Consulta — a query é finalmente executada;
- Resultados — os dados voltam para a aplicação.
As etapas 2 e 3 — criar um processo novo no backend e autenticar — são as mais custosas, e elas se repetem a cada nova conexão. Em uma aplicação com muitas requisições simultâneas, repetir isso o tempo todo consome CPU, memória e tempo de resposta.
Como o pool resolve isso
Com o pooling, o Pgpool-II mantém um conjunto de conexões reutilizáveis já abertas e já autenticadas com o PostgreSQL. Quando uma nova requisição chega, ela pega emprestada uma conexão existente do pool, executa a consulta e devolve a conexão — em vez de passar de novo pelas etapas de criação de processo e autenticação.
Na prática, isso significa pular direto para a consulta e os resultados, aproveitando uma conexão que já estava pronta para uso.
Os benefícios do pooling
Reaproveitar conexões em vez de recriá-las o tempo todo traz uma série de ganhos:
- Menos sobrecarga — reutiliza conexões existentes, evitando o custo de abrir e fechar conexões a cada requisição.
- Mais performance — reduz a latência e melhora o tempo de resposta da aplicação, já que as conexões já estão estabelecidas.
- Maior escalabilidade — suporta mais usuários concorrentes usando menos recursos do banco.
- Eficiência de recursos — otimiza o uso de CPU, memória e conexões no banco de dados.
- Gestão centralizada — o Pgpool-II gerencia o pool de conexões, balanceia a carga e monitora a saúde dos nós, tudo em um único ponto.
Pooling e load balancing andam juntos
Vale reforçar: pooling e load balancing são duas funções distintas do Pgpool-II, mas que trabalham em conjunto. O pool cuida de reaproveitar conexões, enquanto o load balancing cuida de para qual servidor (primário ou réplica) cada consulta deve ir. Se você quiser entender essa segunda parte em detalhes, incluindo um exemplo prático de configuração, vale a pena ler o artigo sobre o Pgpool-II como load balancer.
Resumindo
Pooling é eficiência: menos conexões abertas do zero, mais desempenho e uma experiência melhor para quem usa a aplicação. Para qualquer sistema que lida com um volume razoável de requisições simultâneas ao banco, entender e configurar bem o pool de conexões é tão importante quanto escolher o hardware certo.
Saiba mais:
Documentação oficial do Pgpool-II: https://www.pgpool.net/docs/latest/en/html/
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que é connection pooling, segundo o artigo?
Resposta correta: B) Manter um conjunto de conexões já abertas e reutilizá-las entre requisições, em vez de abrir uma conexão nova a cada vez.
O artigo define connection pooling exatamente como essa técnica de reaproveitamento de conexões.
2. Segundo o artigo, quais etapas do fluxo de uma nova conexão são as mais custosas?
Resposta correta: C) Criação do processo em backend e autenticação.
O artigo explica que criar um novo processo no backend e autenticar as credenciais são as etapas mais custosas, repetidas a cada nova conexão sem pooling.
3. O que acontece quando uma requisição usa uma conexão do pool, segundo o artigo?
Resposta correta: A) Ela pula as etapas de criação de processo e autenticação, indo direto para a consulta.
O artigo mostra que uma conexão do pool já está aberta e autenticada, então a requisição aproveita esse trabalho já feito.
4. Qual a diferença entre pooling e load balancing no Pgpool-II, segundo o artigo?
Resposta correta: D) Pooling reaproveita conexões, enquanto load balancing decide para qual servidor (primário ou réplica) cada consulta vai.
O artigo reforça que são duas funções distintas do Pgpool-II que trabalham em conjunto.