Como Carregar Seus Dados: Incremental, Full, Append, Overwrite e Upsert
Carregar dados não é só copiar de um lugar para outro. Conheça as cinco estratégias de carga mais usadas, veja como cada uma funciona com exemplos simples e aprenda a escolher a ideal para o seu cenário.
01/10/2026 Engenharia de Dados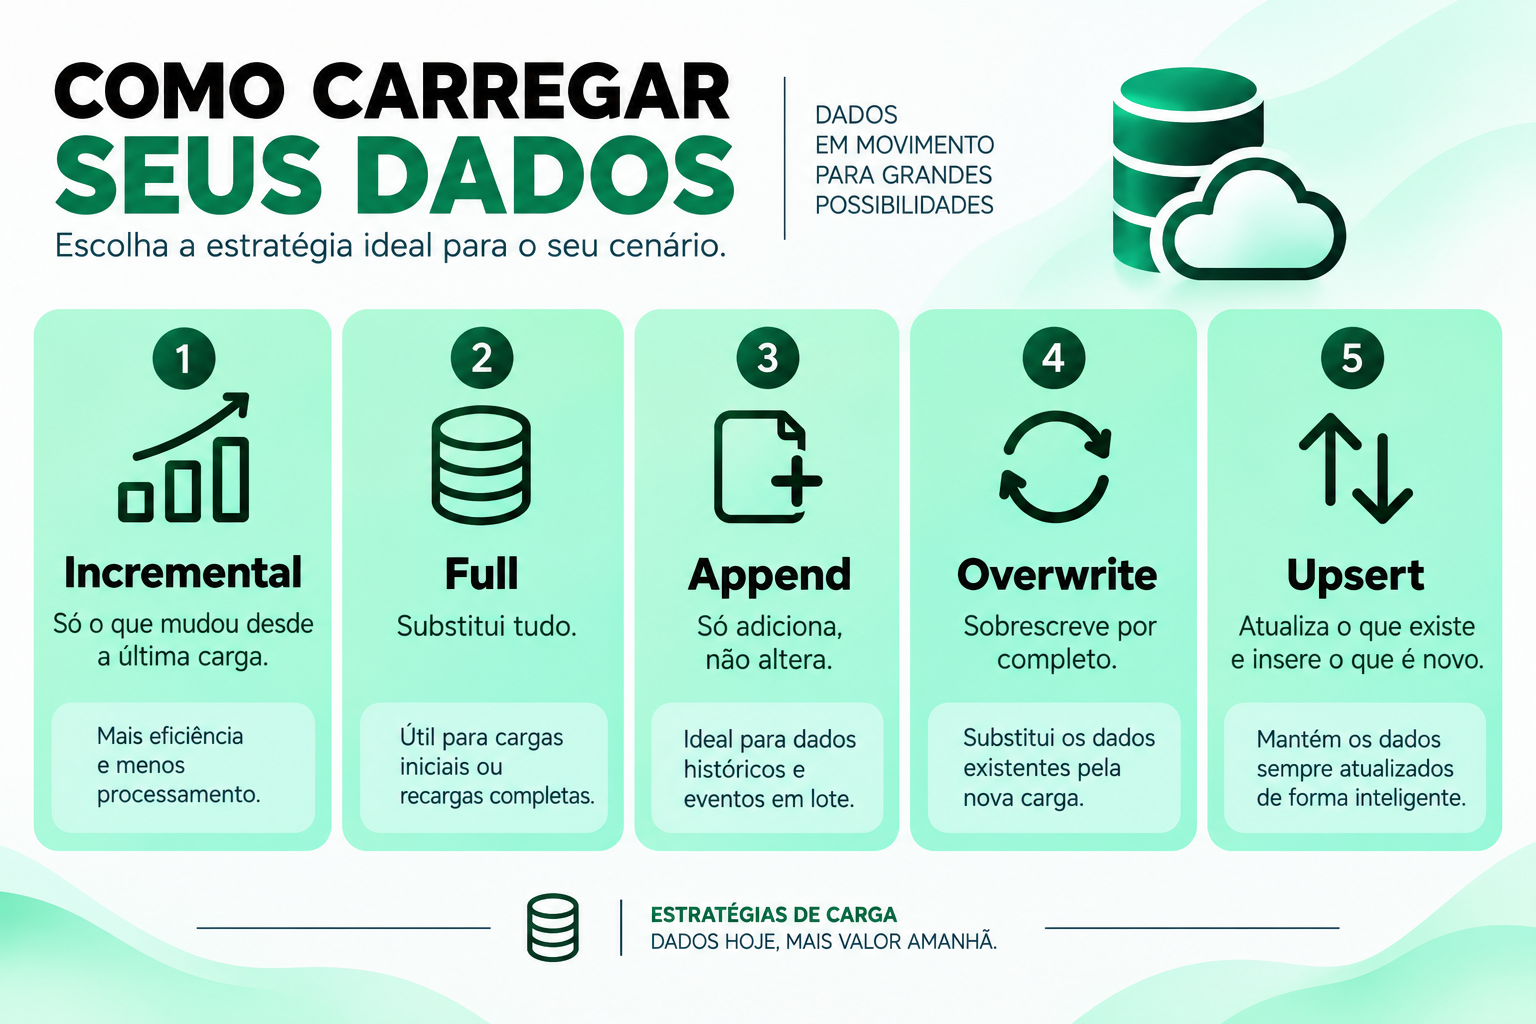
Todo pipeline de dados precisa responder a uma pergunta que parece simples: como os dados vão sair da origem e chegar ao destino? Copiar tudo de novo a cada execução? Levar só o que mudou? Acrescentar no final? Apagar e gravar por cima?
Essa decisão se chama estratégia de carga, e ela afeta diretamente o custo, o tempo de processamento e a confiabilidade dos seus dados. Neste artigo vamos passar pelas cinco estratégias do infográfico — Incremental, Full, Append, Overwrite e Upsert — sempre com exemplos simples.
Antes de tudo: duas perguntas diferentes
Um ponto que costuma confundir quem está começando: esses cinco nomes não respondem todos à mesma pergunta. Na prática, uma carga envolve duas decisões:
- O que eu busco na origem? Tudo (Full) ou só o que mudou (Incremental).
- Como eu gravo no destino? Acrescentando (Append), substituindo (Overwrite) ou mesclando (Upsert).
Por isso as estratégias se combinam. Uma carga Full normalmente é gravada com Overwrite; uma carga Incremental normalmente é gravada com Append ou com Upsert. Guarde essa ideia, porque ela deixa todo o resto mais fácil de entender.
Para os exemplos, imagine uma tabela de clientes com 1 milhão de registros, que recebe por dia cerca de 500 clientes novos e 200 alterações de cadastro.
1. Incremental: só o que mudou desde a última carga
Na carga incremental, o pipeline busca apenas os registros novos ou alterados desde a última execução. No nosso exemplo, em vez de ler 1 milhão de linhas todos os dias, ele lê só as 700 que importam.
Para isso, o pipeline precisa de uma forma de saber "onde parou". As mais comuns são:
- Coluna de controle (marca d'água): uma coluna como
data_atualizacaoou um ID sequencial. O pipeline guarda o maior valor já carregado e, na próxima execução, busca apenas o que for maior que ele. - CDC (Change Data Capture): captura as mudanças direto do log do banco de dados, incluindo inserções, alterações e exclusões.
Vantagem: mais eficiência e menos processamento — cargas rápidas, baratas e com menos impacto no sistema de origem.
Cuidados: depende de uma coluna de controle confiável. Se um registro for alterado sem atualizar a data, a mudança passa despercebida. Além disso, registros excluídos na origem não aparecem em uma consulta por data — é preciso CDC ou outra forma de tratá-los.
2. Full: substitui tudo
A carga full (ou carga completa) é a mais simples de todas: a cada execução, o pipeline lê todos os dados da origem e recarrega o destino por inteiro. No exemplo, o 1 milhão de clientes é lido novamente todos os dias.
Vantagem: simplicidade e consistência. O destino fica sempre igual à origem, sem precisar controlar o que mudou — inclusive as exclusões são refletidas naturalmente.
Cuidados: o custo cresce junto com a tabela. O que leva segundos com mil registros pode levar horas com bilhões.
Quando usar: na carga inicial de uma tabela, em recargas completas (por exemplo, depois de corrigir um erro) e em tabelas pequenas, como cadastros de países, categorias ou filiais.
3. Append: só adiciona, não altera
No append, os novos registros são acrescentados ao final da tabela de destino. Nada do que já estava lá é alterado ou removido. Funciona como um diário: você escreve páginas novas, mas não volta para apagar as antigas.
Vantagem: é rápido, simples e preserva todo o histórico.
Cuidados: se a mesma carga for executada duas vezes, os registros ficam duplicados. E se um dado já carregado mudar na origem, a versão antiga continua lá. Por isso, o append não é indicado para dados que sofrem atualização.
Quando usar: em dados históricos e eventos em lote que não mudam depois de registrados — logs de acesso, cliques, transações financeiras, leituras de sensores.
4. Overwrite: sobrescreve por completo
No overwrite, os dados existentes no destino são substituídos pela nova carga. O que estava antes deixa de valer; o que chegou agora passa a ser a verdade.
Ele é o par natural da carga Full, mas não precisa ser da tabela inteira: é muito comum sobrescrever apenas uma partição. Por exemplo, reprocessar só as vendas do dia 30/09 e substituir apenas essa fatia, sem tocar no restante da tabela.
Vantagem: pode ser executado quantas vezes for necessário sem gerar duplicidade — o resultado final é sempre o mesmo. Essa propriedade é chamada de idempotência e é muito valiosa em pipelines.
Cuidados: o que foi sobrescrito se perde, a menos que o formato da tabela guarde versões anteriores (como o Delta Lake faz com o time travel). Uma carga com erro ou vazia pode apagar dados bons.
5. Upsert: atualiza o que existe e insere o que é novo
Upsert é a junção de UPDATE + INSERT. Para cada registro que chega, o pipeline compara uma chave (como o id_cliente) com o destino:
- se a chave já existe, o registro é atualizado;
- se a chave não existe, o registro é inserido.
No nosso exemplo, os 500 clientes novos são inseridos e os 200 alterados são atualizados, sem duplicar ninguém. Em SQL, isso costuma ser feito com o comando MERGE:
MERGE INTO clientes AS destino
USING clientes_novos AS origem
  ON destino.id_cliente = origem.id_cliente
WHEN MATCHED THEN
  UPDATE SET nome = origem.nome, email = origem.email
WHEN NOT MATCHED THEN
  INSERT (id_cliente, nome, email)
  VALUES (origem.id_cliente, origem.nome, origem.email);
Vantagem: mantém os dados sempre atualizados de forma inteligente, sem duplicidade e sem precisar recarregar tudo.
Cuidados: exige uma chave única e confiável, e é uma operação mais pesada que o append, porque precisa comparar o que chega com o que já existe. Se a carga trouxer a mesma chave repetida, é preciso remover as duplicidades antes do merge.
Como escolher a estratégia ideal
Não existe uma estratégia melhor que as outras: existe a mais adequada para cada cenário. Algumas perguntas ajudam a decidir:
- A tabela é pequena ou é a primeira carga? Full com Overwrite resolve de forma simples.
- Os dados são eventos que nunca mudam? Incremental com Append.
- Os registros são atualizados na origem? Incremental com Upsert.
- Precisa reprocessar um período específico? Overwrite da partição correspondente.
- Existe uma coluna confiável para identificar o que mudou? Se não existir, a carga incremental fica arriscada, e a Full pode ser o caminho mais seguro.
Em um mesmo projeto é normal conviver com várias delas: cadastros pequenos em Full, eventos em Append e tabelas de clientes ou pedidos em Upsert.
Resumindo
- Incremental: busca só o que mudou. Mais eficiência, menos processamento.
- Full: recarrega tudo. Simples, ideal para cargas iniciais e tabelas pequenas.
- Append: só adiciona. Ideal para históricos e eventos.
- Overwrite: substitui o que existe pela nova carga. Seguro para reexecutar.
- Upsert: atualiza o que existe e insere o que é novo. Dados sempre atualizados sem duplicidade.
Escolher bem a estratégia de carga é o que separa um pipeline que escala com tranquilidade de um que fica mais lento e mais caro a cada dia. Dados bem carregados hoje significam mais valor amanhã.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que caracteriza uma carga incremental?
Resposta correta: B) Busca apenas os registros novos ou alterados desde a última carga.
A carga incremental usa uma coluna de controle ou CDC para trazer só o que mudou, reduzindo o processamento.
2. Para qual tipo de dado a estratégia Append é mais indicada?
Resposta correta: C) Dados históricos e eventos que não mudam depois de registrados.
O append só adiciona registros e não altera os existentes, por isso é ideal para logs, eventos e transações.
3. O que o Upsert faz quando a chave do registro já existe no destino?
Resposta correta: A) Atualiza o registro existente.
Upsert combina UPDATE e INSERT: atualiza quando a chave existe e insere quando ela não existe.
4. Qual é o principal risco de executar duas vezes a mesma carga em modo Append?
Resposta correta: D) Os registros ficam duplicados.
Como o append apenas acrescenta, repetir a carga grava os mesmos registros de novo. Já o overwrite pode ser reexecutado sem duplicar.