Pandas: fundamentos e limites no processamento de dados com Python
Entenda DataFrame e Series, pratique operações por coluna e aprenda a planejar o uso de memória com um exemplo de estoque, laboratório e jogo interativo.
17/11/2026 Engenharia de Dados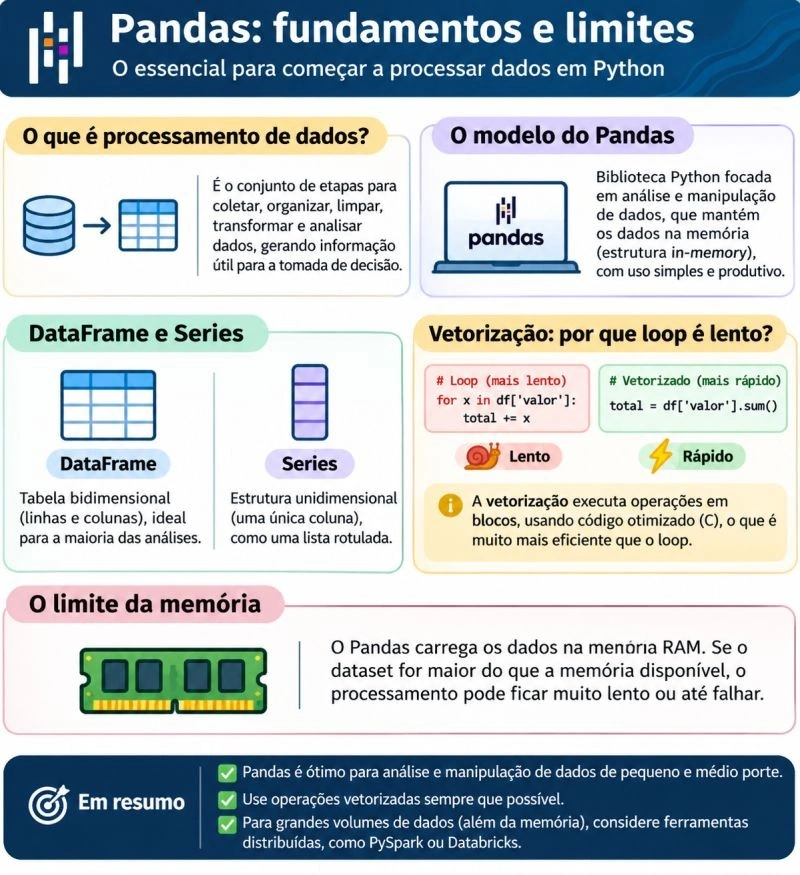
Uma tabela não é apenas um arquivo
Uma loja quer saber quanto dinheiro está representado nos produtos de seu estoque. Receber uma planilha é só o começo: precisamos entender cada coluna, conferir quantidades e preços, calcular valores e organizar a resposta. Esse caminho, da informação recebida ao resultado que ajuda uma decisão, é um exemplo de processamento de dados.
O infográfico apresenta o Pandas como uma ferramenta para organizar, limpar, transformar e analisar dados. Vamos acompanhar essa ideia com um exemplo pequeno, que pode ser conferido à mão. O objetivo não é repetir a comparação entre Pandas e PySpark, nem as equivalências com SQL, mas entender as estruturas e os cuidados antes de aumentar o volume.
Pandas: uma biblioteca, não uma linguagem nova
Escrevemos o programa em Python e usamos os recursos do Pandas para trabalhar com dados rotulados. DataFrame e Series são suas estruturas centrais. O modelo habitual é de análise em memória: os dados em uso ocupam espaço no processo que executa a análise. Isso facilita a exploração, mas exige atenção ao tamanho das estruturas e ao trabalho intermediário. [1][3]
Pense numa bancada de trabalho. Os materiais abertos são os dados em uso; a capacidade da bancada ajuda a imaginar a memória disponível. A comparação tem limites: um DataFrame é uma estrutura computacional, não uma planilha física, e o consumo real depende dos tipos de dados, das operações e do ambiente.
DataFrame e Series: duas formas de olhar os dados
DataFrame é uma estrutura bidimensional, com linhas e colunas rotuladas. Na amostra da loja, cada linha descreve um produto, enquanto as colunas registram nome, categoria, quantidade e preço unitário. As colunas podem ter tipos diferentes: nomes são texto e quantidades podem ser números inteiros. [1]
Series é uma estrutura unidimensional com um índice, isto é, rótulos associados aos valores. Uma coluna selecionada do nosso DataFrame pode ser uma Series, mas essa estrutura também pode existir de forma independente. Chamar Series apenas de “uma coluna” ajuda no primeiro contato, porém não descreve todas as suas possibilidades. [1]
No código, selecionar quantidade com colchetes simples devolve uma Series nesta amostra de colunas únicas. Selecionar uma lista contendo produto e quantidade mantém um DataFrame. Também é importante observar o índice: operações entre estruturas do Pandas podem alinhar valores pelos rótulos, não apenas pela posição visual. [1][2]
Exemplo prático: qual é o valor do estoque?
Usaremos quatro produtos fictícios. Duas canecas custam trinta e cinco reais cada; três cadernos custam doze reais cada; cinco lápis custam dois reais cada; e uma mochila custa cento e cinquenta reais. Multiplicando quantidade pelo preço unitário, encontramos setenta, trinta e seis, dez e cento e cinquenta reais. O estoque total representa duzentos e sessenta e seis reais.
Para tornar a amostra fácil de conferir, guardamos preços em centavos inteiros. O exemplo assume quantidades e preços válidos, sem valores ausentes, devoluções ou descontos. Um projeto real também precisa definir essas regras; uma biblioteca não decide sozinha o que deve entrar no cálculo.
import pandas as pd

# Dados fictícios. Preços em centavos inteiros nesta amostra.
df = pd.DataFrame({
    "produto": ["Caneca", "Caderno", "Lápis", "Mochila"],
    "categoria": ["Casa", "Papelaria", "Papelaria", "Acessórios"],
    "quantidade": [2, 3, 5, 1],
    "preco_centavos": [3500, 1200, 200, 15000],
})

# Uma coluna selecionada com colchetes simples: Series.
quantidades = df["quantidade"]
# Uma lista de colunas mantém o resultado como DataFrame.
visao = df[["produto", "quantidade"]]

# Operação entre colunas: um valor de estoque por linha.
df["valor_centavos"] = df["quantidade"] * df["preco_centavos"]
por_categoria = df.groupby("categoria")["valor_centavos"].sum()
total_centavos = int(por_categoria.sum())

# Duas maneiras de somar a mesma coluna, sem benchmark.
total_loop = 0
for valor in df["valor_centavos"]:
    total_loop += valor
total_vetorizado = int(df["valor_centavos"].sum())
assert total_loop == total_vetorizado == total_centavos

print("Estruturas:", type(quantidades).__name__, type(visao).__name__)
for categoria, centavos in por_categoria.items():
    print(f"{categoria}: R$ {centavos // 100},{centavos % 100:02d}")
print(f"Total do estoque: R$ {total_centavos // 100},{total_centavos % 100:02d}")
print("Somas equivalentes em centavos:", total_loop, total_vetorizado)
print("Memória estimada do DataFrame (bytes):", int(df.memory_usage(deep=True).sum()))
Saída real obtida na execução do exemplo:
Estruturas: Series DataFrame
Acessórios: R$ 150,00
Casa: R$ 70,00
Papelaria: R$ 46,00
Total do estoque: R$ 266,00
Somas equivalentes em centavos: 26600 26600
Memória estimada do DataFrame (bytes): 801
A multiplicação entre quantidade e preço calcula uma nova coluna. Depois, o agrupamento reúne os valores por categoria: Casa soma setenta reais, Papelaria soma quarenta e seis reais e Acessórios soma cento e cinquenta reais. Agrupar responde uma pergunta diferente de simplesmente contar linhas. O resultado precisa conservar o significado da regra de negócio. [2][7]
Vetorização: expresse a operação, não cada passo do laço
O infográfico contrasta um laço de soma com a operação de soma da coluna. No exemplo, as duas formas produzem o mesmo total. A diferença de expressão é importante: em vez de controlar uma acumulação valor por valor em Python, usamos uma operação oferecida pela estrutura de dados. Para esse tipo de cálculo numérico, priorizar operações de coluna é um bom ponto de partida. [2][8]
Pandas pode aproveitar operações otimizadas do ecossistema NumPy e implementações compiladas. Isso não significa que toda chamada escrita numa linha será sempre mais rápida, nem que o trabalho passou automaticamente para várias máquinas. O tipo de operação, os dados e as conversões necessárias precisam ser considerados. [2][3][8]
Também não basta trocar um laço por uma função aplicada a cada linha e chamar isso de otimização. A documentação descreve a aplicação de funções Python como uma opção flexível, não uma garantia de velocidade. Prefira a operação específica quando ela existir e meça antes de prometer ganhos. Esta publicação confere resultados; não apresenta benchmark nem afirma quantas vezes uma forma é mais rápida. [2][8]
Memória: reserve espaço para trabalhar, não só para abrir
A mensagem central do infográfico é útil: memória é um limite importante. Mas o tamanho do arquivo no disco não é uma medida suficiente do que será necessário durante a análise. A representação em memória e os resultados intermediários também ocupam espaço. Mesmo uma tabela que abre com sucesso pode se tornar difícil de processar numa operação seguinte. [3][4]
No exemplo, a chamada de uso de memória com inspeção detalhada fornece uma estimativa das colunas e do índice, em bytes. Ela ajuda a investigar onde o DataFrame ocupa espaço, mas não mede, sozinha, toda a memória do processo ou o pico de cada operação. O número exibido na saída foi observado no ambiente de teste e pode mudar com a versão e os tipos usados. [4][5]
Por isso, não existe neste guia um limite universal de linhas ou de gigabytes. Na bancada, importa tanto o tamanho dos materiais quanto a área necessária para trabalhar. Na análise, precisamos observar os dados realmente usados e a operação planejada, em vez de concluir que todo arquivo pequeno é seguro ou que todo arquivo grande exige a mesma solução. [3][5]
Laboratório guiado: leia menos e mantenha um resumo
Uma primeira escolha é evitar carregar colunas que o cálculo não utiliza. Na leitura de CSV, podemos selecionar colunas, declarar tipos compatíveis com os valores e pedir lotes de linhas. O tamanho do lote precisa ser escolhido e testado no ambiente real; ele não representa uma quantidade fixa de bytes. [6]
O laboratório abaixo lê a mesma amostra em dois lotes de duas linhas. Em cada lote, calcula os valores e guarda apenas o resumo acumulado por categoria. O texto do CSV está embutido somente para facilitar a reprodução do exercício. Num arquivo real, substitua essa pequena string pelo caminho do CSV, sem ler antes todo o arquivo para uma string.
from io import StringIO
import pandas as pd

# StringIO contém somente a pequena amostra didática.
# Em um CSV real, use o caminho do arquivo, sem carregá-lo todo como string.
csv = StringIO("""produto,categoria,quantidade,preco_centavos
Caneca,Casa,2,3500
Caderno,Papelaria,3,1200
Lápis,Papelaria,5,200
Mochila,Acessórios,1,15000
""")
totais = pd.Series(dtype="int64")
lotes_processados = 0
with pd.read_csv(
    csv,
    usecols=["categoria", "quantidade", "preco_centavos"],
    dtype={"quantidade": "int64", "preco_centavos": "int64"},
    chunksize=2,
) as leitor:
    for lote in leitor:
        lote["valor_centavos"] = lote["quantidade"] * lote["preco_centavos"]
        parcial = lote.groupby("categoria")["valor_centavos"].sum()
        totais = totais.add(parcial, fill_value=0).astype("int64")
        lotes_processados += 1

for categoria, centavos in totais.sort_index().items():
    print(f"{categoria}: R$ {centavos // 100},{centavos % 100:02d}")
print("Lotes processados:", lotes_processados)
print("Total em centavos:", int(totais.sum()))
Saída real obtida na execução do exemplo:
Acessórios: R$ 150,00
Casa: R$ 70,00
Papelaria: R$ 46,00
Lotes processados: 2
Total em centavos: 26600
A soma por categoria permite combinar os totais parciais deste exemplo. Não estamos mostrando que qualquer agrupamento ou análise pode ser repartido dessa forma. Uma operação que dependa de relacionar todos os registros pode exigir outra estratégia. Também não adianta ler em lotes e depois reunir todos novamente numa tabela enorme. [6][7]
O resumo também precisa caber na memória. Se cada registro tiver uma categoria diferente, esse acumulador pode crescer muito. O exemplo com quatro produtos demonstra a lógica, não uma prova de capacidade para milhões de registros. Se o fluxo continuar incompatível com os recursos disponíveis, vale reavaliar onde os dados são consultados e como o processamento será organizado. [3][7]
Pratique mudando uma coisa de cada vez
Primeiro, identifique qual seleção do exemplo retorna Series e qual mantém DataFrame. Depois, altere a quantidade de canecas de duas para três: o valor de Casa deve passar a cento e cinco reais e o total do estoque a trezentos e um reais. Por fim, leia a amostra em lotes de uma, duas e três linhas e confira se o resumo permanece igual.
Ao testar, mantenha os preços unitários e a regra de multiplicação. Somar quantidade ao preço, ou contar os quatro produtos, não responde quanto o estoque vale. Conferir a resposta correta vem antes de procurar uma maneira mais rápida de calculá-la.
O que guardar para o próximo projeto
DataFrame organiza a tabela; Series permite trabalhar com uma dimensão de valores rotulados. Operações de coluna ajudam a expressar cálculos com clareza, enquanto a memória exige planejamento. Comece com uma amostra verificável, entenda a regra e observe o que a operação precisa manter disponível.
No jogo a seguir, monte o relatório e escolha uma estratégia que respeite uma bancada com capacidade fictícia. Os custos apresentados são inventados para ensinar a decisão; não são medições de memória do Pandas. Depois, use o quiz para revisar os conceitos e explicar suas escolhas.
Ambiente dos exemplos: Pandas 3.1.1. Execução local em amostra fictícia; sem medição comparativa de velocidade, teste de esgotamento de RAM ou execução distribuída.
Jogo: monte o relatório de estoque
Objetivo: escolher a estrutura, calcular o valor do estoque e planejar uma leitura que caiba na memória. Simulação didática em JavaScript; não executa Python nem mede RAM real.
Quiz: estruturas, cálculo e limites
Responda às seis questões e confira as explicações.
1. Qual estrutura representa a tabela completa de estoque?
Resposta correta: A) DataFrame, com linhas e colunas rotuladas.
DataFrame é bidimensional. Uma Series é unidimensional e tem índice.
2. O que df["quantidade"] retorna na amostra, cujas colunas têm nomes únicos?
Resposta correta: B) Uma Series com os valores e seu índice.
Uma coluna selecionada por seu nome devolve uma Series neste exemplo. Uma lista de colunas mantém DataFrame.
3. O que a comparação entre laço e soma da coluna demonstra aqui?
Resposta correta: C) Que o resultado é equivalente; o exemplo não mede velocidade.
Os dois cálculos chegam a 26600 centavos. Não foi realizado benchmark, e desempenho depende da operação e dos dados.
4. Qual é o total do estoque antes de alterar a quantidade de canecas?
Resposta correta: D) R$ 266,00.
Canecas somam 70, cadernos 36, lápis 10 e mochila 150 reais: total de 266 reais.
5. O que memory_usage(deep=True).sum() informa?
Resposta correta: A) Uma estimativa de bytes das colunas e do índice, não todo o pico de RAM do processo.
A estimativa ajuda a inspecionar a estrutura; o processo e as operações intermediárias têm outros custos.
6. Qual estratégia corresponde ao laboratório em lotes?
Resposta correta: B) Ler colunas necessárias e acumular resumos, verificando se lote e resumo cabem na memória.
chunksize conta linhas. O exercício combina somas parciais; outras operações podem precisar de estratégias diferentes.
Referências oficiais
Documentação oficial do Pandas consultada em 17/11/2026. O infográfico original foi preservado. A afirmação visual de que uma forma é mais rápida não é uma garantia geral; o exemplo confere o resultado sem benchmark. O tamanho do arquivo também não representa sozinho o consumo de memória.
- pandas — Intro to data structures
- pandas — Essential basic functionality: binary operations
- pandas — Scaling to large datasets
- pandas — Frequently asked questions: DataFrame memory usage
- pandas — DataFrame.memory_usage
- pandas — read_csv: usecols, dtype and chunksize
- pandas — Group by: split-apply-combine
- pandas — Enhancing performance
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Pandas: fundamentos e limites no processamento de dados com Python