Failover com Pgpool-II: Alta Disponibilidade para o PostgreSQL
Entenda o que acontece quando o nó primário do PostgreSQL cai e como o Pgpool-II promove automaticamente uma réplica a novo master para manter o serviço no ar.
29/09/2026 Bancos de Dados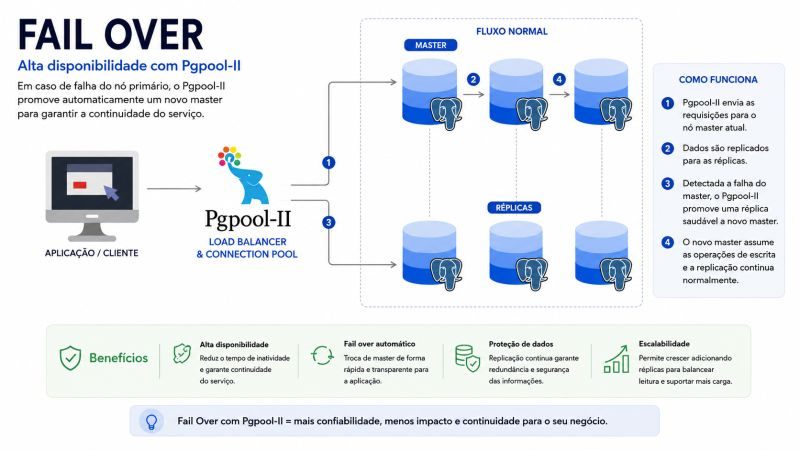
Nos últimos artigos, falei sobre como o Pgpool-II atua como load balancer e como ele faz pooling de conexões com o PostgreSQL. Agora vamos para a terceira peça, talvez a mais importante em produção: o que acontece quando o servidor principal simplesmente para de responder.
O que é failover?
Failover é o processo de transferir automaticamente as operações de um servidor que falhou para outro servidor saudável. No contexto do PostgreSQL com replicação, isso significa: se o nó primário (master) cair, uma das réplicas é promovida para assumir o papel de novo primário.
Sem failover, a queda do primário significa aplicação fora do ar até que alguém perceba o problema, entre no servidor e faça a troca manualmente — o que, de madrugada, pode levar muito tempo.
O fluxo normal
Em uma arquitetura típica, a aplicação não se conecta diretamente ao PostgreSQL. Ela se conecta ao Pgpool-II, que funciona como load balancer e connection pool. A partir daí:
- O Pgpool-II envia as requisições para o nó master atual (escritas) e pode distribuir leituras entre as réplicas;
- Os dados são replicados do master para as réplicas, normalmente via streaming replication do próprio PostgreSQL.
Quando o master falha
É aqui que o Pgpool-II mostra seu valor:
- Detecção da falha: o Pgpool-II monitora periodicamente os nós por meio do health check. Quando o master deixa de responder, ele é marcado como indisponível, e o Pgpool-II promove uma réplica saudável a novo master;
- Retomada: o novo master passa a receber as operações de escrita, e a replicação continua normalmente a partir dele para as réplicas restantes.
Para a aplicação, a troca é praticamente transparente: ela continua falando com o mesmo endereço do Pgpool-II, que passa a encaminhar as requisições para o novo primário. Em geral, as conexões que estavam ativas no momento da falha são interrompidas e precisam ser refeitas, por isso é importante que a aplicação saiba tentar reconectar.
Como isso é configurado
O failover no Pgpool-II é baseado principalmente em dois mecanismos: o health check, que detecta a falha, e o failover_command, um script executado quando a falha é detectada e que, na prática, promove a réplica escolhida. Um exemplo simplificado no pgpool.conf:
# Verificação de saúde dos nós
health_check_period = 10
health_check_timeout = 20
health_check_max_retries = 3
health_check_retry_delay = 1

# Script executado quando um nó falha
failover_command = '/etc/pgpool-II/failover.sh %d %h %p %D %m %H %M %P %r %R'

# Script que faz as réplicas restantes seguirem o novo primário
follow_primary_command = '/etc/pgpool-II/follow_primary.sh %d %h %p %D %m %H %M %P %r %R'
Os parâmetros %d, %h, %m e os demais são substituídos pelo Pgpool-II por informações como o ID e o host do nó que falhou e do novo primário. O script de failover é quem executa a promoção de fato, por exemplo com pg_ctl promote no servidor escolhido.
Os benefícios
- Alta disponibilidade — reduz o tempo de inatividade e garante a continuidade do serviço.
- Failover automático — a troca de master é rápida e transparente para a aplicação, sem depender de intervenção manual.
- Proteção de dados — a replicação contínua garante redundância e segurança das informações.
- Escalabilidade — permite crescer adicionando réplicas para balancear leituras e suportar mais carga.
Cuidados importantes
Failover automático resolve muito, mas não é mágica. Alguns pontos merecem atenção:
- O próprio Pgpool-II não pode ser um ponto único de falha. Se ele cair, a aplicação perde acesso ao banco mesmo com todos os nós do PostgreSQL saudáveis. Para isso existe o watchdog do Pgpool-II, que permite rodar mais de uma instância com um IP virtual compartilhado.
- Replicação assíncrona pode perder dados. Transações confirmadas no master que ainda não chegaram à réplica podem se perder na promoção. Se isso não for aceitável, avalie replicação síncrona.
- Teste o failover antes de precisar dele. Um script de failover que nunca foi executado de verdade é uma aposta, não uma garantia.
Resumindo
Failover com Pgpool-II significa mais confiabilidade, menos impacto e continuidade para o negócio. Junto com o load balancing e o pooling de conexões, ele fecha o trio de funcionalidades que faz do Pgpool-II uma peça central em arquiteturas de alta disponibilidade com PostgreSQL.
Saiba mais:
Documentação oficial do Pgpool-II: https://www.pgpool.net/docs/latest/en/html/
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que é failover, segundo o artigo?
Resposta correta: A) O processo de transferir automaticamente as operações de um servidor que falhou para outro servidor saudável.
No PostgreSQL com replicação, isso significa promover uma réplica a novo primário quando o master cai.
2. Como o Pgpool-II detecta que o nó master falhou?
Resposta correta: C) Por meio do health check, que monitora os nós periodicamente.
O health check detecta a falha, e o failover_command executa a promoção da réplica.
3. O que acontece depois que uma réplica é promovida a novo master?
Resposta correta: B) O novo master assume as escritas e a replicação continua normalmente para as réplicas restantes.
A aplicação continua falando com o mesmo endereço do Pgpool-II, que passa a encaminhar para o novo primário.
4. Por que o próprio Pgpool-II também precisa de alta disponibilidade?
Resposta correta: D) Porque, se ele cair, a aplicação perde acesso ao banco mesmo com os nós do PostgreSQL saudáveis.
Para evitar esse ponto único de falha, o Pgpool-II oferece o watchdog, com múltiplas instâncias e um IP virtual.