Kafka: o que é e como funciona o fluxo de eventos
Entenda o que é Kafka, como funcionam tópicos, partições e offsets e veja um exemplo de integração com Spark e Delta no Lakehouse.
09/10/2026 Engenharia de Dados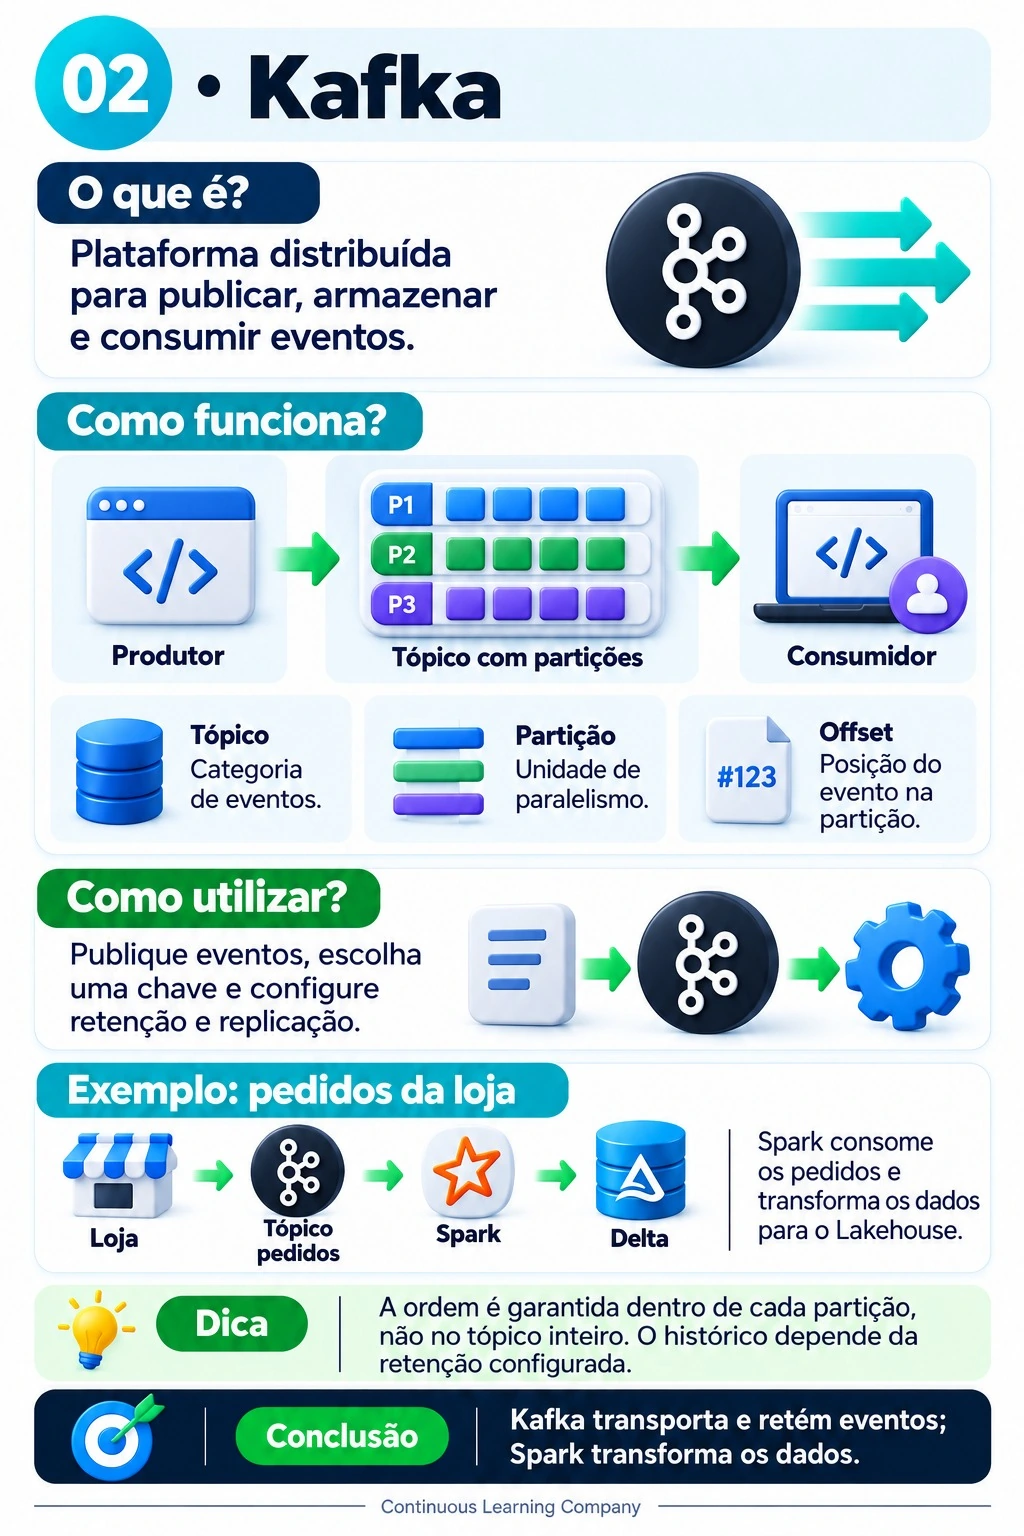
Um pedido realizado em uma loja, uma atualização de estoque ou uma leitura de sensor são exemplos de eventos: registros de que algo aconteceu.
O Apache Kafka é uma plataforma distribuída para publicar, armazenar e consumir esses eventos. Com ele, diferentes aplicações podem compartilhar informações sem depender de uma comunicação direta entre quem produz os dados e quem os utiliza.
Como o Kafka funciona?
O fluxo apresentado no infográfico tem três componentes: produtor → tópico com partições → consumidor.
O produtor é a aplicação que publica os eventos. Em uma loja virtual, por exemplo, o sistema de vendas pode enviar uma mensagem sempre que um novo pedido é criado.
O tópico organiza os eventos por assunto. Um tópico chamado pedidos pode reunir os registros relacionados às compras realizadas.
O consumidor lê esses eventos e executa o processamento necessário, como atualizar uma aplicação, alimentar uma análise ou iniciar uma transformação de dados.
Um mesmo tópico pode atender diferentes consumidores. Assim, os dados de um pedido podem ser utilizados por sistemas com necessidades distintas.
Tópico, partição e offset
- Tópico: agrupamento de eventos relacionados a um assunto, como pedidos, pagamentos ou estoque.
- Partição: divisão de um tópico que permite distribuir os dados e trabalhar com paralelismo.
- Offset: posição de um evento dentro de uma partição.
O offset funciona como uma referência de leitura. Como cada partição tem sua própria sequência, ele deve ser interpretado junto com a identificação da partição.
Como utilizar o Kafka?
Para montar um fluxo, é preciso definir quais eventos serão publicados, em qual tópico e como os consumidores irão utilizá-los.
- Chave do evento: ajuda a definir a partição de destino. Com uma estratégia de particionamento consistente, eventos com a mesma chave podem permanecer na mesma partição.
- Retenção: determina por quanto tempo ou até qual limite de armazenamento os eventos ficam disponíveis, conforme a política configurada.
- Replicação: mantém cópias das partições em diferentes servidores para aumentar a disponibilidade e a tolerância a falhas.
Consumir um evento não significa apagá-lo imediatamente. Sua permanência depende da política de retenção do tópico, o que permite reler dados ainda disponíveis.
Exemplo: pedidos de uma loja
O infográfico apresenta este caminho: loja → tópico pedidos → Spark → Delta.
A loja publica os eventos de pedidos no Kafka. O Spark consome esses eventos e aplica as transformações necessárias, como conversão de tipos, validações e regras de negócio.
Depois, os resultados são gravados em tabelas Delta para uso no Lakehouse. Nessa arquitetura, cada componente tem uma função:
- Kafka transporta e retém os eventos.
- Spark processa e transforma os dados.
- Delta armazena os resultados em tabelas que podem ser utilizadas por análises e aplicações.
Atenção à ordem dos eventos
A ordem é garantida dentro de cada partição, não entre todas as partições de um tópico.
Quando a sequência de eventos de uma entidade precisa ser preservada, a escolha da chave e da estratégia de particionamento deve considerar essa necessidade. Por exemplo, usar o identificador do pedido como chave pode ajudar a reunir seus eventos na mesma partição.
O histórico também tem um limite: só é possível reler os eventos que continuam disponíveis conforme a retenção configurada.
Conclusão
O Kafka permite que aplicações publiquem e consumam eventos de forma desacoplada. Para utilizá-lo bem, é necessário compreender como tópicos, partições, offsets, retenção e replicação afetam o fluxo.
No exemplo do infográfico, o Kafka disponibiliza os eventos de pedidos, enquanto o Spark transforma esses dados e os encaminha para tabelas Delta no Lakehouse.
Continue acompanhando os conteúdos da Continuous Learning Company para aprender mais sobre engenharia de dados e processamento de eventos.
Referência técnica
Documentação oficial do Apache Kafka: introdução e conceitos principais.
Teste o que você aprendeu
Escolha uma alternativa em cada pergunta e confira as explicações.
1. O que é um tópico no Kafka?
Resposta correta: A) Um agrupamento de eventos por assunto.
O tópico organiza eventos por assunto, como pedidos ou pagamentos.
2. O que o offset identifica?
Resposta correta: B) A posição de um evento dentro de uma partição.
Cada partição tem sua própria sequência de offsets.
3. Onde o Kafka garante a ordem dos eventos?
Resposta correta: C) Dentro de cada partição.
A garantia de ordenação se aplica a cada partição, não ao tópico inteiro.
4. No exemplo da loja, quem transforma os pedidos antes de gravar em Delta?
Resposta correta: A) Spark.
O Kafka transporta e retém os eventos; o Spark realiza as transformações.