Arquitetura do Apache Spark: Driver, Cluster Manager, Executors e Tasks
Como o Spark transforma o seu código em trabalho paralelo? Conheça cada peça da arquitetura, do Driver Program até as Tasks, com uma analogia simples e um exemplo passo a passo.
02/10/2026 Engenharia de Dados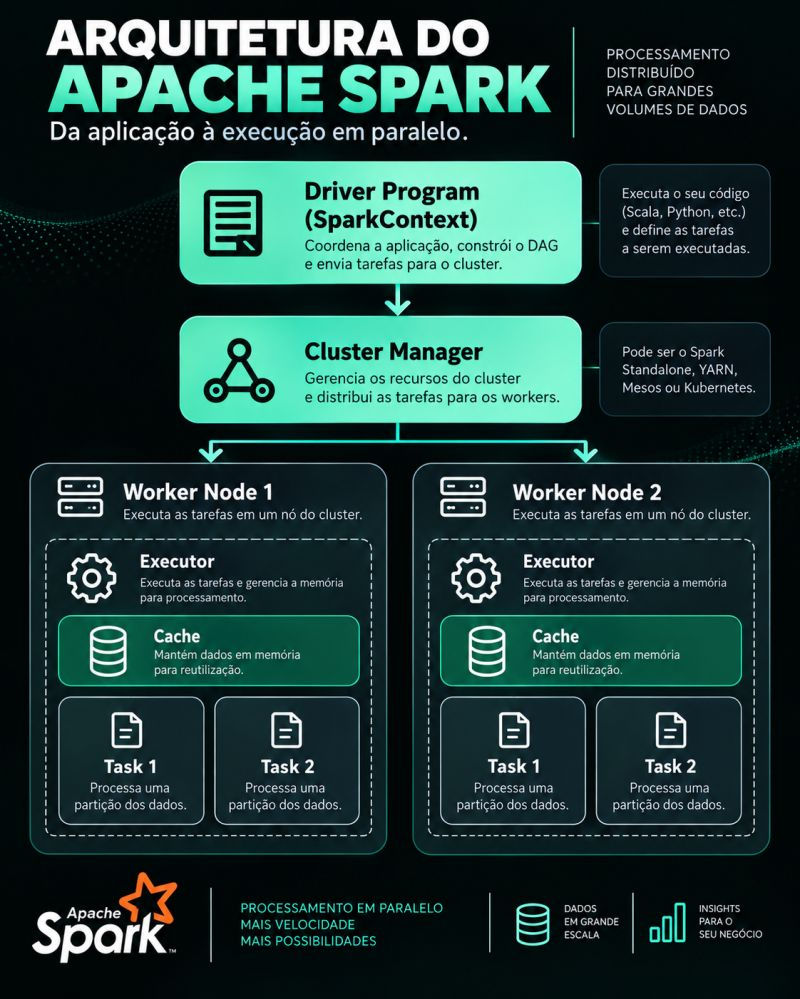
Você escreve três linhas de código para somar o valor de bilhões de vendas e, em poucos minutos, o resultado aparece. Como isso é possível? A resposta é a arquitetura do Apache Spark: um conjunto de peças que trabalham juntas para dividir um trabalho grande em vários trabalhos pequenos e executá-los ao mesmo tempo, em várias máquinas.
Neste artigo vamos percorrer o infográfico de cima para baixo, peça por peça, sempre com linguagem simples.
Uma analogia para começar: a cozinha de um restaurante
Imagine um restaurante enorme que recebe um pedido de 10 mil marmitas. Ninguém consegue fazer isso sozinho, então a cozinha se organiza:
- O chef lê o pedido, planeja as etapas e divide o trabalho. Ele é o Driver.
- O gerente da cozinha vê quais bancadas estão livres e distribui as tarefas. Ele é o Cluster Manager.
- Cada bancada é um Worker Node.
- O cozinheiro de cada bancada é o Executor.
- Cada receita individual que ele prepara é uma Task.
Com várias bancadas cozinhando ao mesmo tempo, as 10 mil marmitas ficam prontas muito mais rápido. É exatamente essa a ideia do Spark: processamento distribuído e em paralelo.
1. Driver Program (SparkContext): o cérebro da aplicação
O Driver Program é o processo que executa o seu código (em Python, Scala, Java ou R). Ele é o ponto de partida de toda aplicação Spark e tem três responsabilidades:
- Coordenar a aplicação do início ao fim;
- Construir o DAG (grafo acíclico dirigido), que é o plano com todas as etapas necessárias para chegar ao resultado;
- Enviar as tarefas para o cluster e juntar os resultados no final.
O SparkContext (hoje normalmente acessado pela SparkSession) é a porta de entrada: é por meio dele que o Driver conversa com o cluster.
2. Cluster Manager: quem distribui os recursos
O Driver sabe o que precisa ser feito, mas não sabe quais máquinas estão disponíveis. Quem sabe isso é o Cluster Manager, que gerencia os recursos do cluster (CPU e memória) e decide onde cada parte do trabalho vai rodar.
O Spark funciona com diferentes gerenciadores de cluster:
- Spark Standalone: o gerenciador que já vem com o próprio Spark;
- YARN: o gerenciador de recursos do ecossistema Hadoop;
- Kubernetes: muito usado em ambientes de nuvem e containers;
- Mesos: outro gerenciador de cluster, hoje menos utilizado.
3. Worker Nodes: as máquinas que trabalham
Os Worker Nodes são os nós (máquinas) do cluster que realmente executam o trabalho. No infográfico há dois, mas em produção podem ser dezenas ou centenas. Quanto mais workers, mais trabalho pode ser feito em paralelo.
4. Executor: quem executa e cuida da memória
Dentro de cada Worker existe um ou mais Executors. Eles são processos que:
- executam as tarefas recebidas do Driver;
- gerenciam a memória usada no processamento;
- devolvem os resultados ao Driver.
Os Executors vivem durante toda a aplicação, por isso podem guardar dados na memória e reaproveitá-los entre uma etapa e outra.
5. Cache: dados guardados na memória
O cache mantém dados em memória dentro do Executor para que possam ser reutilizados sem precisar ser lidos ou calculados de novo. Isso faz muita diferença quando o mesmo conjunto de dados é usado várias vezes, como em algoritmos de machine learning ou em análises repetidas.
df = spark.read.parquet("vendas.parquet")

df.cache()          # marca o DataFrame para ficar na memória

df.count()          # 1ª ação: lê do disco e guarda no cache
df.count()          # 2ª ação: já usa o que está na memória
O cache é preenchido na primeira ação executada. A partir da segunda, o Spark aproveita o que já está na memória.
6. Task: a menor unidade de trabalho
Uma Task é a menor unidade de trabalho do Spark: ela processa uma partição dos dados. Quando o Spark lê um arquivo grande, ele o divide em partições, e cada partição vira uma Task. Se o dado tem 200 partições, são 200 Tasks que podem ser executadas em paralelo, espalhadas entre os Executors disponíveis.
Cada Executor pode rodar várias Tasks ao mesmo tempo, conforme o número de núcleos (cores) disponíveis para ele.
Juntando tudo: o caminho de uma aplicação
Vamos ver o fluxo completo com um exemplo simples:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("vendas").getOrCreate()

df = spark.read.parquet("vendas.parquet")
total = df.groupBy("estado").sum("valor")
total.show()- O Driver executa esse código e monta o DAG com as etapas: ler, agrupar e somar.
- Quando chega em
show(), que é uma ação, o Driver pede recursos ao Cluster Manager. - O Cluster Manager reserva espaço nos Workers e os Executors são iniciados.
- O Driver divide o trabalho em Tasks, uma por partição, e as envia aos Executors.
- Cada Executor processa suas Tasks em paralelo, usando a memória (e o cache, se existir).
- Os resultados voltam ao Driver, que os junta e mostra na tela.
Por que o Spark só executa quando chega em uma ação?
O Spark usa a chamada avaliação preguiçosa (lazy evaluation). Operações como filter, select e groupBy são transformações: o Spark apenas anota o que deve ser feito no DAG, sem processar nada ainda. O trabalho só começa quando você chama uma ação, como show(), count() ou write(). Assim, o Spark enxerga o plano completo e consegue otimizá-lo antes de executar.
Por que essa arquitetura é poderosa?
- Processamento em paralelo: várias Tasks rodam ao mesmo tempo, o que dá mais velocidade;
- Dados em grande escala: o volume é dividido em partições, então nenhum nó precisa carregar tudo sozinho;
- Memória: o uso de cache evita leituras repetidas;
- Flexibilidade: o mesmo código roda em diferentes cluster managers e em diferentes linguagens.
Para lembrar
- Driver: executa o seu código, constrói o DAG e coordena tudo.
- Cluster Manager: gerencia e distribui os recursos do cluster.
- Worker Node: a máquina que executa o trabalho.
- Executor: executa as tarefas e gerencia a memória dentro do Worker.
- Cache: mantém dados em memória para reutilização.
- Task: a menor unidade de trabalho, que processa uma partição dos dados.
Entender essa arquitetura é o primeiro passo para escrever código Spark mais eficiente e para saber onde procurar quando algo fica lento ou falha. Na próxima vez que rodar um job, tente imaginar o Driver, os Executors e as Tasks trabalhando nos bastidores.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Qual componente executa o seu código, constrói o DAG e envia as tarefas ao cluster?
Resposta correta: C) Driver Program.
O Driver Program coordena a aplicação, monta o DAG e envia as tarefas.
2. Qual é o papel do Cluster Manager?
Resposta correta: A) Gerenciar os recursos do cluster e distribuir as tarefas para os workers.
Ele decide onde cada parte do trabalho roda. Pode ser Standalone, YARN, Mesos ou Kubernetes.
3. O que é uma Task no Spark?
Resposta correta: D) A menor unidade de trabalho, que processa uma partição dos dados.
Cada partição de dados vira uma Task, e várias Tasks podem rodar em paralelo.
4. Para que serve o cache dentro do Executor?
Resposta correta: B) Para manter dados em memória e reutilizá-los sem recalcular ou reler.
Reaproveitar dados em memória evita leituras e cálculos repetidos.
5. Por que um filter() ou select() não processa os dados imediatamente?
Resposta correta: B) Porque são transformações: o Spark só executa quando chega uma ação, como show() ou count().
Esse comportamento se chama avaliação preguiçosa e permite ao Spark otimizar o plano antes de executar.