Lakehouse com Delta: do dado bruto ao valor de negócio
Entenda transações, controle de esquema e as camadas Bronze, Silver e Gold. Acompanhe pedidos da loja até um resumo de vendas por dia.
14/10/2026 Engenharia de Dados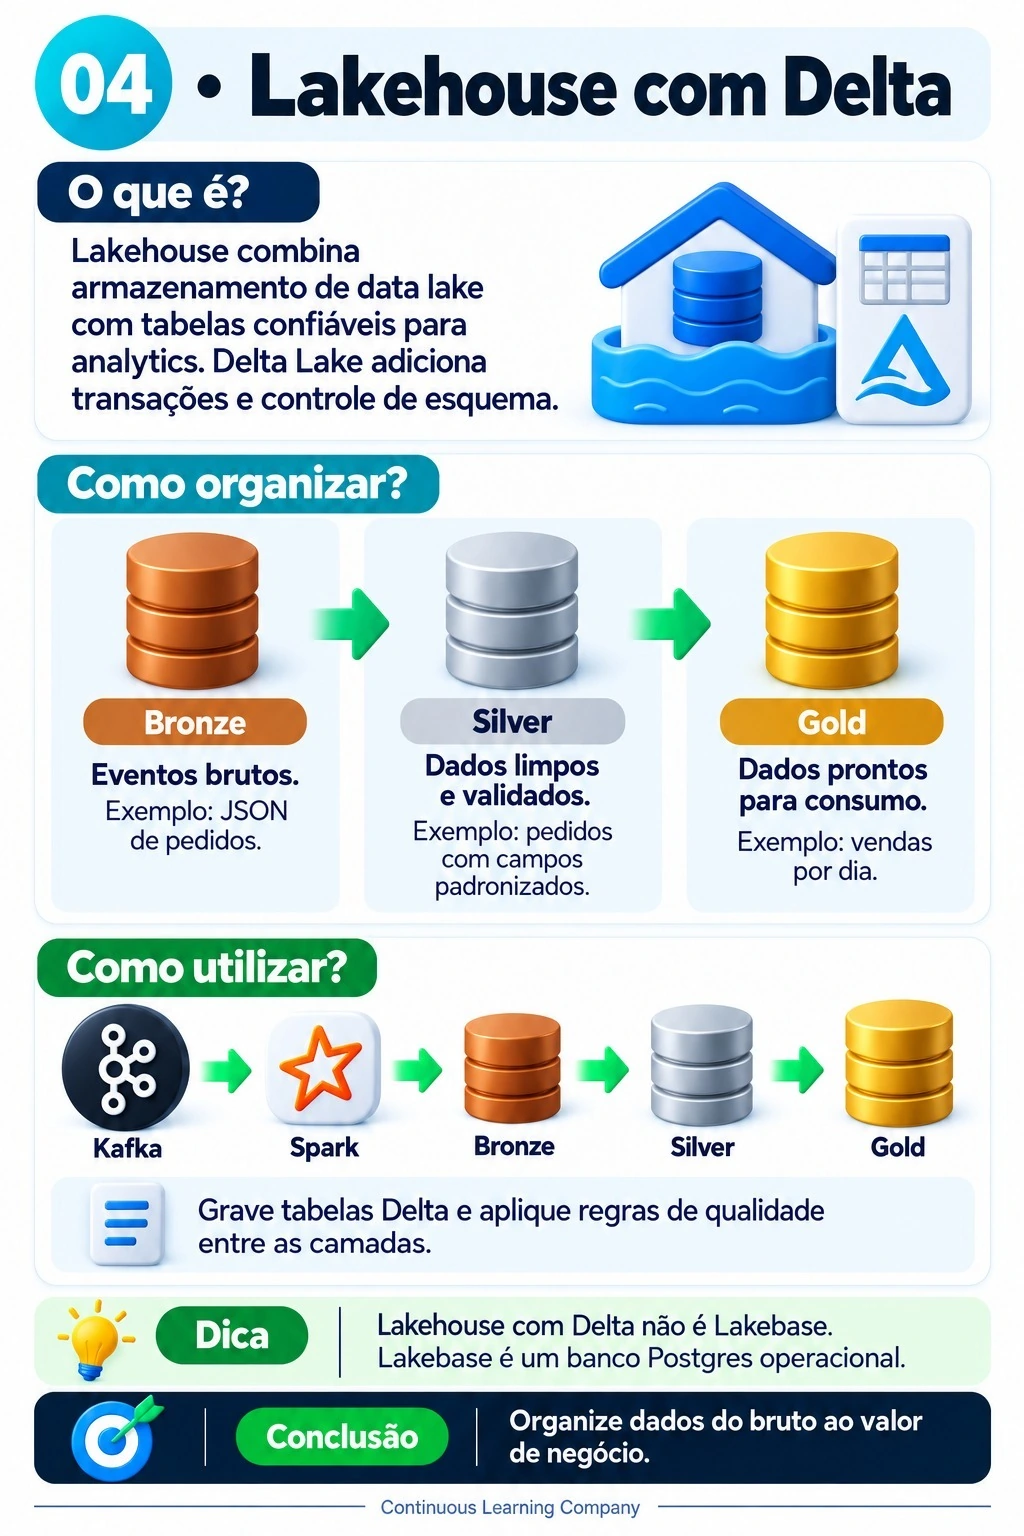
Por que organizar dados em camadas?
Uma loja recebe pedidos em formatos e níveis de qualidade diferentes. Ter todos os arquivos guardados não basta para responder quanto foi vendido: precisamos preservar a origem, validar os registros e preparar uma visão de negócio. Esse é o percurso desta publicação, do dado bruto ao resultado para consumo.
Nos conteúdos anteriores, vimos Kafka disponibilizar os eventos e Spark Structured Streaming processá-los. Agora, aprofundamos a organização e a confiabilidade das tabelas no destino, sem repetir a introdução geral ao fluxo.
Lakehouse é a arquitetura; Delta Lake é uma tecnologia de tabelas
O Lakehouse aproxima o armazenamento de um data lake dos recursos de tabelas confiáveis para análise. Delta Lake é um projeto aberto que permite construir essa arquitetura sobre armazenamento de dados, com transações ACID e integração entre processamento em lote e em streaming. Não é outro nome para Spark nem para Kafka.[2]
Nas tabelas Delta usadas com Spark, arquivos de dados em Parquet trabalham junto com um registro de transações. Esse registro coordena as versões da tabela; ler uma pasta de arquivos Parquet sem a semântica Delta não equivale a ler a tabela com suas garantias.[3][4]
O que Delta acrescenta à confiabilidade?
Transações ACID: uma gravação é confirmada como uma mudança consistente da tabela. Leitores trabalham com uma visão consistente, enquanto conflitos entre gravações são detectados. Essas garantias são da tabela; não devemos inferir que um pipeline inteiro de três tabelas será uma única transação.[4]
Controle de esquema: o Delta verifica a compatibilidade dos campos e tipos na escrita. Evolução de esquema deve ser uma decisão explícita, não uma autorização para aceitar qualquer mudança. Um valor negativo, porém, pode ter o tipo correto e ainda violar uma regra da loja: esquema e qualidade de negócio não são a mesma coisa.[3]
Histórico de versões: o time travel permite consultar versões anteriores quando o histórico e os arquivos necessários continuam disponíveis. A retenção e operações como VACUUM precisam ser planejadas; não trate esse recurso como histórico infinito ou substituto automático de backup.[3]
Bronze, Silver e Gold: três responsabilidades
- Bronze: preserva a entrada bruta e a rastreabilidade. No exemplo, guarda o JSON recebido, inclusive pedidos que depois serão rejeitados.
- Silver: interpreta os campos, padroniza tipos e aplica validações. Mantém pedidos válidos no nível de detalhe de cada pedido.
- Gold: organiza resultados para uma necessidade de consumo. Aqui, resume a quantidade de pedidos e o valor vendido por dia.
Esse padrão é chamado de arquitetura medallion. As camadas são uma organização lógica recomendada, não uma exigência técnica para que uma tabela seja Delta. Não basta dar os nomes Bronze, Silver e Gold a três pastas: cada passagem precisa ter regras claras e responsáveis definidos.[1]
Como o fluxo se conecta: Kafka, Spark e tabelas Delta
O infográfico apresenta Kafka → Spark → Bronze → Silver → Gold. Kafka é uma possível origem de eventos, Spark executa o processamento e cada camada guarda tabelas com uma finalidade. Fontes em arquivos ou cargas em lote também podem alimentar essa arquitetura; Kafka não é obrigatório para usar Delta.[1][5]
Em streaming, cada consulta precisa de um checkpoint próprio e persistente. Progresso técnico não elimina duplicidades publicadas pela origem: repetição de pedidos, atualizações e eventos atrasados exigem regras adequadas. A camada Gold também precisa ser atualizada de modo compatível com a agregação escolhida.[5]
Exemplo prático: pedidos até vendas por dia
Para enxergar as três camadas sem depender de um Kafka conectado, faremos uma demonstração em lote com PySpark. A sessão spark deve estar inicializada com o suporte Delta compatível e ter acesso aos caminhos de armazenamento. O site apresenta o exemplo, mas não executa um cluster Spark.
Use um diretório exclusivo de demonstração. As escritas utilizam errorifexists: se uma tabela já existir naquele caminho, o exemplo falha em vez de sobrescrevê-la. Substitua o caminho pelos valores do seu ambiente; não use pastas de produção.[3]
1. Bronze: preserve as mensagens recebidas
As quatro mensagens ficam preservadas como texto. Não removemos o pedido negativo nem o identificador vazio nesta etapa: a entrada original permite investigar por que foram rejeitados mais adiante.
from pyspark.sql import functions as F
from pyspark.sql.types import (
    StructType, StructField, StringType,
    DecimalType, TimestampType,
)

# A sessão spark já deve ter suporte Delta configurado.
spark.conf.set("spark.sql.session.timeZone", "UTC")
base = "/dados/demo_lakehouse_delta"

mensagens = [
    ('{"pedido_id": "P001", "valor": 120.5, "event_time": "2026-10-14T10:00:00Z"}',),
    ('{"pedido_id": "P002", "valor": -10.0, "event_time": "2026-10-14T10:00:02Z"}',),
    ('{"pedido_id": "", "valor": 45.0, "event_time": "2026-10-14T10:00:03Z"}',),
    ('{"pedido_id": "P004", "valor": 29.9, "event_time": "2026-10-14T10:00:04Z"}',),
]

bronze = spark.createDataFrame(mensagens, "payload string")
bronze.write.format("delta").mode("errorifexists").save(
    f"{base}/bronze/pedidos"
)
2. Silver: interprete e valide
O contrato espera um identificador, um valor decimal e um horário. O filtro exige identificador preenchido, valor positivo e horário interpretável. P001 e P004 passam; P002 tem valor negativo e a outra mensagem não tem identificador. Os registros rejeitados continuam disponíveis em Bronze, mas uma operação real deve também planejar uma saída de quarentena e métricas de qualidade.
schema = StructType([
    StructField("pedido_id", StringType()),
    StructField("valor", DecimalType(12, 2)),
    StructField("event_time", TimestampType()),
])

entrada = spark.read.format("delta").load(
    f"{base}/bronze/pedidos"
)
interpretados = entrada.select(
    F.from_json("payload", schema).alias("pedido")
).select("pedido.*")

silver = interpretados.filter(
    F.col("pedido_id").isNotNull()
    & (F.length(F.trim(F.col("pedido_id"))) > 0)
    & F.col("valor").isNotNull()
    & (F.col("valor") > 0)
    & F.col("event_time").isNotNull()
)
silver.write.format("delta").mode("errorifexists").save(
    f"{base}/silver/pedidos_validos"
)
3. Gold: prepare o resultado de negócio
Agrupamos os pedidos válidos pela data do evento em UTC. Para esta amostra, o resultado esperado em 14 de outubro de 2026 é dois pedidos válidos, somando 150,40. Bronze contém quatro mensagens, Silver contém dois pedidos e Gold contém uma linha de resumo diário. Esse resultado é derivado das regras e da amostra; não é a saída de um cluster executado pelo site.
validos = spark.read.format("delta").load(
    f"{base}/silver/pedidos_validos"
)
gold = (
    validos.withColumn("dia", F.to_date("event_time"))
    .groupBy("dia")
    .agg(
        F.count("pedido_id").alias("pedidos_validos"),
        F.sum("valor").alias("valor_total"),
    )
)
gold.write.format("delta").mode("errorifexists").save(
    f"{base}/gold/vendas_por_dia"
)

spark.read.format("delta").load(
    f"{base}/gold/vendas_por_dia"
).orderBy("dia").show()
O exemplo supõe uma mensagem por pedido e não implementa deduplicação, cancelamentos ou atualizações. Não some valores de uma Gold diária a cada reprocessamento sem uma estratégia de atualização: isso pode contar o mesmo pedido mais de uma vez. Defina chave de negócio, grão, fuso horário e tratamento de correções antes de levar o pipeline à produção.
Lakehouse com Delta não é Lakebase
A distinção do infográfico é importante: Lakehouse com Delta descreve uma arquitetura analítica e suas tabelas. Lakebase é um banco Postgres gerenciado integrado à plataforma Databricks, voltado também a aplicações transacionais de baixa latência. Os dois podem se integrar, mas não são nomes intercambiáveis para a mesma tecnologia.[6]
Cuidados para sair do exemplo e operar de verdade
- Defina contratos de dados e regras de negócio verificáveis.
- Preserve origem e rejeitados, com acesso e retenção adequados.
- Planeje repetição de eventos, correções e reprocessamento.
- Monitore volume, rejeição, atraso e falhas entre as camadas.
- Controle permissões, evolução de esquema e retenção de versões.
Conclusão
Organizar dados do bruto ao valor de negócio significa dar uma responsabilidade a cada etapa. Bronze preserva, Silver prepara e Gold responde a uma necessidade de consumo. Delta acrescenta mecanismos de confiabilidade, mas a qualidade depende também do contrato, das transformações e da operação do pipeline.
Continue acompanhando a Continuous Learning Company para aprender, praticar e evoluir em engenharia de dados.
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 20 conteúdos concluídos
Você concluiu: ✓ Lakehouse com Delta: do dado bruto ao valor de negócio
Quiz: confira o que você aprendeu
Responda às seis perguntas e confira as explicações.
1. Qual é o papel principal da camada Bronze?
Resposta correta: A) Preservar a entrada bruta e sua rastreabilidade.
Bronze preserva a origem; Silver e Gold refinam os dados para outros usos.
2. O que o controle de esquema não garante sozinho?
Resposta correta: B) Que todo valor respeite as regras de negócio.
Um valor negativo pode ter um tipo decimal correto e ainda ser inválido para o negócio.
3. Em qual camada fica o resumo de vendas por dia deste exemplo?
Resposta correta: C) Gold.
Gold organiza o resumo destinado ao consumo; Silver mantém os pedidos válidos em detalhe.
4. Qual é o resultado esperado da amostra após as validações?
Resposta correta: D) Dois pedidos e 150,40.
Somente P001 e P004 passam; seus valores são 120,50 e 29,90.
5. Qual afirmação distingue corretamente Lakebase de Lakehouse com Delta?
Resposta correta: A) Lakebase é um banco Postgres gerenciado; Lakehouse com Delta é uma arquitetura analítica com tabelas.
Lakebase pode integrar-se ao lakehouse, mas não é o mesmo componente nem o mesmo conceito.
6. Por que usamos errorifexists nas escritas da demonstração?
Resposta correta: B) Para falhar se o destino já existir, evitando sobrescrita.
A demonstração não deve sobrescrever uma tabela existente; reexecuções exigem um destino de teste novo.
Referências oficiais
Documentação consultada em 14/10/2026. Verifique a compatibilidade do Spark e do Delta no ambiente escolhido.