Spark Structured Streaming: processe eventos com PySpark e Delta
Entenda micro-lotes, checkpoint, estado e watermark. Acompanhe um exemplo de pedidos da loja, da leitura do Kafka à gravação dos registros válidos em Delta.
13/10/2026 Engenharia de Dados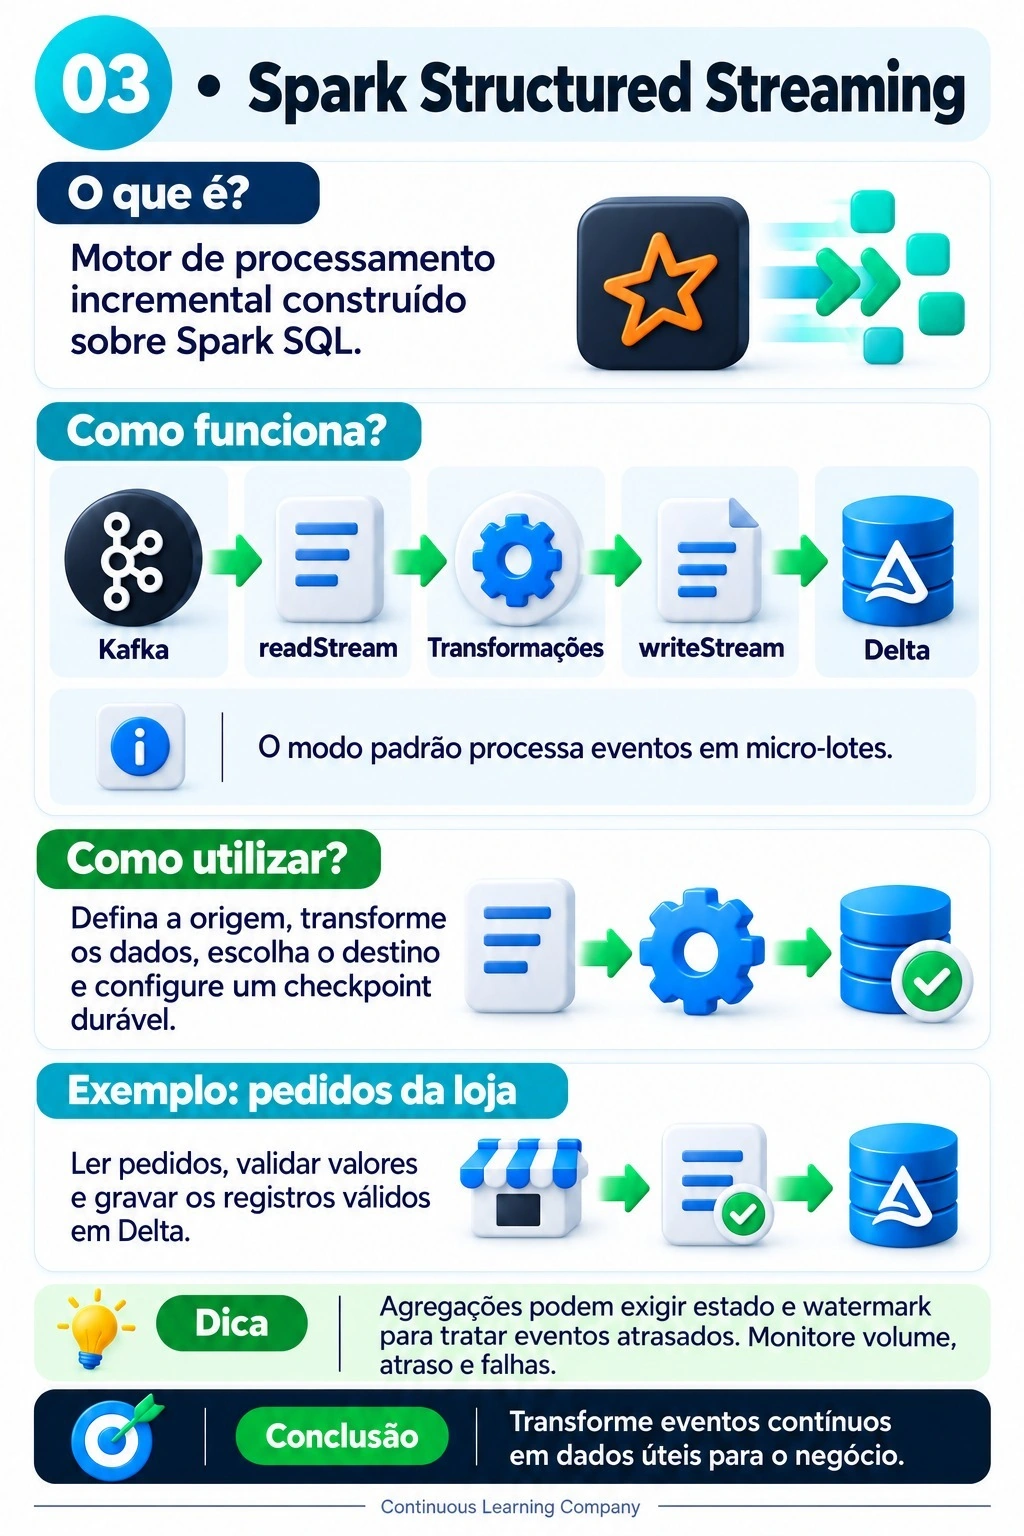
Uma loja recebe pedidos durante todo o dia. Se a análise esperar até o fim do expediente, o estoque, os alertas e os indicadores poderão trabalhar com informações defasadas. O desafio não é apenas receber mensagens: é transformar os dados conforme eles chegam.
Esta publicação aprofunda o processamento com Spark Structured Streaming. A integração geral entre Kafka e Spark já foi apresentada em outro conteúdo da CLC; aqui, o foco está na consulta incremental, na validação dos pedidos e nos cuidados de operação.
O que é Spark Structured Streaming?
É o motor de processamento incremental do Apache Spark construído sobre Spark SQL. Com a API de DataFrames, podemos descrever transformações de maneira semelhante ao processamento em lote, enquanto o motor atualiza o resultado com os novos dados.[1][3]
Uma forma de visualizar esse modelo é imaginar uma tabela que continua recebendo linhas. A consulta não precisa esperar que essa tabela esteja “terminada”: ela trabalha sobre um fluxo de entrada potencialmente sem fim.[3]
Kafka, Spark e Delta têm papéis diferentes. Neste exemplo, Kafka é a origem de eventos, Spark aplica a consulta e Delta é o destino de armazenamento. Structured Streaming não é outro nome para Kafka.[2][4]
Como funciona: pequenos lotes, continuamente
O modo padrão de execução usa micro-lotes: o fluxo é tratado como uma sequência de pequenos trabalhos em lote. Isso não significa que cada evento é necessariamente processado isoladamente, nem que a latência será sempre igual em qualquer ambiente.[1]
O percurso do infográfico pode ser lido assim: Kafka → readStream → transformações → writeStream → Delta. A leitura identifica a origem, as transformações definem as regras e a escrita inicia a consulta que entrega os resultados.[2][4]
É possível configurar um intervalo entre micro-lotes com trigger(processingTime="5 seconds"). Esse intervalo não promete que todo lote terminará em cinco segundos; processamento, volume e infraestrutura influenciam o andamento da consulta.[5][3]
Antes de começar: origem, schema, destino e checkpoint
- Origem: defina o tópico Kafka e o endereço dos brokers. As mensagens devem seguir um contrato de dados conhecido.[2]
- Schema: declare os campos e tipos esperados. Neste exemplo, cada pedido tem identificador, valor e horário do evento.
- Destino: escolha onde ficará a tabela Delta e confirme as permissões de leitura e gravação.[4]
- Checkpoint durável: reserve um caminho persistente e próprio da consulta. Ele registra progresso e, nas operações que mantêm estado, informações necessárias à recuperação.[3]
Pense no checkpoint como o marcador de um trabalho em andamento, não como uma cópia dos pedidos para análise. Evite apagá-lo, usar uma pasta temporária ou compartilhar a mesma pasta entre consultas diferentes. Mudanças em uma consulta também precisam respeitar as regras de compatibilidade de recuperação.[3]
Exemplo prático: pedidos válidos da loja
Nosso objetivo é ler mensagens JSON do tópico pedidos, interpretar os campos e gravar apenas registros com identificador preenchido, valor maior que zero e horário válido. Usamos um tipo decimal para representar o valor no contrato deste exemplo.
Pré-requisitos: sessão spark inicializada, conectores Kafka e Delta compatíveis com a versão instalada, acesso ao tópico e caminhos persistentes de armazenamento. Substitua broker:9092 e os caminhos /dados/... pelos valores do seu ambiente. Em produção, configure autenticação e acesso sem embutir credenciais no código.[2][4]
O bloco abaixo é um exemplo para executar em um ambiente Spark configurado. O site não executa um cluster Spark nem conecta seu navegador ao Kafka.
from pyspark.sql import functions as F
from pyspark.sql.types import (
    StructType, StructField, StringType,
    DecimalType, TimestampType,
)

# Sessão Spark já configurada com os conectores Kafka e Delta.
spark.conf.set("spark.sql.session.timeZone", "UTC")

schema = StructType([
    StructField("pedido_id", StringType()),
    StructField("valor", DecimalType(12, 2)),
    StructField("event_time", TimestampType()),
])

origem = (
    spark.readStream
    .format("kafka")
    .option("kafka.bootstrap.servers", "broker:9092")
    .option("subscribe", "pedidos")
    .option("startingOffsets", "earliest")
    .load()
)

pedidos = (
    origem.select(
        F.from_json(
            F.col("value").cast("string"), schema
        ).alias("pedido")
    )
    .select("pedido.*")
)

validos = pedidos.filter(
    F.col("pedido_id").isNotNull()
    & (F.length(F.trim(F.col("pedido_id"))) > 0)
    & F.col("valor").isNotNull()
    & (F.col("valor") > 0)
    & F.col("event_time").isNotNull()
)

query = (
    validos.writeStream
    .format("delta")
    .outputMode("append")
    .option("checkpointLocation", "/dados/checkpoints/pedidos_validos")
    .trigger(processingTime="5 seconds")
    .start("/dados/delta/pedidos_validos")
)

# Em um script, mantenha o processo ativo.
# Em notebook, monitore query em outra célula.
query.awaitTermination()
O campo value recebido do Kafka é convertido em texto e interpretado como JSON. Depois, o filtro aplica as regras do contrato. A saída usa append, pois cada pedido aprovado é acrescentado à tabela, sem uma agregação que atualize resultados anteriores.[2][4]
startingOffsets="earliest" define o início de uma consulta nova a partir dos eventos ainda disponíveis. Ao retomar uma consulta com checkpoint, o progresso salvo orienta a continuidade; essa opção não força a releitura de tudo a cada reinício.[2]
Importante: filtrar registros inválidos não é o mesmo que corrigir os dados. Neste exemplo didático eles ficam fora da tabela de válidos. Em uma implementação real, planeje uma saída de rejeitados ou preserve os eventos brutos para investigar os problemas.
Que registros devem passar?
Considere estas quatro mensagens de teste, com horários em UTC:
{"pedido_id": "P001", "valor": 120.5, "event_time": "2026-10-13T10:00:00Z"}
{"pedido_id": "P002", "valor": -10.0, "event_time": "2026-10-13T10:00:02Z"}
{"pedido_id": "", "valor": 45.0, "event_time": "2026-10-13T10:00:03Z"}
{"pedido_id": "P004", "valor": 29.9, "event_time": "2026-10-13T10:00:04Z"}- P001: deve ser gravado; tem identificador, valor positivo e horário válido.
- P002: deve ser rejeitado pelo filtro porque o valor é negativo.
- Identificador vazio: deve ser rejeitado, mesmo com valor positivo.
- P004: deve ser gravado.
O resultado esperado é dois pedidos válidos: P001 e P004. Isso descreve as regras do exemplo, não a saída de um cluster conectado ao site.
Estado e watermark: quando os dados chegam atrasados
O filtro anterior analisa cada linha. Já uma soma de vendas por janela de tempo precisa manter resultados intermediários entre micro-lotes: esse é um exemplo de processamento com estado.[3]
O horário em que o pedido aconteceu pode ser diferente do horário em que ele chegou ao processamento. Para agregações por tempo do evento, o watermark ajuda a tratar atrasos e limitar por quanto tempo determinados estados precisam permanecer disponíveis.[3]
Por exemplo, podemos agrupar os valores em janelas de cinco minutos e configurar dez minutos de tolerância ao atraso:
# Exemplo complementar; não inicia uma segunda consulta.
resumo = (
    validos.withWatermark("event_time", "10 minutes")
    .groupBy(F.window("event_time", "5 minutes"))
    .agg(F.sum("valor").alias("valor_total"))
)
O watermark acompanha o avanço do tempo dos eventos observados, e não um cronômetro iniciado quando a aplicação ligou. Eventos suficientemente atrasados podem deixar de contribuir para resultados cujo estado já foi encerrado. Essa configuração não corrige registros inválidos e não precisa ser adicionada ao filtro simples anterior.[3]
Esse bloco apenas define outra transformação: para executá-la, seria necessário iniciar uma escrita apropriada, com checkpoint próprio e modo de saída compatível. Em agregações com append, a emissão de resultados finalizados depende do avanço do watermark.[3][4]
O que acompanhar na operação?
Além de “a consulta está ligada?”, acompanhe quantidade de entradas, taxas de leitura e processamento, duração dos micro-lotes, atraso acumulado e falhas. Quando houver operações com estado, observe também suas métricas de tamanho e memória.[3]
query.lastProgress fornece o progresso mais recente e pode retornar None antes do primeiro registro de progresso. query.status ajuda a entender a atividade da consulta. Não trate ausência inicial de progresso como prova de erro.[6][3]
Checkpoint não é deduplicação de negócio. Se a aplicação de origem publicar o mesmo pedido duas vezes como dois eventos, a regra deste exemplo poderá aprovar ambos. Garantias de recuperação e consistência dependem da origem, da consulta e do destino; evitar repetição de um identificador de pedido requer uma regra adicional de negócio.[1][3][4]
Conclusão
Structured Streaming permite expressar o processamento incremental com a API do Spark. Para sair de um exemplo e chegar a uma operação confiável, precisamos alinhar contrato de dados, validações, destino, checkpoint e monitoramento.[1][3]
No caso da loja, o resultado é um caminho claro: receber pedidos, identificar os registros válidos e gravá-los em Delta. Quando surgirem agregações por tempo, estado e watermark entram no planejamento.[3][4]
Continue acompanhando a Continuous Learning Company para aprender, praticar e evoluir em engenharia de dados.
Quiz: confira o que você aprendeu
Responda às seis perguntas e confira a explicação de cada resposta.
1. Sobre qual motor o Structured Streaming é construído?
Resposta correta: A) Spark SQL.
Structured Streaming utiliza o motor Spark SQL para executar as consultas incrementais.
2. Como funciona o modo padrão apresentado no artigo?
Resposta correta: B) Uma sequência de micro-lotes processa os novos dados.
O modo padrão divide o processamento em pequenos lotes sucessivos.
3. Qual é a função principal do checkpoint?
Resposta correta: C) Guardar progresso e informações de recuperação da consulta.
O checkpoint registra o avanço da consulta e, quando aplicável, seu estado; não substitui validações.
4. No exemplo, quais pedidos passam pelo filtro?
Resposta correta: B) P001 e P004.
P002 tem valor negativo; o outro registro rejeitado não possui identificador preenchido.
5. O que o watermark ajuda a administrar?
Resposta correta: A) Atrasos no tempo dos eventos e retenção de estado nas operações compatíveis.
Watermark se relaciona ao tempo dos eventos e ao estado da consulta; não é uma regra de qualidade de valores.
6. Como interpretar lastProgress antes do primeiro progresso?
Resposta correta: C) Ele pode retornar None; é preciso acompanhar também o estado da consulta.
A API documenta que lastProgress pode ser None antes de qualquer atualização de progresso.
Referências oficiais
Documentação consultada em 13/10/2026. Confira a compatibilidade das versões do Spark, Delta e conectores no seu ambiente.
- Apache Spark — Structured Streaming: visão geral
- Apache Spark — integração do Structured Streaming com Kafka
- Apache Spark — DataFrames, estado, watermark, checkpoint e monitoramento
- Delta Lake — leitura e gravação de tabelas em streaming
- PySpark — DataStreamWriter.trigger
- PySpark — StreamingQuery.lastProgress