Apache Flink: O Poder do Processamento de Dados em Tempo Real
Descubra como o Apache Flink permite processar grandes volumes de dados em tempo real com baixa latência, alta escalabilidade e processamento orientado a eventos.
15/06/2026 Engenharia de Dados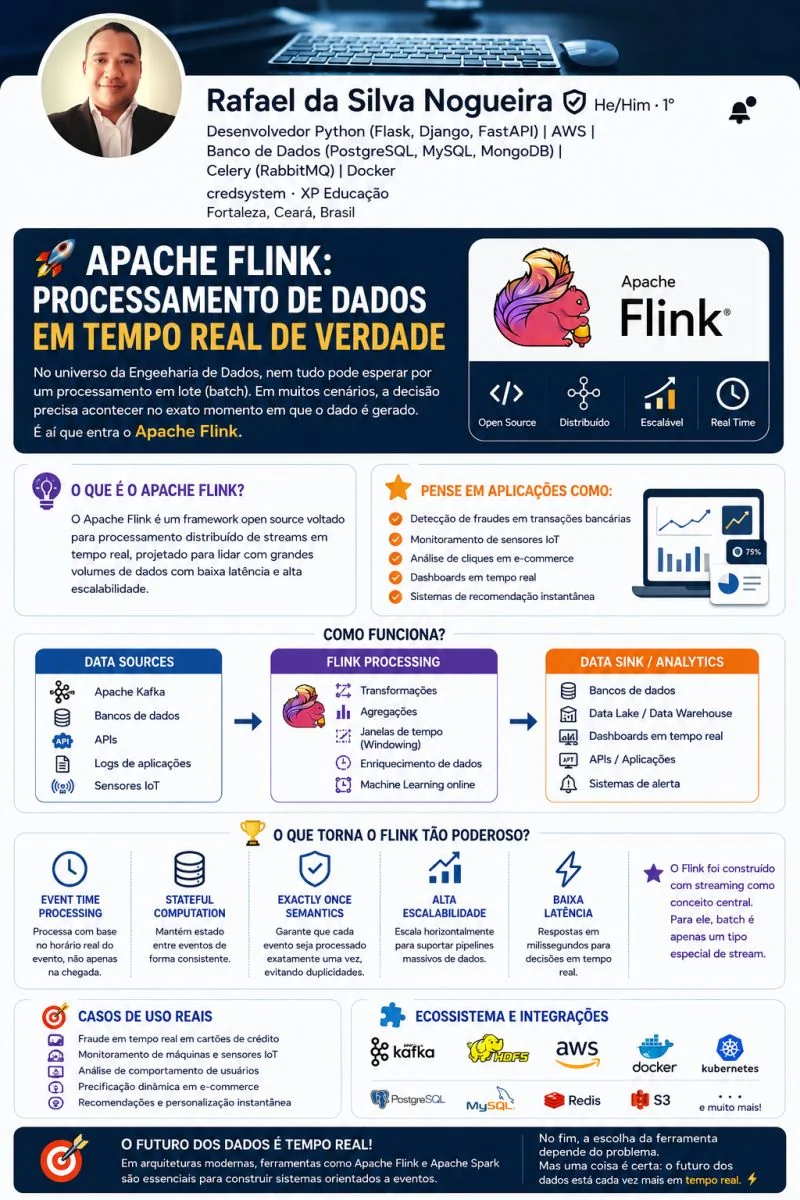
Durante muito tempo, o processamento de dados foi dominado pelo modelo batch, em que as informações são coletadas e processadas em intervalos específicos.
Porém, o crescimento de aplicações digitais trouxe uma nova necessidade: tomar decisões instantâneas com base em dados gerados continuamente.
É nesse cenário que o Apache Flink se destaca.
O Flink é um framework open source voltado para processamento distribuído de dados em tempo real, capaz de analisar fluxos contínuos de eventos com alta performance, baixa latência e grande capacidade de escalabilidade.
O que é o Apache Flink?
O Apache Flink é uma plataforma de processamento distribuído desenvolvida para executar aplicações de streaming e batch em larga escala.
Diferentemente de muitas ferramentas que surgiram inicialmente para processamento em lote e posteriormente incorporaram recursos de streaming, o Flink foi concebido com o processamento de fluxos contínuos como conceito central.
Isso significa que, para o Flink, tudo é tratado como um stream de dados.
Inclusive, um processamento batch pode ser interpretado como um stream finito de eventos.
Como funciona o processamento no Flink?
Uma arquitetura típica utilizando Apache Flink segue o fluxo:
Data Sources → Flink Processing → Data Sink / Analytics
Os eventos podem ser consumidos de diversas fontes:
- Apache Kafka
- Bancos de dados relacionais
- APIs REST
- Arquivos de log
- Sensores IoT
- Filas de mensagens
- Sistemas corporativos
Após receber os eventos, o Flink executa diversas operações em tempo real:
- Filtragem de dados
- Transformações
- Agregações
- Junções (joins)
- Enriquecimento de eventos
- Cálculos estatísticos
- Machine Learning Online
Os resultados podem então ser enviados para dashboards, bancos de dados, data lakes e aplicações analíticas.
Principais características do Apache Flink
Event Time Processing
Uma das funcionalidades mais poderosas do Flink é o processamento baseado no horário real em que o evento ocorreu.
Mesmo quando eventos chegam fora de ordem devido a atrasos de rede, o Flink consegue processá-los considerando o momento correto em que foram gerados.
Isso garante análises muito mais precisas em sistemas distribuídos.
Stateful Computation
O Flink possui suporte nativo a processamento com estado.
Isso permite armazenar informações entre eventos consecutivos, possibilitando análises avançadas.
Exemplos:
- Contagem de acessos por usuário
- Monitoramento de sessões
- Detecção de padrões
- Controle de estoque em tempo real
Exactly Once Semantics
Em ambientes distribuídos, falhas podem ocorrer a qualquer momento.
O Flink oferece garantias de processamento Exactly Once, garantindo que cada evento seja processado exatamente uma vez.
Essa característica é extremamente importante em sistemas financeiros e transacionais.
Alta Escalabilidade
O Flink foi projetado para execução em clusters distribuídos.
Isso permite escalar horizontalmente e processar milhões de eventos por segundo.
Baixa Latência
Enquanto alguns sistemas podem levar minutos para produzir resultados, o Flink consegue responder em milissegundos.
Essa característica é essencial para aplicações que exigem decisões instantâneas.
Casos de uso do Apache Flink
O Flink é amplamente utilizado em aplicações orientadas a eventos.
- Detecção de fraudes em tempo real
- Monitoramento de dispositivos IoT
- Análise de comportamento em e-commerce
- Monitoramento de logs e aplicações
- Dashboards em tempo real
- Sistemas de recomendação instantânea
⚖ Apache Flink vs Apache Spark
Uma comparação bastante comum ocorre entre Apache Flink e Apache Spark.
Embora ambos sejam excelentes ferramentas de processamento distribuído, existem diferenças importantes.
Apache Flink
- Streaming nativo
- Menor latência
- Processamento orientado a eventos
- Gerenciamento avançado de estado
Apache Spark
- Forte em workloads analíticos
- Ecossistema consolidado
- Batch e streaming
- Grande adoção em Big Data
Resumindo
Data Sources → Apache Flink → Processing → Storage / Analytics
O Apache Flink foi criado com o streaming como conceito central.
Sua capacidade de processar eventos continuamente, com baixa latência e alta escalabilidade, o torna uma das ferramentas mais importantes da Engenharia de Dados moderna.
À medida que empresas buscam decisões cada vez mais rápidas, tecnologias como o Flink tornam-se fundamentais para arquiteturas orientadas a eventos.
Mais do que apenas processar dados, o Flink permite construir sistemas capazes de reagir instantaneamente às mudanças do mundo real.
E você?
Já estudou ou utilizou Apache Flink em algum projeto?
Saiba mais:
Apache Flink: https://flink.apache.org/
Documentação Oficial: https://nightlies.apache.org/flink/flink-docs-stable/
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que torna o Apache Flink diferente de ferramentas que originalmente surgiram para processamento batch e depois incorporaram streaming, segundo o artigo?
Resposta correta: A) O Flink foi concebido com o processamento de fluxos contínuos (streaming) como conceito central desde o início.
O artigo explica que, para o Flink, tudo é tratado como um stream, inclusive o processamento batch, visto como um stream finito.
2. O que é o "Event Time Processing" do Flink, segundo o artigo?
Resposta correta: B) O processamento baseado no horário real em que o evento ocorreu, mesmo quando eventos chegam fora de ordem.
O artigo explica que isso garante análises mais precisas mesmo com atrasos de rede.
3. Um banco quer garantir que cada transação seja processada exatamente uma vez, mesmo em caso de falhas em um sistema distribuído. Qual característica do Flink, mencionada no artigo, atende a essa necessidade?
Resposta correta: B) Exactly Once Semantics.
O artigo destaca essa garantia como especialmente importante em sistemas financeiros e transacionais.
4. Segundo a comparação apresentada no artigo, qual é um ponto forte do Apache Spark em relação ao Apache Flink?
Resposta correta: B) Ecossistema consolidado e forte adoção em workloads analíticos e Big Data.
Essas características aparecem na comparação do artigo como pontos fortes do Spark, enquanto o Flink se destaca em streaming nativo e menor latência.