Multiprocessing em Python: paralelismo em uma máquina e seus limites
Entenda processos, Pool, GIL e Lei de Amdahl. Pratique com CSVs, compare resultados e tempos e revise o conteúdo com jogo e quiz.
18/11/2026 Desenvolvimento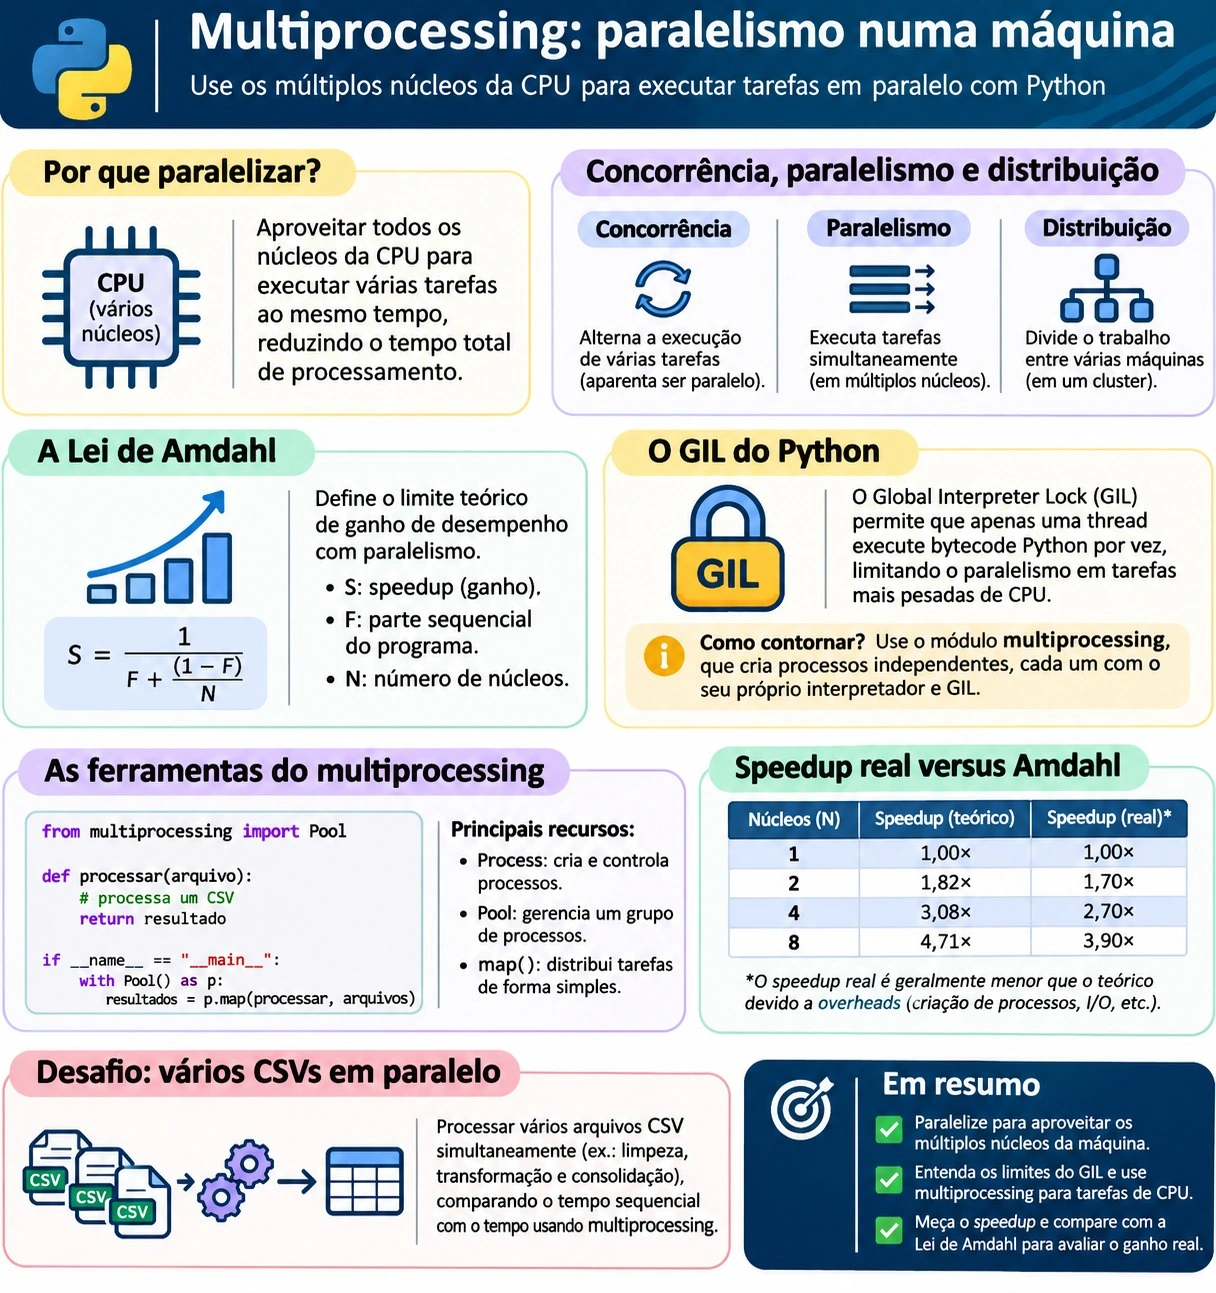
Antes de abrir mais processos, entenda o trabalho
Imagine que uma loja recebeu vários arquivos de estoque. Cada arquivo precisa ser lido, ter suas quantidades multiplicadas pelos preços e produzir um pequeno resumo. Uma pessoa poderia conferir tudo, um arquivo de cada vez. Se as conferências forem independentes, podemos dividir os arquivos entre ajudantes e juntar os resumos ao final. Essa é a ideia que vamos explorar com multiprocessing em Python.
A analogia não significa que dobrar os ajudantes sempre corta o tempo pela metade. É preciso organizar o trabalho, entregar os materiais e reunir as respostas. O objetivo deste artigo é construir uma primeira experiência verificável, não prometer aceleração. O recorte é uma única máquina, complementando os artigos sobre processamento distribuído e clusters.
Concorrência, paralelismo e distribuição não são sinônimos
Concorrência trata de tarefas que avançam em períodos sobrepostos; elas podem alternar numa única unidade de execução. Paralelismo é executar trabalho ao mesmo tempo em recursos distintos. Distribuição descreve a organização do trabalho entre máquinas. Um programa pode combinar essas ideias, mas criar processos locais não cria automaticamente um cluster. A distinção ajuda a escolher a ferramenta sem confundir quantidade de tarefas com capacidade de processamento.[4]
O módulo multiprocessing pertence à biblioteca padrão. Process representa um processo individual; Pool administra um conjunto de processos trabalhadores. O método map aplica uma função aos itens de uma entrada e reúne os resultados na ordem dos itens, mesmo quando o trabalho termina em outra ordem.[1]
O GIL: explique o contexto, não uma proibição universal
No CPython com o GIL habilitado, apenas uma thread por vez executa bytecode Python dentro de um processo. Isso limita o uso de várias threads para cálculos escritos em Python que exigem muita CPU. Já tarefas que passam tempo esperando rede, disco ou outros serviços podem se beneficiar de threads; certas bibliotecas nativas também liberam o GIL durante seu trabalho.[2]
Há ainda builds free-threaded do CPython, disponíveis a partir da versão 3.13, que permitem executar sem o GIL. Eles não tornam qualquer programa automaticamente mais rápido, e a compatibilidade das extensões precisa ser verificada. Por isso, a frase do infográfico sobre o GIL deve ser lida no contexto do CPython com esse bloqueio habilitado, não como uma regra imutável de toda implementação Python.[3]
Separar o trabalho em processos permite usar interpretadores independentes e contornar esse limite do GIL. Isso é uma opção para tarefas de CPU que possam ser divididas, não uma obrigação para todo programa. Nenhum trabalhador fica necessariamente preso a um núcleo específico, e aumentar o número de processos não cria mais capacidade física.[1]
Lei de Amdahl: a parte sequencial continua existindo
No modelo de Amdahl para um problema de tamanho fixo, o ganho ideal é limitado pela parte que não conseguimos paralelizar. Vamos chamar de F a fração sequencial do tempo original e de N a quantidade de recursos de processamento usados pelo modelo. A parte paralelizável é um menos F. O ganho ideal é um dividido por F mais a parte paralelizável dividida por N. O modelo simplifica comunicação, coordenação e outros custos.[4]
Modelo ideal: S(N) = 1 / [F + (1 − F)/N]. Nesta notação, F é a fração sequencial e N é a quantidade de recursos paralelos.
Com F = 0,10: N=2 → 1,82×; N=4 → 3,08×; N=8 → 4,71×. Não inclui os custos reais do programa.
Como exercício, suponha que dez por cento do tempo original continue sequencial. O modelo resulta em aproximadamente um vírgula oitenta e duas vezes com dois recursos, três vírgula zero oito com quatro e quatro vírgula setenta e uma com oito. Esses números são cálculos teóricos, não medições desta publicação. Os valores da coluna chamada real no infográfico também não vieram acompanhados de código, máquina e protocolo de teste: vamos tratá-los como ilustrativos.[4]
Exemplo prático: dois CSVs, o mesmo resultado
Vamos reaproveitar uma situação simples de estoque. O primeiro arquivo reúne duas canecas de trinta e cinco reais e três cadernos de doze reais: cento e seis reais. O segundo reúne cinco lápis de dois reais e uma mochila de cento e cinquenta reais: cento e sessenta reais. O valor combinado é duzentos e sessenta e seis reais. Esses são dados fictícios, com preços guardados em centavos inteiros e sem descontos ou valores ausentes.
O programa cria os arquivos numa pasta temporária, calcula os resumos sequencialmente e repete o trabalho com dois processos. A função de cada trabalhador recebe somente o caminho do arquivo e devolve seu nome e total. O leitor DictReader associa os campos do CSV aos nomes do cabeçalho; os valores lidos são convertidos para inteiros antes da multiplicação. A abertura usa newline vazio e codificação UTF-8.[5]
"""Demonstração local: CSVs fictícios, biblioteca padrão, sem ganho garantido."""
import csv
import json
import multiprocessing as mp
import platform
import tempfile
from pathlib import Path
from time import perf_counter


def resumir_csv(caminho):
    total = 0
    with open(caminho, newline="", encoding="utf-8") as arquivo:
        for linha in csv.DictReader(arquivo):
            total += int(linha["quantidade"]) * int(linha["preco_centavos"])
    return Path(caminho).name, total


def main():
    # A criação dos dados não faz parte dos tempos comparados.
    with tempfile.TemporaryDirectory() as pasta:
        amostras = [
            [("Caneca", 2, 3500), ("Caderno", 3, 1200)],
            [("Lápis", 5, 200), ("Mochila", 1, 15000)],
        ]
        caminhos = []
        for numero, linhas in enumerate(amostras, 1):
            caminho = Path(pasta) / f"estoque_{numero}.csv"
            with caminho.open("w", newline="", encoding="utf-8") as arquivo:
                escritor = csv.writer(arquivo)
                escritor.writerow(["produto", "quantidade", "preco_centavos"])
                escritor.writerows(linhas)
            caminhos.append(str(caminho))

        inicio = perf_counter()
        sequencial = [resumir_csv(caminho) for caminho in caminhos]
        tempo_seq = perf_counter() - inicio

        # spawn é explícito: não depende do padrão da plataforma/versão.
        contexto = mp.get_context("spawn")
        inicio = perf_counter()
        with contexto.Pool(processes=2) as pool:
            paralelo = pool.map(resumir_csv, caminhos)
        tempo_par = perf_counter() - inicio

        assert sequencial == paralelo
        print(json.dumps({
            "python": platform.python_version(), "metodo": "spawn", "workers": 2,
            "arquivos": len(caminhos), "resumos_sequencial": sequencial,
            "resumos_paralelo": paralelo,
            "total_centavos": sum(total for _, total in paralelo),
            "tempo_sequencial": tempo_seq, "tempo_paralelo": tempo_par,
            "speedup": tempo_seq / tempo_par,
        }, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
Por que o código precisa desses cuidados?
Salve o exemplo como um arquivo Python com extensão .py e execute pelo terminal, em vez de colá-lo célula a célula. A função resumir CSV fica no nível do módulo para poder ser localizada pelos processos filhos. O bloco que verifica se o módulo é o principal impede que a criação do grupo seja disparada de novo quando um filho importar o arquivo. Exemplos de Pool podem falhar em interpretadores interativos quando a função não é importável.[7]
O exemplo escolhe explicitamente o contexto spawn, que inicia um novo interpretador, em vez de depender do padrão do sistema. Os padrões variam por plataforma e versão; no Python 3.14, fork deixou de ser o padrão em qualquer plataforma. O gerenciador de contexto delimita o uso do grupo. Para uma entrada muito longa, map também pode acumular resultados demais; este exemplo tem apenas dois arquivos.[1]
Não dependemos de uma lista global modificada pelos filhos para obter a resposta. No exemplo, os resultados retornam ao processo principal, que faz a soma. Objetos enviados entre processos precisam respeitar as condições de serialização; caminhos e resumos pequenos tornam esse intercâmbio mais simples do que grandes tabelas. Em aplicações maiores, vale reduzir comunicação e estado compartilhado antes de aumentar o grupo.[7]
Serialização é transformar objetos numa representação que possa ser transferida ou reconstruída. O formato pickle é usado em mecanismos de comunicação entre processos, mas não deve ser tratado como um formato seguro para receber objetos de desconhecidos: desserializar dados maliciosos pode executar código. Este laboratório cria seus próprios dados e processos localmente.[8]
Medir também faz parte de aprender
Usamos perf_counter para medir intervalos de tempo decorrido. A comparação inclui a criação e o encerramento do grupo no trecho paralelo, mas não a geração dos arquivos. O ganho observado é o tempo sequencial dividido pelo paralelo. Se o quociente for menor que um, o paralelo levou mais tempo nesta execução; maior que um indica que levou menos tempo.[6]
Uma execução real registrada, não um benchmark: Python 3.11.16, contexto spawn, 2 trabalhadores, 2 CSVs e 4 linhas. Tempos em segundos; incluem início e encerramento do Pool, não a criação dos CSVs. Sem controle de cache de disco ou garantia de repetibilidade dos tempos.
{
  "python": "3.11.16",
  "metodo": "spawn",
  "workers": 2,
  "arquivos": 2,
  "resumos_sequencial": [
    [
      "estoque_1.csv",
      10600
    ],
    [
      "estoque_2.csv",
      16000
    ]
  ],
  "resumos_paralelo": [
    [
      "estoque_1.csv",
      10600
    ],
    [
      "estoque_2.csv",
      16000
    ]
  ],
  "total_centavos": 26600,
  "tempo_sequencial": 0.00016329999994013633,
  "tempo_paralelo": 0.5160142709999036,
  "speedup": 0.00031646411566041134
}
Na execução registrada desta amostra minúscula, a versão com processos levou mais tempo. O resultado não contradiz a utilidade do paralelismo: criar interpretadores e organizar o trabalho pode custar mais do que somar quatro linhas. Esta verificação demonstra equivalência e o custo do caminho completo neste ambiente, não constitui um estudo de desempenho nem prevê o comportamento de arquivos grandes.
Também não isolamos o efeito do cache de disco, não medimos o pico de memória e não verificamos todos os sistemas operacionais. Ler os mesmos arquivos primeiro sequencialmente pode influenciar a rodada seguinte. Use os tempos como observação desta execução, não como comparação universal entre técnicas.
Laboratório guiado: mude uma coisa por vez
Primeiro, execute o arquivo completo e confira se os dois caminhos devolvem os mesmos resumos e o mesmo total. Depois altere apenas o número de trabalhadores e compare novamente. Como há somente dois arquivos, criar muitos trabalhadores não significa ter tarefas suficientes para mantê-los ocupados.
Em seguida, aumente cuidadosamente a quantidade de linhas dos arquivos, mantendo dados que você possa conferir. Registre versão do Python, método de início, quantidade de trabalhadores e volume. Repita cada configuração, alterne a ordem das rodadas e observe a variação. Não coloque esperas artificiais no cálculo para simular uma aceleração de CPU que não foi realmente obtida.
Por fim, tente responder: o programa espera pelo disco ou trabalha principalmente fazendo contas? O custo de abrir processos é significativo? Os resumos continuam pequenos? A memória de todos os trabalhadores cabe no ambiente? Nem toda leitura de CSV é uma tarefa dominada por CPU, e vários leitores podem disputar o mesmo disco. Meça o caso real antes de escolher a arquitetura.[2][7]
Da divisão das tarefas à decisão técnica
A sequência útil é entender o cálculo, produzir uma versão correta, escolher partes independentes, retornar resultados pequenos e comparar. Multiprocessing é uma ferramenta para esse caminho, não um atalho que dispensa validação. Para explorar o raciocínio antes de mudar o código, use o jogo e depois responda ao quiz. Ambos são atividades didáticas; o jogo não executa Python nem mede o computador.
Jogo: organize os processos
Simulação didática em JavaScript; não executa Python nem mede CPU.
Quiz: processos, resultados e limites
Responda às seis questões e confira as explicações.
1. Qual situação é candidata a processos para buscar paralelismo de CPU?
Resposta correta: A) Cálculos independentes em Python, num CPython com GIL habilitado.
Cálculos independentes podem ser divididos; o ganho depende de volume, comunicação e ambiente.
2. O que Pool.map faz neste exemplo?
Resposta correta: B) Aplica a função aos caminhos e devolve os resultados na ordem de entrada.
A ordem dos resultados é preservada, mas a execução e a conclusão das tarefas podem ter outra ordem.
3. Por que proteger a criação do Pool com if __name__ == "__main__"?
Resposta correta: C) Para impedir que o código principal de criação rode novamente ao importar o módulo no filho.
Com spawn, o módulo precisa poder ser importado com segurança. Funções de trabalho devem ser importáveis.
4. Qual é o total dos dois arquivos fictícios?
Resposta correta: D) R$ 266,00.
O primeiro resumo soma 10600 centavos; o segundo, 16000. Juntos são 26600 centavos.
5. Se tempo sequencial dividido pelo paralelo for menor que um, o que foi observado?
Resposta correta: A) O paralelo levou mais tempo nessa execução.
O custo de iniciar e coordenar processos pode superar o trabalho útil numa amostra pequena.
6. Como interpretar os números da coluna real do infográfico?
Resposta correta: B) Como ilustração, pois não há protocolo de benchmark fornecido.
Para medir de verdade é preciso registrar dados, ambiente, método, repetições e custos incluídos.
Referências oficiais
Consultadas em 18/11/2026. Documentação Python 3.14 para os conceitos atuais e Python 3.11 para o ambiente executado. O infográfico original foi preservado; a explicação qualifica o GIL e identifica seus números de desempenho como ilustrativos. O tutorial LLNL foi consultado por trecho indexado recuperado por busca, pois o acesso direto devolveu HTTP 500.
- multiprocessing: contextos, Pool e processos
- threading: GIL e tarefas de entrada e saída
- CPython: builds free-threaded
- LLNL: introdução à computação paralela e Lei de Amdahl
- csv: DictReader e leitura de arquivos
- time: perf_counter
- multiprocessing no Python 3.11: boas práticas e segurança da importação
- pickle: serialização de objetos Python