Cluster: máquinas, partições e tarefas sem confusão
A equipe não é o lote de trabalho. Entenda cluster, nós, partições e tarefas com a analogia de um laboratório de prótese e um exercício de agendamento.
22/10/2026 Engenharia de Dados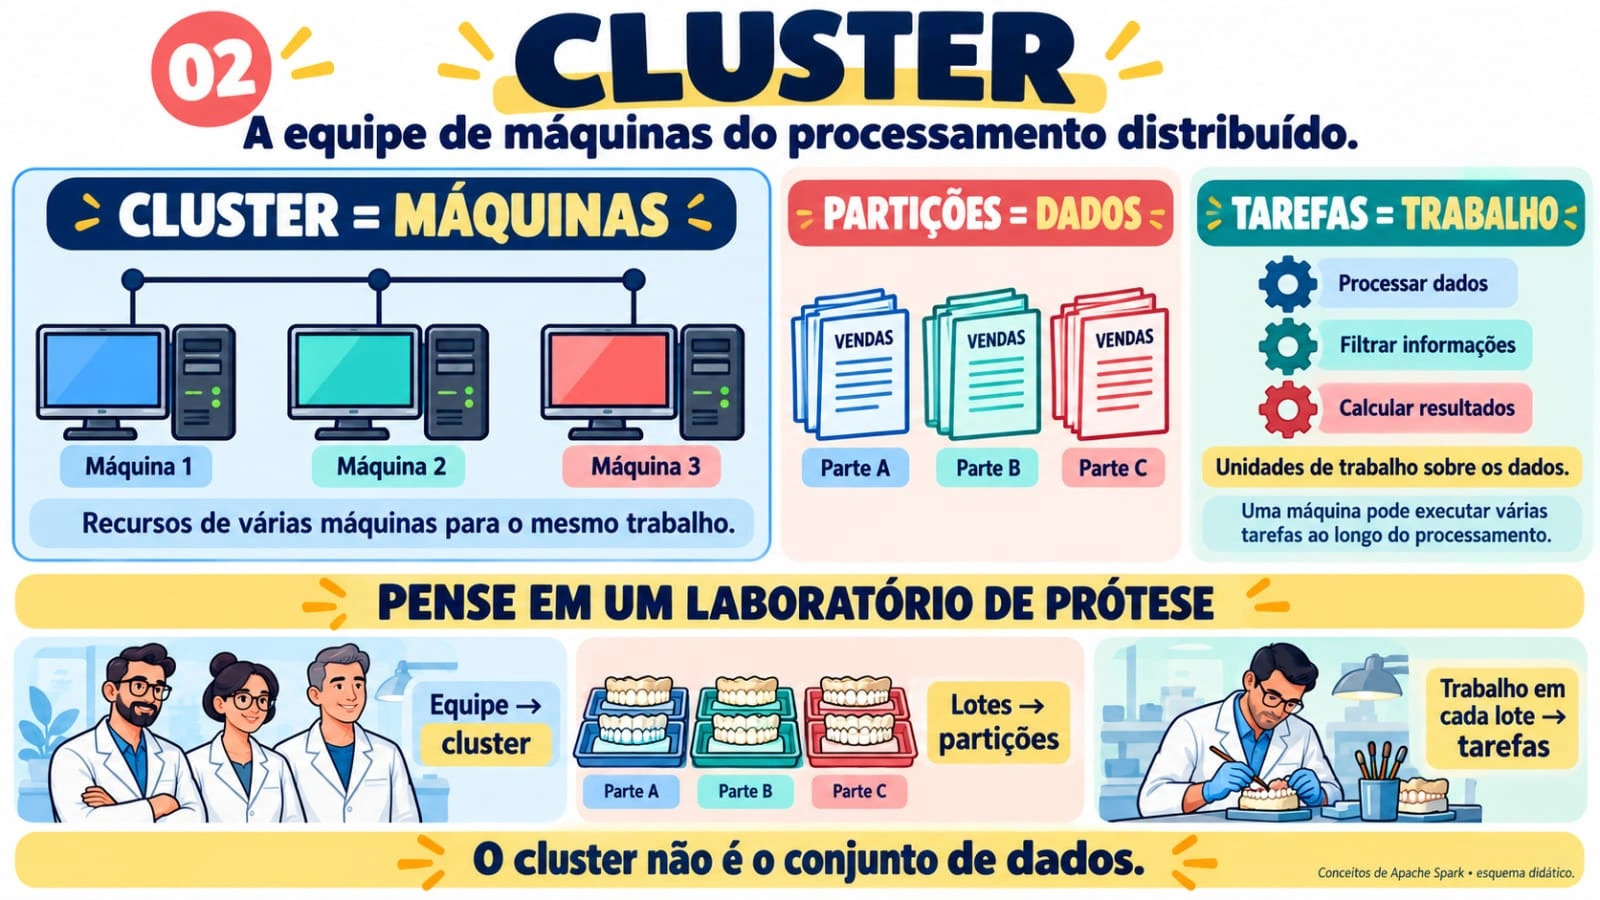
A equipe não é o lote de trabalho
Pense em um laboratório de prótese que recebeu vários pedidos. Temos a equipe, os lotes a organizar e as atividades necessárias em cada lote. Os profissionais não são os pedidos, e o ato de conferir um lote não é o lote em si. Essa separação ajuda a entender três palavras que aparecem juntas em engenharia de dados: cluster, partição e tarefa.
Já acompanhamos a divisão e a combinação de resultados em Processamento distribuído. Agora o foco muda: vamos distinguir os recursos que executam o trabalho, os dados que serão processados e as unidades de execução. Assim, este conteúdo complementa o anterior sem repetir o cálculo do faturamento.
Máquinas conectadas que colaboram.
Partes processáveis do conjunto.
Unidades de execução sobre os dados.
Cluster: a equipe de máquinas disponível
Neste contexto, cluster é um conjunto de máquinas conectadas e coordenadas para oferecer recursos à execução de aplicações. Cada máquina participante é um nó; ela pode ser física ou virtual. Processamento, memória e comunicação entre os nós entram nessa organização. O cluster não é o arquivo de vendas, a tabela de pedidos nem a soma calculada sobre eles.[1]
O título do infográfico, “cluster = máquinas”, funciona como um lembrete didático. Não basta reunir computadores sem comunicação, configuração e coordenação para ter uma execução distribuída funcionando. Também não há garantia automática de alta disponibilidade, armazenamento permanente dos dados ou aceleração proporcional ao número de máquinas. Essas propriedades dependem da arquitetura e da aplicação.[1][6]
Partições: os lotes de dados, não os computadores
Uma partição é uma parte do conjunto de dados que o motor pode processar. Na analogia, ela corresponde a um lote de pedidos, não a um profissional. Separamos os registros em partes A, B e C para facilitar a explicação, mas esses nomes não são uma reserva de máquina. A parte C pode esperar e ser processada depois por uma máquina que acabou de terminar A.[2][4]
Por isso, três partições não significam três máquinas. Uma aplicação pode ter mais partições do que recursos disponíveis para executar tarefas ao mesmo tempo. O número e a distribuição das partições também podem mudar ao longo do plano. A figura apresenta relações entre conceitos; não é uma captura de uma execução real do Spark.[1][2][4]
Tarefas: o que precisa ser feito sobre os dados
Filtrar informações, interpretar campos e calcular resultados são exemplos de trabalho. No Spark, uma tarefa é uma unidade de execução enviada a um executor. Um estágio pode ter tarefas que operam sobre as partições; operações encadeadas podem compartilhar uma tarefa, e a consulta pode exigir vários estágios. Não devemos transformar cada verbo da figura em uma tarefa independente obrigatória.[1][2]
Uma máquina pode atender várias tarefas ao longo do processamento. Dependendo dos núcleos, dos processos e das configurações, também pode haver mais de uma tarefa em execução simultânea no mesmo nó. No exercício desta página, limitamos cada máquina fictícia a uma tarefa por vez apenas para enxergar a fila e as rodadas; isso não é uma regra do Spark.[1][6]
Onde entram Driver, executor e gerenciador do cluster?
O nó é a máquina; o executor é um processo que executa tarefas e pode manter dados da aplicação. O Driver coordena a aplicação e o agendamento das tarefas. O gerenciador do cluster participa da alocação dos recursos. Máquinas, processos, dados e tarefas são camadas diferentes. Para aprofundar a arquitetura, consulte Driver, Cluster Manager, Executors e Tasks.[1]
Exemplo: duas máquinas e três partes de pedidos
Vamos usar seis pedidos fictícios de um laboratório. A parte A contém P01 pronto e P02 pendente. A parte B contém P03 pronto e P04 cancelado. A parte C contém P05 e P06 prontos. A pergunta é simples: quantos pedidos estão com status pronto? É uma organização de registros para estudo, não uma orientação clínica nem um sistema real de laboratório.
Temos duas máquinas disponíveis, M1 e M2, e três tarefas didáticas: filtrar o status e contar os registros de cada parte. Na primeira rodada, M1 atende A e M2 atende B. Depois que M1 fica livre, ela atende C. Os resultados parciais são um, um e dois; combinados, chegam a quatro pedidos prontos. A equipe continuou sendo de duas máquinas, embora houvesse três partes de dados.
Esse roteiro de rodadas é uma simplificação. Não medimos tempo nem demonstramos paralelismo com o pequeno exemplo. A mensagem importante é que a mesma máquina pode executar trabalhos diferentes ao longo do tempo: não é preciso comprar um computador novo para cada lote.
Experimento local: confira o agendamento em Python
O código abaixo foi executado durante a preparação desta publicação. Ele percorre uma agenda fictícia e verifica as contagens; não conecta máquinas, não cria um cluster e não usa threads para fazer trabalhos simultâneos. A divisão explícita serve para acompanhar quem atende cada parte.
# Simulação sequencial: não cria máquinas nem executa Spark.
particoes = {
    "A": [("P01", "pronto"), ("P02", "pendente")],
    "B": [("P03", "pronto"), ("P04", "cancelado")],
    "C": [("P05", "pronto"), ("P06", "pronto")],
}
# Duas máquinas fictícias atendem três tarefas em duas rodadas.
rodadas = [[("M1", "A"), ("M2", "B")], [("M1", "C")]]
parciais = {}
for numero, rodada in enumerate(rodadas, 1):
    for maquina, parte in rodada:
        assert parte not in parciais  # não repetir uma contribuição
        quantidade = sum(status == "pronto" for _, status in particoes[parte])
        parciais[parte] = quantidade
        print(f"Rodada {numero}: {maquina} processa {parte}: {quantidade} pronto(s)")
assert set(parciais) == set(particoes)
total_prontos = sum(parciais.values())
print(f"Pedidos prontos no total: {total_prontos}")
Saída real do exercício Python local:
Rodada 1: M1 processa A: 1 pronto(s)
Rodada 1: M2 processa B: 1 pronto(s)
Rodada 2: M1 processa C: 2 pronto(s)
Pedidos prontos no total: 4
Experimente mover a parte C para M2 na segunda rodada. O total deve continuar quatro: trocar o recurso que executa uma tarefa não muda a regra de contagem. Depois, altere P02 para pronto; o parcial de A e o total devem aumentar em uma unidade. Essa comparação ajuda a separar mudança de infraestrutura de mudança nos dados.
Laboratório guiado: o que local[2] realmente significa
Se você tiver Spark e Java configurados, pode investigar o mesmo filtro com o exemplo abaixo. O modo local com duas threads usa a máquina em que o processo foi iniciado; não cria dois computadores. Reparticionar os dados em três partes também não provisiona nós. Em um cluster real, o destino da aplicação e os recursos precisam ser configurados pelo mecanismo de implantação.[3][4]
A sintaxe deste exemplo foi compilada, mas ele não foi executado com Spark nesta publicação. O resultado quatro é a expectativa derivada dos seis registros. Execute somente em um ambiente de teste; não copie uma configuração local para uma aplicação de produção sem avaliar seu ambiente.
from pyspark.sql import SparkSession, functions as F

# Use um ambiente de teste com Spark e Java já configurados.
# local[2] usa duas threads locais; não provisiona duas máquinas.
spark = SparkSession.builder.master("local[2]").appName("cluster-didatico").getOrCreate()
dados = [("P01", "pronto"), ("P02", "pendente"),
         ("P03", "pronto"), ("P04", "cancelado"),
         ("P05", "pronto"), ("P06", "pronto")]
pedidos = spark.createDataFrame(dados, "pedido_id string, status string").repartition(3)
prontos = pedidos.filter(F.col("status") == "pronto")
prontos.explain(mode="formatted")
print(prontos.count())  # Resultado esperado nesta amostra: 4.
spark.stop()
Observe o plano com explain e, ao executar em seu ambiente, examine as tarefas e os executores pela interface do Spark. Compare o filtro, as partições e os recursos disponíveis. A operação count solicita a contagem dos registros restantes. Os nomes e o desenho dos estágios dependem da versão e das otimizações, não dos nomes A, B e C do nosso exercício.[1][2][5]
Mais máquinas não corrigem qualquer gargalo
Aumentar os recursos pode ajudar, mas o ganho depende do trabalho. Distribuição desigual de dados, movimentação pela rede, memória insuficiente e coordenação podem limitar a execução. Antes de crescer o cluster, observe o que está esperando: dados, CPU, memória, comunicação ou uma tarefa especialmente pesada. A existência de várias máquinas não resolve automaticamente a causa da espera.[2][6]
Leve três perguntas para o próximo projeto
Quando alguém disser “o cluster está ocupado”, pergunte quais recursos estão ocupados. Quando mostrar uma partição, identifique quais registros ela contém. Quando falar em tarefa, procure a operação que está sendo executada. Na analogia do laboratório: equipe, lotes e atividades colaboram, mas não são a mesma coisa. Agora experimente distribuir três partes entre duas máquinas no jogo e revise as diferenças no quiz.
Jogo: organize o trabalho do cluster
Simulação didática local: escolha uma partição, atribua uma tarefa a uma máquina livre e conclua o trabalho. Duas máquinas podem atender três partições em rodadas. Aqui, cada máquina atende uma tarefa por vez; isso não é uma regra do Spark.
Pedidos prontos:
Quiz: cluster, partições e tarefas
Responda às seis questões e confira as explicações.
1. O que representa o cluster neste conteúdo?
Resposta correta: B) As máquinas e seus recursos organizados para executar o trabalho.
O cluster é a infraestrutura de recursos; não é o conjunto de dados nem o resultado.
2. Na analogia do laboratório, a que correspondem os lotes de pedidos?
Resposta correta: C) Às partições dos dados.
A equipe corresponde aos recursos, os lotes às partições e as atividades às tarefas.
3. Três partições exigem três máquinas?
Resposta correta: A) Não; uma máquina pode atender tarefas de várias partições ao longo do tempo.
A quantidade de partes dos dados não determina uma relação fixa de uma máquina por partição.
4. Qual foi o resultado do exercício de pedidos prontos?
Resposta correta: D) Quatro: os parciais foram um, um e dois.
Filtrar pelo status pronto exclui P02 pendente e P04 cancelado; restam quatro pedidos.
5. O que significa local[2] no exemplo PySpark?
Resposta correta: B) Execução local com duas threads, não dois computadores.
O modo local não provisiona máquinas; o particionamento é uma configuração diferente.
6. Qual afirmação distingue corretamente nó, executor e tarefa?
Resposta correta: C) O nó é a máquina; o executor é um processo; a tarefa é uma unidade de execução.
Separar recursos, processos e trabalho evita confundir capacidade de execução com divisão dos dados.
Referências oficiais
Documentação consultada em 22/10/2026. A ilustração é didática; detalhes de execução dependem da configuração e da versão.
- Cluster Mode Overview — Driver, nós, executores e tarefas
- RDD Programming Guide — partições e unidades de trabalho
- Submitting Applications — modo local e gerenciadores de cluster
- PySpark DataFrame.repartition — partições não são máquinas
- PySpark DataFrame.count — contagem de registros
- Spark Job Scheduling — recursos e escalonamento
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Cluster: máquinas, partições e tarefas sem confusão