Processamento distribuído: das partes ao faturamento total
Acompanhe as vendas de uma loja: divida os dados, processe cada parte e combine os resultados. Entenda o papel do Driver, dos executores e das tarefas no Spark.
21/10/2026 Engenharia de Dados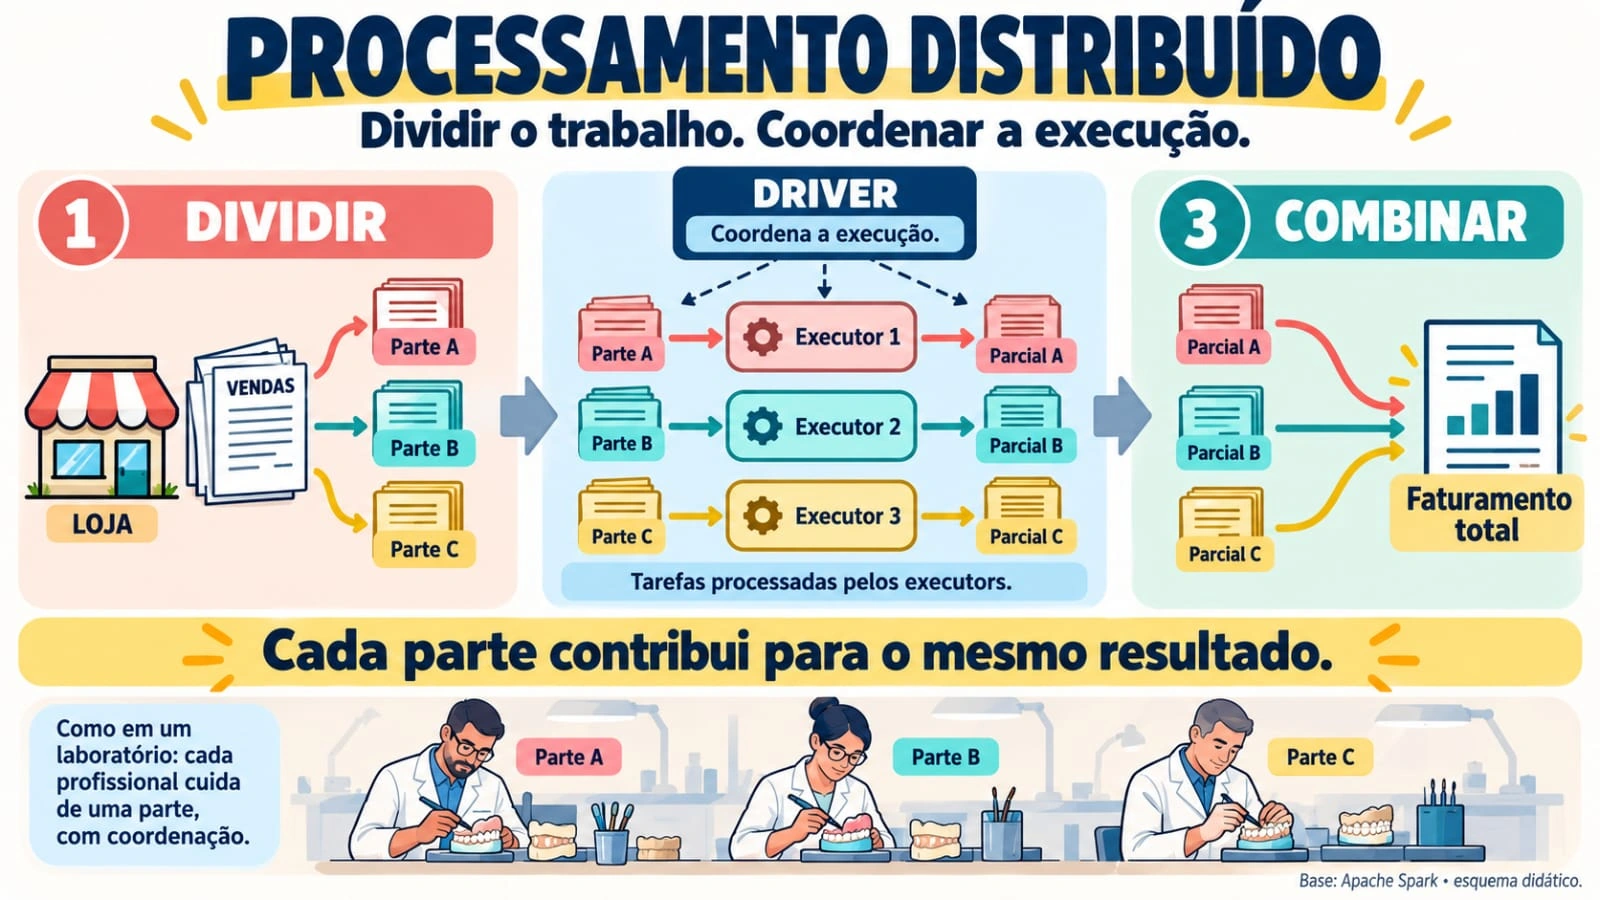
A loja precisa do total, não de três relatórios soltos
Imagine o fim do dia em uma loja. As vendas estão registradas, mas alguém precisa descobrir o faturamento total. Se o conjunto crescer muito, uma única máquina pode deixar de dar conta do trabalho com o tempo e os recursos disponíveis. Em vez de concentrar tudo nela, podemos organizar o cálculo em partes que colaboram para responder à mesma pergunta.
É esse caminho que vamos acompanhar: primeiro separar as vendas, depois calcular resultados parciais e, por fim, combiná-los. Para conhecer as peças da plataforma, veja também Arquitetura do Apache Spark. Para comparar formas de crescer a infraestrutura, consulte Escalabilidade Vertical vs Horizontal. Aqui, o foco é entender o cálculo acontecendo de ponta a ponta.
Separe os dados em partes processáveis.
Execute tarefas e produza resultados parciais.
Reúna os parciais para responder à pergunta.
O que realmente está sendo distribuído?
No processamento distribuído, diferentes processos ou máquinas colaboram em um trabalho. No Spark, os dados são organizados em partições, e tarefas operam sobre essas partes. Isso não é simplesmente copiar a tabela completa para cada computador: a intenção é repartir o trabalho e coordenar as dependências entre suas etapas.[1][2]
Uma partição não é uma máquina, e uma tarefa não é um executor. Um executor pode processar várias tarefas ao longo da aplicação; quantas conseguem rodar juntas depende dos recursos e do agendamento. Por isso, as três partes da ilustração são uma simplificação didática, não uma regra de que todo programa precisa ter exatamente três executores.[1]
Dividir só ajuda quando cada parte tem uma responsabilidade clara
Vamos usar seis vendas e separá-las em três grupos. A parte A contém cento e vinte reais e cinquenta centavos e vinte e nove reais e noventa centavos. A parte B contém duzentos reais e quarenta reais. A parte C contém oitenta e nove reais e sessenta centavos e vinte reais. Cada venda entra em uma única parte deste exercício; assim, não perdemos registros nem contamos o mesmo registro duas vezes.
Esse tamanho pequeno serve para acompanhar o raciocínio. Em um sistema real, a distribuição depende dos arquivos, das operações e do plano de execução. A organização manual usada aqui não pretende reproduzir exatamente como o Spark posicionará essas seis linhas.
Enquanto uma parte é processada, outra também pode avançar
Com as partes definidas, cada tarefa calcula sua contribuição. A parte A chega a cento e cinquenta reais e quarenta centavos; a B, a duzentos e quarenta reais; a C, a cento e nove reais e sessenta centavos. Ainda não temos a resposta completa da loja, mas já reduzimos cada conjunto a um subtotal. Essa soma em etapas ajuda a compreender uma agregação distribuída.[2][6]
O Driver coordena a aplicação e o envio das tarefas. Os executores realizam o processamento; o gerenciador do cluster participa da alocação de recursos. Coordenar não significa trazer todas as vendas ao Driver e fazer nele o cálculo inteiro. A combinação também pode ser uma etapa executada no cluster.[1][2]
Agora os parciais precisam responder à mesma pergunta
Somando os três subtotais, o resultado é quinhentos reais. O importante não é apenas juntar números: todos precisam representar a mesma medida e o mesmo período. Neste exercício, consideramos seis vendas válidas do mesmo fechamento, sem devoluções ou repetições. Em um cenário real, esses critérios de negócio precisam ser definidos antes de chamar o resultado de faturamento.
Somas podem ser combinadas dessa forma. Já uma média exige cuidado: se os grupos tiverem quantidades diferentes de vendas, fazer a média simples das médias pode produzir uma resposta errada. Para combinar uma média, preserve pelo menos a soma e a contagem de cada grupo. Distribuir o cálculo não dispensa entender a medida que você quer obter.
Experimente o raciocínio em Python, sem precisar de um cluster
O exercício abaixo usa centavos inteiros para manter a soma monetária exata nesta amostra. Ele foi executado localmente durante a preparação desta publicação. É uma simulação sequencial das partes, não uma demonstração de ganho de velocidade nem de execução em várias máquinas.
# Exercício local: simula partes, sem distribuir em máquinas.
partes = {
    "A": [12050, 2990],
    "B": [20000, 4000],
    "C": [8960, 2000],
}
# Os valores estão em centavos inteiros.
parciais = {nome: sum(valores) for nome, valores in partes.items()}
total_centavos = sum(parciais.values())

def reais(centavos):
    return f"R$ {centavos // 100},{centavos % 100:02d}"

for nome, subtotal in parciais.items():
    print(f"Parte {nome}: {reais(subtotal)}")
print(f"Faturamento total: {reais(total_centavos)}")
Saída real do exercício Python local:
Parte A: R$ 150,40
Parte B: R$ 240,00
Parte C: R$ 109,60
Faturamento total: R$ 500,00
Para praticar, acrescente uma venda de dez reais à parte C. Recalcule primeiro esse subtotal e depois o total geral. Compare com a soma direta de todas as vendas: as duas respostas devem coincidir. Se você incluir a mesma venda duas vezes, o cálculo muda — o paralelismo, por si só, não reconhece uma duplicidade de negócio.
Como escrever a mesma pergunta em PySpark
No Spark, declaramos a agregação e deixamos o motor construir o plano. O exemplo abaixo está preparado para um ambiente com Spark e Java configurados. Sua sintaxe foi verificada, mas ele não foi executado em um cluster nesta publicação. Com apenas seis linhas, não é um teste de desempenho nem uma justificativa para adotar um cluster.
from pyspark.sql import SparkSession, functions as F

# Execute em um ambiente com Spark/Java configurados.
spark = SparkSession.builder.appName("faturamento-loja").getOrCreate()
dados = [
    ("P001", 12050), ("P002", 2990),
    ("P003", 20000), ("P004", 4000),
    ("P005", 8960), ("P006", 2000),
]
vendas = spark.createDataFrame(
    dados, "pedido_id string, valor_centavos long"
).repartition(3)

resumo = vendas.agg(F.sum("valor_centavos").alias("total_centavos"))
resumo.explain(mode="formatted")
resumo.show()  # Resultado esperado: uma linha com 50000 centavos.
O resultado esperado é uma linha com cinquenta mil centavos, equivalentes aos quinhentos reais do exercício. A função de soma descreve a agregação; a chamada de exibição solicita o resultado. O plano físico permite investigar como essa pergunta foi transformada em trabalho.[2][5][6]
Reparticionar em três partes não reserva três máquinas, não fixa um executor para cada grupo e não garante os mesmos grupos A, B e C. As etapas posteriores e a execução adaptativa podem ajustar o particionamento. Consulte o plano e as tarefas da execução em vez de deduzir o desenho real apenas desse número.[1][3]
Laboratório guiado: observe a combinação, não apenas a resposta
Se tiver um ambiente Spark disponível, execute o exemplo e inspecione o plano formatado. Procure as etapas de agregação e, quando houver, a movimentação de dados entre elas. Os nomes dos operadores e o desenho do plano variam conforme a versão e a otimização; a figura é uma explicação do conceito, não uma captura de uma execução específica.[3][5]
Evite coletar a tabela inteira no Driver só para calcular o total em Python. A operação de coleta traz os registros para a memória do processo que recebe o resultado e deve ser usada apenas quando o conjunto retornado é pequeno. Neste exemplo, a soma é declarada antes da exibição, de modo que a resposta final seja uma única linha.[4][6]
E se uma parte falhar ou demorar mais que as outras?
Imagine que a parte B não terminou. Combinar apenas A e C daria um total incompleto. Na simulação abaixo, você pode provocar essa falha e tentar novamente; o subtotal só entra uma vez quando a parte fica pronta. É uma forma de visualizar a diferença entre uma nova tentativa e uma nova contribuição para o resultado, sem prometer garantias de escrita de um sistema real.
No Spark, tarefas podem ser reexecutadas e dados podem ser recalculados conforme a operação e os dados disponíveis. Isso não torna qualquer efeito externo automaticamente seguro contra repetição. Também não basta adicionar máquinas para garantir aceleração: tráfego de rede, movimentação de dados e partições desequilibradas podem limitar o ganho. Observe onde está o gargalo antes de aumentar os recursos.[2][3]
O que levar para o próximo projeto
Volte à pergunta da loja: quanto foi vendido no período? A divisão organiza os dados, o processamento produz contribuições e a combinação transforma essas contribuições em uma resposta útil. Quando você consegue explicar o papel de cada etapa, fica mais fácil investigar um resultado incompleto, uma tarefa lenta ou uma soma duplicada. Use o jogo para experimentar esse caminho e o quiz para revisar os conceitos.
Jogo: coordene o faturamento da loja
Simulação local: divida as vendas, processe cada parte e combine os resultados. Experimente uma falha e tente novamente, sem somar a mesma parte duas vezes. Não é um cluster Spark.
Faturamento combinado:
Quiz: revise o caminho do faturamento
Responda às seis questões e confira as explicações.
1. Qual é o objetivo de dividir as vendas em partes?
Resposta correta: B) Repartir o trabalho para produzir contribuições ao mesmo resultado.
As partes colaboram para responder à mesma pergunta; a divisão não garante um fator fixo de aceleração.
2. Como se relacionam partição, tarefa e executor?
Resposta correta: C) A tarefa processa uma parte do trabalho; executores podem executar várias tarefas.
Os dados são particionados; tarefas são unidades de execução, e executores são processos que as executam.
3. Qual é o papel principal do Driver neste contexto?
Resposta correta: A) Coordenar a aplicação e o agendamento das tarefas.
O Driver coordena; a computação e etapas de combinação podem ocorrer no cluster.
4. Qual é o total dos três parciais do exemplo?
Resposta correta: D) R$ 500,00.
R$ 150,40 + R$ 240,00 + R$ 109,60 = R$ 500,00.
5. Por que não coletar uma tabela enorme no Driver para somar em Python?
Resposta correta: B) Porque todos os registros coletados precisam caber na memória de quem recebe o resultado.
Faça a agregação distribuída primeiro e retorne apenas resultados pequenos quando precisar.
6. Se a parte B falhar antes de produzir um resultado válido, o que a simulação deve fazer?
Resposta correta: C) Aguardar uma execução válida de B e incluir seu subtotal uma vez.
Uma tentativa que falhou não deve virar contribuição válida; as garantias de um sistema real dependem da operação.
Referências oficiais
Documentação consultada em 21/10/2026. Os detalhes do plano dependem da versão e da configuração do ambiente.
- Apache Spark — componentes do cluster: Driver, executores e tarefas
- Apache Spark — RDDs, ações, redução e shuffle
- Apache Spark SQL — particionamento, otimização e execução adaptativa
- PySpark — collect e limites de memória do Driver
- PySpark — explain e inspeção do plano físico
- PySpark — função sum para agregação
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Processamento distribuído: das partes ao faturamento total