Split Brain: Consistência vs Disponibilidade no PostgreSQL com Pgpool-II
Quando a comunicação entre os nós falha, dois servidores podem acreditar que são o master ao mesmo tempo. Entenda o que é split brain e por que ele obriga você a escolher entre consistência e disponibilidade.
01/10/2026 Bancos de Dados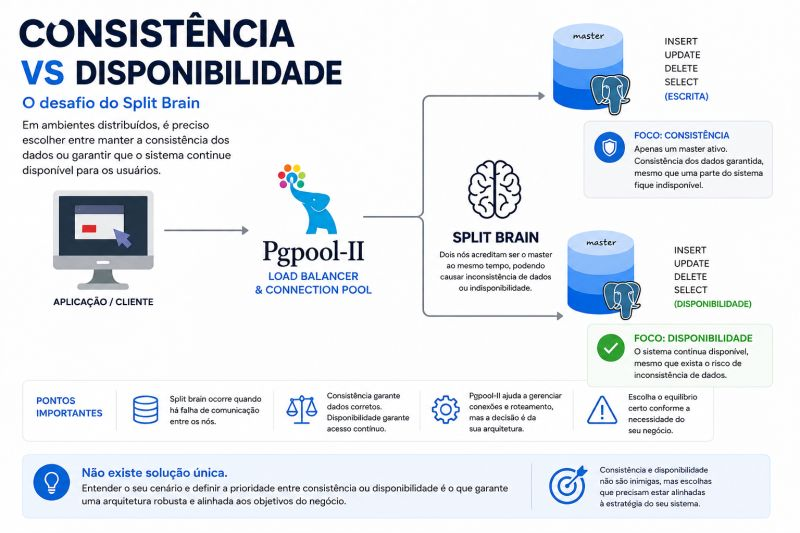
No último artigo, falei sobre failover com Pgpool-II: quando o master cai, uma réplica é promovida e o serviço continua. Mas ficou uma pergunta em aberto: e se o master não caiu de verdade? E se ele só ficou inacessível por causa de uma falha de rede?
É nesse cenário que aparece um dos problemas mais perigosos de ambientes distribuídos: o split brain. E, junto com ele, uma escolha que toda arquitetura precisa fazer: priorizar consistência ou disponibilidade.
O que é split brain?
Split brain ("cérebro dividido") acontece quando dois nós acreditam ser o master ao mesmo tempo. Cada um aceita escritas de forma independente, sem saber da existência do outro.
A causa mais comum é uma falha de comunicação entre os nós, também chamada de partição de rede. Um exemplo:
- O cluster tem um master e uma réplica, em servidores diferentes;
- A rede entre eles falha, mas os dois servidores continuam ligados e funcionando;
- Do ponto de vista da réplica, o master "sumiu", então ela é promovida a novo master;
- O master original continua no ar e segue aceitando escritas das aplicações que ainda conseguem alcançá-lo.
Resultado: dois masters, cada um recebendo INSERT, UPDATE e DELETE diferentes.
Por que isso é tão grave?
Porque os dados começam a divergir. Imagine um sistema de pedidos: parte dos clientes grava no master A, parte grava no master B. Os dois podem gerar o mesmo número de pedido para compras diferentes, ou vender duas vezes a última unidade do estoque.
Quando a rede volta, não existe uma forma automática e segura de juntar as duas histórias. Na prática, alguém precisa escolher um dos lados como verdadeiro e descartar ou reconciliar manualmente as transações do outro. É um tipo de problema que não aparece como erro na hora — ele aparece dias depois, como dado errado.
A escolha: consistência ou disponibilidade
Quando a comunicação entre os nós falha, o sistema não tem como saber se o outro lado caiu ou só está inacessível. Diante dessa dúvida, só existem dois caminhos — é exatamente o que o teorema CAP descreve: durante uma partição de rede, é preciso abrir mão de consistência ou de disponibilidade.
Foco em consistência. Apenas um master fica ativo. Na dúvida, o lado que não tem certeza de ser o master legítimo para de aceitar escritas. Os dados continuam corretos, mas uma parte do sistema fica indisponível até a comunicação ser restabelecida.
Foco em disponibilidade. O sistema continua respondendo dos dois lados, custe o que custar. Nenhum usuário fica sem atendimento, mas existe o risco de inconsistência de dados, que precisará ser resolvida depois.
Nenhuma das duas opções é "a certa". Elas têm custos diferentes:
- Em um sistema financeiro, de estoque ou de faturamento, um dado errado custa mais caro que alguns minutos fora do ar. A prioridade costuma ser consistência.
- Em um catálogo de produtos, feed de conteúdo ou coleta de métricas, ficar fora do ar custa mais do que um dado temporariamente desatualizado. A prioridade costuma ser disponibilidade.
Onde o Pgpool-II entra
O Pgpool-II fica entre a aplicação e o PostgreSQL, gerenciando conexões, roteamento e failover. Como é ele quem decide para qual nó as escritas vão e quando uma réplica deve ser promovida, é também nele que se configura boa parte da proteção contra split brain.
O mecanismo principal é o watchdog com quorum. A ideia é simples: em vez de uma única instância do Pgpool-II decidir sozinha que o master caiu, várias instâncias votam. O failover só acontece se a maioria concordar.
Por isso a recomendação é usar um número ímpar de instâncias (três, por exemplo). Se a rede se dividir em um lado com dois nós e outro com um, só o lado com dois tem maioria e pode agir. O lado isolado sabe que está em minoria e não promove ninguém.
No pgpool.conf, os parâmetros que controlam esse comportamento são:
# Só executa failover se o watchdog tiver quorum
failover_when_quorum_exists = on

# Exige que a maioria dos nós concorde que o backend falhou
failover_require_consensus = on

# Não permite que o mesmo nó vote mais de uma vez
allow_multiple_failover_requests_from_node = off

# Com número par de nós, metade dos votos NÃO é suficiente
enable_consensus_with_half_votes = off

# Detecta e desconecta um falso primário
detach_false_primary = on
Repare que essa configuração é uma escolha por consistência: sem maioria, não há failover, e o sistema prefere ficar parcialmente indisponível a arriscar dois masters. Afrouxar esses parâmetros (por exemplo, ligando enable_consensus_with_half_votes em um cluster de dois nós) move o ponteiro para o lado da disponibilidade — e do risco.
Outras boas práticas
- Isole o master antigo (fencing). Antes de promover uma réplica, o script de failover deve garantir que o master anterior não aceite mais escritas — desligando o serviço, bloqueando o acesso ou removendo o IP virtual.
- Não deixe o master antigo voltar sozinho. Um servidor que reinicia e sobe como master, sem saber que outro foi promovido, é uma causa clássica de split brain. Ele deve voltar como réplica, ressincronizado a partir do novo master.
- Use redes redundantes para o heartbeat. Quanto menos falsos alarmes de "nó caiu", menos chances de uma promoção indevida.
- Avalie replicação síncrona. Com ela, o master só confirma uma transação depois que a réplica a recebeu; isolado, ele deixa de confirmar escritas, o que limita a divergência.
- Teste o cenário de partição. Derrubar um servidor é fácil de testar. Cortar a rede entre dois servidores que continuam ligados é o teste que realmente revela um split brain.
Resumindo
- Split brain ocorre quando há falha de comunicação entre os nós e dois deles passam a agir como master.
- Consistência garante dados corretos; disponibilidade garante acesso contínuo. Durante uma partição, não dá para ter as duas por completo.
- O Pgpool-II ajuda a gerenciar conexões, roteamento e failover, mas a decisão é da sua arquitetura.
- O equilíbrio certo depende da necessidade do seu negócio.
Não existe solução única. Consistência e disponibilidade não são inimigas, mas escolhas que precisam estar alinhadas à estratégia do seu sistema. Entender o seu cenário e definir essa prioridade antes da falha acontecer é o que garante uma arquitetura robusta.
Saiba mais:
Documentação oficial do Pgpool-II: https://www.pgpool.net/docs/latest/en/html/
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. O que é split brain?
Resposta correta: C) Quando dois nós acreditam ser o master ao mesmo tempo.
No split brain, dois nós aceitam escritas de forma independente, o que pode causar inconsistência de dados.
2. Qual é a causa mais comum de um split brain?
Resposta correta: A) Falha de comunicação entre os nós, com ambos ainda em funcionamento.
Quando a rede entre os nós falha, cada lado pode concluir que o outro caiu e passar a agir como master.
3. Em uma arquitetura com foco em consistência, o que acontece durante uma falha de comunicação?
Resposta correta: D) Apenas um master fica ativo, mesmo que parte do sistema fique indisponível.
Priorizar consistência significa aceitar indisponibilidade parcial para garantir que os dados continuem corretos.
4. Como o watchdog do Pgpool-II ajuda a evitar o split brain?
Resposta correta: B) Exigindo quorum: o failover só ocorre se a maioria das instâncias concordar.
Com um número ímpar de instâncias e quorum, o lado em minoria de uma partição não promove um novo master.