Apache Spark: Python, PySpark e o processamento dos dados
Python é a linguagem, PySpark é a API e Spark é o motor. Entenda como transformar uma pergunta sobre vendas em um plano de processamento, com exemplo e prática guiada.
06/11/2026 Engenharia de Dados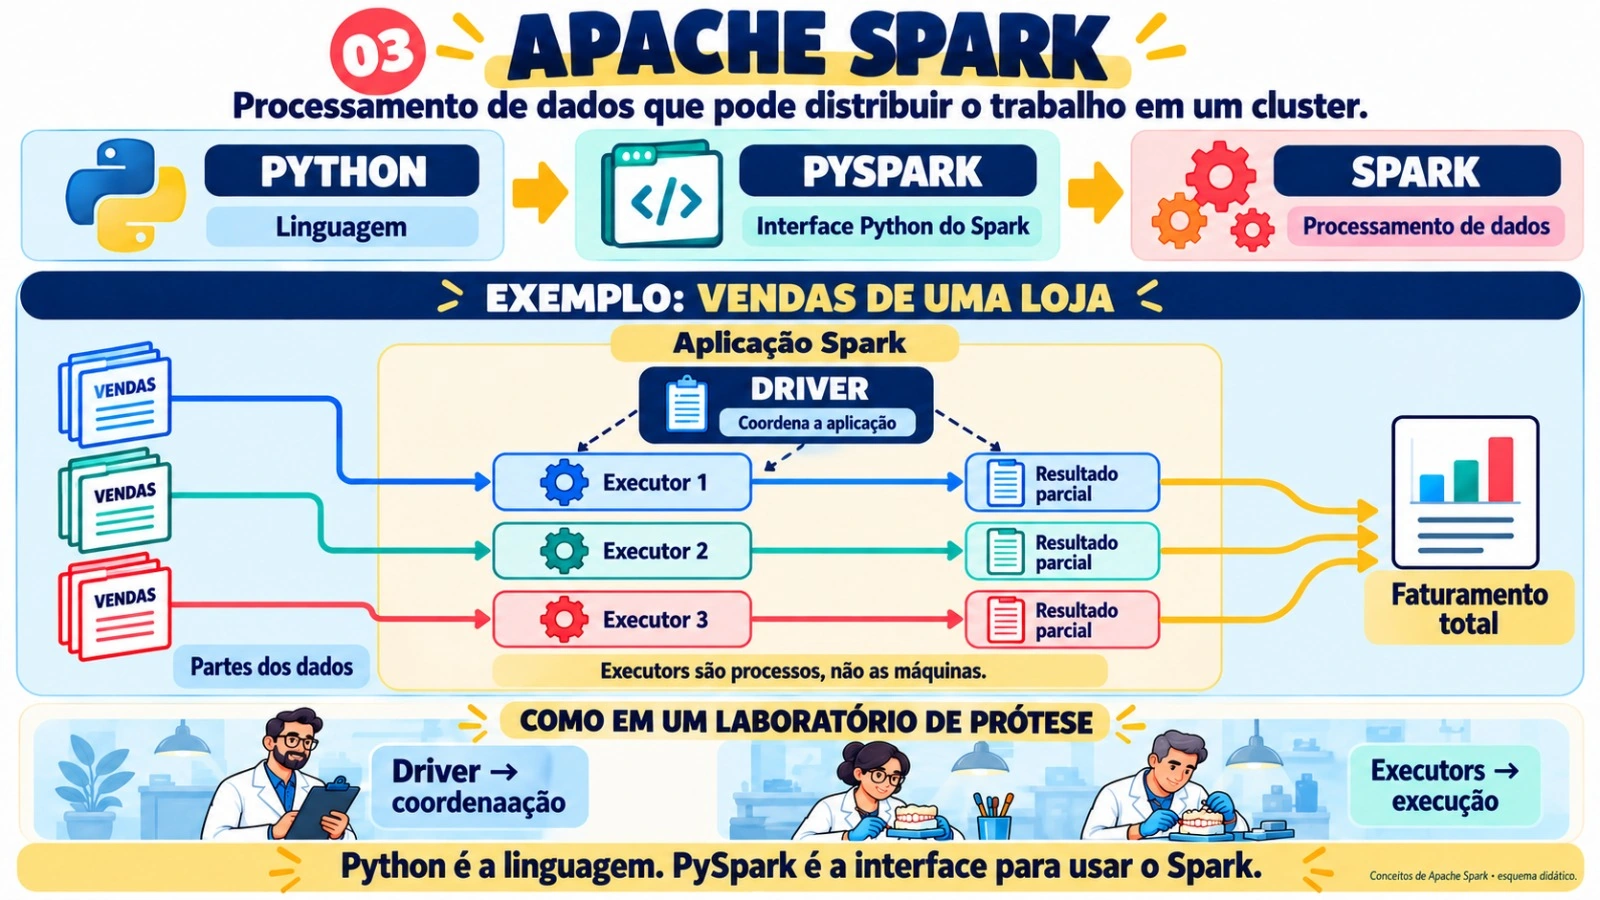
A mesma pergunta, três papéis diferentes
Uma loja quer descobrir quanto vendeu em cada região, considerando apenas as vendas aprovadas. Podemos descrever essa regra em Python. Mas, se quisermos usar o Apache Spark para processar os dados, precisamos de uma forma de conversar com ele. É aí que entra o PySpark. Os três nomes aparecem juntos, mas não são sinônimos: linguagem, API e motor têm responsabilidades diferentes.
O infográfico organiza essa relação como um caminho: Python, depois PySpark, depois Spark. Vamos usar esse caminho para entender a passagem da regra de negócio para a execução. A arquitetura do Spark, o cluster e o processamento distribuído já têm publicações próprias. Aqui, o foco é a ligação entre o código que escrevemos e o plano que processa os dados.
Python, PySpark e Spark: não são a mesma ferramenta
Python é uma linguagem de programação. Com ela, escrevemos condições, funções e programas. Usar Python, por si só, não significa criar um cluster, distribuir dados ou executar uma aplicação Spark. Um laço comum que percorre uma lista continua sendo um programa Python; não se torna distribuído apenas porque a máquina tem vários núcleos.
PySpark é a API Python do Apache Spark: oferece os recursos para construir aplicações Spark usando Python. Nesse contexto, API significa a interface de programação, não obrigatoriamente uma chamada HTTP. Podemos trabalhar com sessões, DataFrames, filtros, agregações e outros recursos. PySpark não é uma linguagem nova e não se limita a instalar um acelerador automático para qualquer programa Python.[1][3]
Apache Spark é o motor de processamento de dados. Ele organiza e executa o trabalho descrito por suas APIs, podendo atuar em um ambiente local ou em um cluster configurado. O ecossistema inclui processamento estruturado, SQL e streaming, entre outras possibilidades. Neste exemplo, vamos ficar com DataFrames e um conjunto estático de vendas, sem misturar conceitos de fluxo contínuo.[1][5]
O que acontece entre escrever a regra e ver o resultado?
Imagine pedir: mantenha apenas as vendas aprovadas, agrupe por região e some os valores. Em vez de descrever manualmente cada máquina e cada tarefa, usamos operações de DataFrame para expressar essa intenção. O Spark pode analisar esse plano e organizar sua execução. Isso não quer dizer que qualquer função Python passa a ser automaticamente uma operação otimizada do Spark.[1][3]
No fluxo clássico mostrado na figura, o Driver coordena a aplicação e o envio de tarefas. Os executores são processos que realizam trabalho para a aplicação; eles não são as próprias máquinas. A disponibilidade de recursos depende do ambiente e de sua configuração. O desenho com três executores é didático: não determina uma exigência de três computadores ou uma correspondência fixa entre cada executor e cada parte dos dados.[2]
A combinação dos resultados também pode ocorrer em etapas nos executores. Não devemos ler as setas como uma obrigação de levar todos os dados brutos para o Driver e somá-los ali. Quando apresentamos um resumo pequeno, faz sentido mostrar algumas linhas ao usuário; isso é diferente de trazer uma tabela enorme inteira para a memória do processo coordenador.[2][3][4]
Exemplo: faturamento aprovado por região
Vamos usar quatro vendas fictícias. No Sul, temos cento e vinte reais e cinquenta centavos e vinte e nove reais e noventa centavos, ambas aprovadas. No Norte, há uma venda aprovada de duzentos reais e outra, cancelada, de quarenta reais. A pergunta inclui uma regra importante: venda cancelada fica fora do faturamento aprovado.
Depois do filtro, o Sul soma cento e cinquenta reais e quarenta centavos e o Norte soma duzentos reais. O total das vendas aprovadas é trezentos e cinquenta reais e quarenta centavos. O objetivo é conferir a regra e compreender o plano, não mostrar ganho de desempenho com quatro registros. Para preservar as casas decimais desta amostra, o código usa valores decimais, e o DataFrame declara esse tipo explicitamente.[6]
Primeiro, confira a regra em Python
O exercício abaixo foi executado em Python durante a preparação desta publicação. Ele é uma referência simples para os resultados esperados. Não executa Spark nem representa uma medição de desempenho distribuído.
from decimal import Decimal

# Dados fictícios. Execução Python local, sem Spark ou cluster.
vendas = [
    ("V01", "Sul", "aprovada", Decimal("120.50")),
    ("V02", "Sul", "aprovada", Decimal("29.90")),
    ("V03", "Norte", "aprovada", Decimal("200.00")),
    ("V04", "Norte", "cancelada", Decimal("40.00")),
]
totais = {}
for venda_id, regiao, status, valor in vendas:
    if status == "aprovada":
        totais[regiao] = totais.get(regiao, Decimal("0.00")) + valor
for regiao, total in sorted(totais.items()):
    print(f"{regiao}: {total:.2f}")
total_geral = sum(totais.values(), Decimal("0.00"))
print(f"Total aprovado: {total_geral:.2f}")
Saída real do exemplo Python local:
Norte: 200.00
Sul: 150.40
Total aprovado: 350.40
Observe a diferença entre contar vendas e somar valores. Uma contagem por região responderia quantas vendas aprovadas existem, não qual é o faturamento. Da mesma forma, somar todas as vendas incluiria a cancelada e responderia uma pergunta diferente. Antes de escolher uma tecnologia, precisamos deixar claro o significado do resultado.
Agora, escreva a mesma intenção com PySpark
No laboratório abaixo, a SparkSession é a entrada para trabalhar com DataFrames. Criamos a tabela com um esquema explícito, filtramos as vendas aprovadas e agrupamos os valores por região. A sintaxe deste exemplo foi validada, mas esta publicação não executou o código em Spark nem em um cluster. Os valores esperados vêm da regra conferida em Python.[3][6]
from decimal import Decimal
from pyspark.sql import SparkSession, functions as F

# Laboratório: Spark e Java precisam estar configurados.
# local[2] usa duas threads locais; não cria duas máquinas.
spark = (SparkSession.builder.master("local[2]")
         .appName("apache-spark-vendas").getOrCreate())
try:
    dados = [
        ("V01", "Sul", "aprovada", Decimal("120.50")),
        ("V02", "Sul", "aprovada", Decimal("29.90")),
        ("V03", "Norte", "aprovada", Decimal("200.00")),
        ("V04", "Norte", "cancelada", Decimal("40.00")),
    ]
    vendas = spark.createDataFrame(
        dados, "venda_id string, regiao string, status string, valor decimal(10,2)"
    )
    aprovadas = vendas.filter(F.col("status") == "aprovada")
    resumo = aprovadas.groupBy("regiao").agg(F.sum("valor").alias("total"))
    resumo.explain(mode="formatted")  # Inspeciona o plano.
    resumo.orderBy("regiao").show()  # Ação: solicita o resultado.
finally:
    spark.stop()
As variáveis aprovadas e resumo representam resultados descritos pelas transformações. Nesse fluxo de DataFrame, filter e groupBy com agregação constroem o plano; não significam, sozinhos, que todo o resultado já foi calculado. A chamada show é uma ação que solicita a apresentação dos resultados e provoca a execução necessária para atendê-la. Esse comportamento é conhecido como avaliação preguiçosa.[3][4]
O explain ajuda a inspecionar o plano e não deve ser confundido com a apresentação do faturamento calculado. Em seu ambiente de teste, compare o plano antes e depois de mudar a regra de filtro. A configuração local com duas threads não provisiona duas máquinas; para executar em um cluster, o ambiente e o destino da aplicação precisam estar configurados.[3][5]
Laboratório guiado: mude uma coisa de cada vez
Primeiro, leia o filtro e preveja qual venda será excluída. Depois, identifique a coluna usada para agrupar e a coluna que será somada. Por último, localize a ação que pede o resultado. Essa leitura em três etapas ajuda a separar a regra de negócio, o plano de transformação e o momento de execução.
Como experimento, troque a venda V04 de cancelada para aprovada. O Norte deve passar a duzentos e quarenta reais e o total aprovado a trezentos e noventa reais e quarenta centavos. Se trocar a soma por uma contagem, explique por que a unidade do resultado também muda. Não compare velocidade entre o laço Python e o Spark usando apenas esses quatro registros.
Como em um laboratório de prótese — com limites
Pense em um responsável que organiza a produção e em profissionais que executam atividades. Essa comparação ajuda a lembrar coordenação e execução. No Spark, o Driver coordena e os executores realizam tarefas. Porém, uma pessoa não é literalmente um processo, e o laboratório não descreve todos os detalhes da arquitetura. A analogia simplifica, mas não substitui a distinção entre máquinas, processos, dados e trabalho.[2]
O que levar para a próxima aplicação
Guarde uma sequência: escreva a intenção em Python, use a API PySpark para expressar operações Spark e observe o plano que o motor vai executar. Depois, confira se o resultado responde à pergunta certa. Mais máquinas não corrigem uma regra de faturamento errada. No jogo a seguir, monte o plano antes de pedir o resultado; no quiz, revise os papéis de cada componente.
Jogo: construa o plano de faturamento
Objetivo: mostrar o faturamento aprovado por região. Monte um filtro e uma agregação; depois solicite o resultado. As quatro vendas são as mesmas do exemplo. Simulação didática em JavaScript: não executa Python nem Spark.
Plano que você está construindo:
Quiz: da linguagem ao resultado
Responda às seis questões e confira as explicações.
1. Qual alternativa separa corretamente os três papéis?
Resposta correta: A) Python é a linguagem, PySpark é a API Python e Spark é o motor.
A linguagem expressa o programa, a API oferece operações e o motor organiza o processamento.
2. No esquema de arquitetura, o que é um executor?
Resposta correta: C) Um processo que executa tarefas para a aplicação.
Executor é processo; nó é máquina. A figura não define uma relação fixa entre eles.
3. O que filter e a agregação fazem neste fluxo de DataFrame?
Resposta correta: B) Descrevem transformações que compõem o plano.
O DataFrame é avaliado de forma preguiçosa; uma ação solicita a execução necessária.
4. Qual chamada pede a apresentação do resultado no exemplo?
Resposta correta: D) show.
show é uma ação. explain inspeciona o plano, sem substituir a apresentação dos dados calculados.
5. Qual é o total aprovado dos quatro registros do exemplo?
Resposta correta: B) R$ 350,40, excluindo V04.
Sul soma R$150,40 e Norte R$200,00; a venda cancelada de R$40,00 fica fora.
6. O que local[2] significa neste laboratório?
Resposta correta: A) Execução local com duas threads, não duas máquinas.
O modo local não provisiona infraestrutura distribuída. Configurar o cluster é outra responsabilidade.
Referências oficiais
Documentação consultada em 06/11/2026. O infográfico e o jogo são esquemas didáticos; a execução depende do ambiente e da versão.