Arquitetura com Pgpool-II: Uma Camada Inteligente entre sua Aplicação e o PostgreSQL
Reunimos tudo o que vimos sobre o Pgpool-II em uma única arquitetura: como a aplicação, o pool de conexões, o nó primário e a réplica trabalham juntos para entregar desempenho, alta disponibilidade e eficiência.
02/10/2026 Bancos de Dados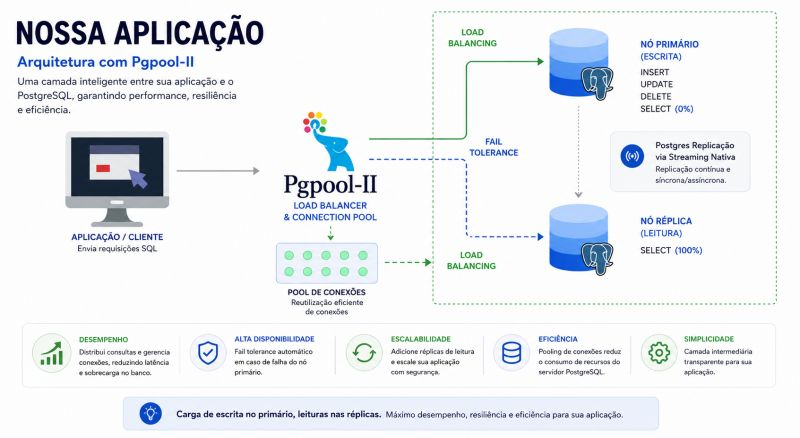
Ao longo desta série de artigos, falamos sobre o que é o Pgpool-II, sobre connection pooling, sobre failover e sobre split brain. Cada texto olhou para uma peça. Agora vamos juntar todas elas e ver a arquitetura completa funcionando.
A ideia é simples: colocar uma camada inteligente entre a aplicação e o PostgreSQL, que cuida de conexões, distribui as consultas e reage a falhas, sem que a aplicação precise saber de nada disso.
Por que não conectar direto ao PostgreSQL?
Uma pergunta justa: se a aplicação já consegue falar com o PostgreSQL, por que adicionar mais uma peça no meio do caminho? Em um projeto pequeno, com um único servidor e poucos usuários, talvez nem faça sentido. Mas, conforme a aplicação cresce, começam a aparecer problemas bem conhecidos:
- Muitas conexões abertas: o PostgreSQL cria um processo para cada conexão. Com centenas ou milhares delas, a memória e o processador do servidor sofrem, mesmo que a maioria esteja ociosa;
- Um único servidor faz tudo: escritas e leituras competem pelos mesmos recursos, e relatórios pesados podem atrasar as operações do dia a dia;
- Uma falha derruba tudo: se o servidor cair, a aplicação fica fora do ar até alguém intervir manualmente;
- A aplicação precisa conhecer a infraestrutura: se for preciso separar leitura de escrita no código, cada mudança de servidor exige alterar e publicar a aplicação.
O Pgpool-II existe justamente para absorver esses problemas em um só lugar, fora do código da aplicação. É isso que o infográfico chama de camada inteligente.
Visão geral: quem é quem
Seguindo o infográfico, da esquerda para a direita, temos estes componentes:
- Aplicação / Cliente: envia as requisições SQL, como faria para um banco comum;
- Pgpool-II: fica no meio, atuando como load balancer e connection pool;
- Pool de conexões: conexões já abertas e prontas para serem reutilizadas;
- Nó primário: recebe as escritas;
- Nó réplica: recebe as leituras;
- Replicação por streaming: mantém a réplica atualizada a partir do primário.
Uma analogia: pense em uma recepção de hospital. Você não escolhe sozinho qual médico vai te atender. A recepção recebe o seu pedido, direciona para a pessoa certa e, se um médico não estiver disponível, encaminha para outro. O Pgpool-II é essa recepção.
1. A aplicação não muda quase nada
Do ponto de vista da aplicação, o Pgpool-II se comporta como se fosse o próprio PostgreSQL. Ela se conecta ao endereço e à porta do Pgpool-II e envia suas consultas normalmente. Essa é a característica de ser uma camada transparente: não é preciso reescrever a lógica da aplicação para separar leitura de escrita.
2. Connection pool: reaproveitando conexões
Abrir uma conexão com o PostgreSQL tem um custo: cada conexão cria um processo no servidor e consome memória. Se a aplicação abrir e fechar conexões o tempo todo, esse custo se acumula.
O pool de conexões resolve isso mantendo conexões abertas e reaproveitando-as entre as requisições. O resultado é menos latência e menos consumo de recursos no servidor PostgreSQL, o que aparece no infográfico como eficiência.
Na prática, o pool é configurado por dois parâmetros principais no pgpool.conf:
num_init_children = 32     # quantos clientes podem ser atendidos ao mesmo tempo
max_pool = 4               # conexões em cache por processo (combinações usuário/banco)
O Pgpool-II mantém num_init_children processos filhos, e cada um pode guardar até max_pool conexões abertas com o PostgreSQL. Isso significa que o total de conexões que o Pgpool-II pode abrir em cada servidor é, no máximo, num_init_children × max_pool, e esse número precisa caber no max_connections do PostgreSQL. Um detalhe importante: uma conexão do pool só é reaproveitada quando o usuário e o banco de dados são os mesmos da nova requisição.
3. Load balancing: escrita no primário, leitura na réplica
Aqui está o coração da arquitetura. O Pgpool-II analisa cada comando SQL e decide para onde enviá-lo:
- Nó primário (escrita): recebe
INSERT,UPDATEeDELETE, porque só o primário aceita escritas; - Nó réplica (leitura): recebe os
SELECT, o que alivia a carga do primário.
No infográfico, o primário aparece com SELECT (0%) e a réplica com SELECT (100%). Isso significa que, nesse desenho, todas as leituras são direcionadas à réplica e o primário fica reservado para as escritas. Essa distribuição é controlada pelo parâmetro backend_weight no pgpool.conf:
backend_hostname0 = 'db-primary'
backend_port0 = 5432
backend_weight0 = 0        # primário: sem leituras

backend_hostname1 = 'db-replica'
backend_port1 = 5432
backend_weight1 = 1        # réplica: recebe as leituras

load_balance_mode = on
Se você tiver várias réplicas, basta ajustar os pesos para dividir as leituras entre elas na proporção que quiser. Lembrando que um SELECT dentro de uma transação que já fez escrita, por exemplo, pode ser enviado ao primário para garantir que você leia o que acabou de gravar.
Exemplo prático: uma loja virtual
Para fixar a ideia, imagine uma loja virtual com a seguinte rotina. Veja para onde o Pgpool-II envia cada comando:
-- Cliente navega no catálogo        → réplica
SELECT nome, preco FROM produtos WHERE categoria = 'livros';

-- Cliente cria o pedido             → primário
INSERT INTO pedidos (cliente_id, total) VALUES (42, 189.90);

-- Estoque é atualizado              → primário
UPDATE produtos SET estoque = estoque - 1 WHERE id = 10;

-- Cliente cancela um item           → primário
DELETE FROM itens_pedido WHERE pedido_id = 1001 AND produto_id = 10;

-- Painel de vendas do dia           → réplica
SELECT SUM(total) FROM pedidos WHERE data = CURRENT_DATE;
Em uma loja real, a grande maioria das requisições é de leitura: navegar, pesquisar, comparar, abrir páginas de produto. Só uma pequena parte vira pedido. Ao mandar toda essa leitura para a réplica, o primário fica livre para tratar as escritas com mais folga, que é justamente a parte mais sensível do sistema.
Repare também que o painel de vendas, que faz uma consulta pesada, roda na réplica. Assim, ele não atrapalha quem está fechando um pedido naquele momento.
Um cuidado: quando o cliente acabou de gravar algo e quer ver o resultado logo em seguida, a leitura precisa enxergar o dado novo. Dentro de uma transação que já fez uma escrita, o Pgpool-II envia as leituras seguintes ao primário, o que garante essa leitura (esse comportamento é controlado pelo parâmetro disable_load_balance_on_write). Já em uma consulta separada, feita logo depois, a réplica pode ainda não ter recebido a mudança e devolver o valor antigo, e é isso que veremos a seguir.
4. Replicação por streaming: mantendo a réplica atualizada
Para que a réplica possa responder consultas, ela precisa ter os mesmos dados do primário. Isso é feito pela replicação por streaming nativa do PostgreSQL: o primário envia continuamente o seu log de transações (WAL) para a réplica, que o aplica.
Ela pode ser assíncrona (mais rápida, mas a réplica pode ficar alguns instantes atrás) ou síncrona (o primário espera a confirmação da réplica, o que dá mais garantia, mas aumenta a latência). Vale lembrar: no modo assíncrono, uma leitura na réplica pode devolver um dado levemente desatualizado, e isso precisa ser aceitável para o seu caso.
Replication lag: o atraso da réplica
Na replicação assíncrona, existe um intervalo entre o momento em que o primário grava um dado e o momento em que a réplica o aplica. Esse intervalo se chama replication lag (atraso de replicação). Na maior parte do tempo ele é de milissegundos, mas pode crescer se a réplica estiver sobrecarregada ou se a rede estiver lenta.
O Pgpool-II consegue monitorar isso e evitar mandar leituras para uma réplica que está muito atrasada:
sr_check_period = 10          # verifica o atraso a cada 10 segundos
sr_check_user = 'pgpool'      # usuário usado para a verificação

delay_threshold = 10000000    # atraso máximo tolerado, em bytes de WAL
Se a réplica ultrapassar o delay_threshold, o Pgpool-II deixa de enviar consultas de leitura para ela e as direciona ao primário, até que a réplica se recupere. É uma forma simples de trocar um pouco de desempenho por dados mais atuais.
5. Fail tolerance: quando algo dá errado
A linha tracejada do infográfico representa a tolerância a falhas. O Pgpool-II monitora a saúde dos nós por meio de health checks. Se o primário falhar, o failover pode promover a réplica a novo primário, e a aplicação continua enviando suas requisições para o mesmo endereço do Pgpool-II.
Detalhes de como configurar isso estão no artigo de failover. E, como vimos no artigo sobre split brain, é importante garantir que o antigo primário não continue aceitando escritas depois da promoção.
A detecção da falha é feita pelo health check, que o Pgpool-II executa periodicamente em cada nó:
health_check_period = 10        # testa cada nó a cada 10 segundos
health_check_timeout = 20       # tempo máximo de espera pela resposta
health_check_max_retries = 3    # tentativas antes de considerar o nó caído
health_check_retry_delay = 1    # intervalo entre as tentativas
health_check_user = 'pgpool'
Quando as tentativas se esgotam, o nó é marcado como indisponível e o failover_command pode ser executado para promover a réplica. Se quem caiu foi a réplica, o cenário é mais simples: o Pgpool-II apenas deixa de enviar leituras a ela, e o primário passa a atender tudo até que a réplica volte.
E se quem cair for o próprio Pgpool-II? Para evitar esse ponto único de falha, ele oferece o watchdog: várias instâncias do Pgpool-II monitorando umas às outras, compartilhando um IP virtual que a aplicação usa para se conectar. Se a instância ativa falhar, outra assume o IP e o serviço continua.
O fluxo de uma requisição, passo a passo
- A aplicação envia uma consulta SQL ao Pgpool-II.
- O Pgpool-II pega uma conexão disponível no pool.
- Ele analisa o comando: se for uma escrita, envia ao primário; se for uma leitura, envia à réplica.
- O PostgreSQL executa e devolve o resultado.
- O Pgpool-II repassa o resultado à aplicação e devolve a conexão ao pool.
- Em segundo plano, o primário replica as mudanças para a réplica por streaming.
O que você ganha com essa arquitetura
- Desempenho: consultas distribuídas e conexões gerenciadas, com menos latência e menos sobrecarga no banco;
- Alta disponibilidade: failover automático em caso de falha do nó primário;
- Escalabilidade: é possível adicionar réplicas de leitura para escalar a aplicação;
- Eficiência: o pooling reduz o consumo de recursos do servidor PostgreSQL;
- Simplicidade: a camada intermediária é transparente para a aplicação.
Cuidados importantes
- O Pgpool-II também pode ser um ponto único de falha. Em produção, ele costuma ser executado em mais de uma instância, com um IP virtual (watchdog) para alternar entre elas.
- Leituras na réplica podem estar atrasadas. Monitore o atraso de replicação (replication lag).
- Teste o failover. Simule a queda do primário em um ambiente de testes antes de depender dele.
- Evite o split brain. Garanta que apenas um nó seja o primário a qualquer momento.
Quando essa arquitetura vale a pena (e quando não)
Como toda decisão de arquitetura, ela tem um custo: mais componentes para instalar, configurar, monitorar e atualizar. Por isso, vale se perguntar se o problema que você tem justifica a solução.
Faz sentido quando:
- a aplicação faz muito mais leituras do que escritas;
- há muitas conexões simultâneas pressionando o servidor;
- o tempo fora do ar é caro para o negócio e é preciso alta disponibilidade;
- você quer crescer adicionando réplicas, sem mexer na aplicação.
Talvez seja exagero quando:
- a aplicação é pequena e um único servidor bem dimensionado resolve;
- a carga é majoritariamente de escrita, caso em que as réplicas ajudam pouco;
- não há equipe para operar e monitorar a infraestrutura adicional.
Checklist para colocar em produção
Antes de levar uma arquitetura como essa para produção, vale conferir:
- a replicação por streaming está funcionando e o atraso está sendo monitorado;
- os pesos (
backend_weight) refletem a distribuição de leitura que você quer; - o produto
num_init_children × max_poolcabe nomax_connectionsdo PostgreSQL; - o health check e o
failover_commandforam testados derrubando o primário em um ambiente de testes; - existe mais de uma instância do Pgpool-II, com watchdog e IP virtual;
- há uma estratégia contra o split brain, para que só um nó seja o primário;
- usuários e senhas ficam fora do código, em variáveis de ambiente ou em um gerenciador de segredos;
- você tem monitoramento e alertas para conexões, atraso de replicação e falhas de nós.
Resumindo
Carga de escrita no primário, leituras nas réplicas. Com o Pgpool-II entre a aplicação e o PostgreSQL, você ganha um conjunto de benefícios sem mudar a lógica do seu código:
- o connection pool reaproveita conexões e economiza recursos;
- o load balancing separa escritas (primário) de leituras (réplica);
- a replicação por streaming mantém a réplica atualizada;
- o failover protege a aplicação em caso de falha do primário.
É uma arquitetura simples de entender e poderosa na prática. Se você ainda não leu os artigos anteriores da série, vale voltar a eles para se aprofundar em cada peça.
Teste seu conhecimento
Responda às perguntas abaixo para revisar os principais pontos deste artigo.
1. Qual é o papel do Pgpool-II nessa arquitetura?
Resposta correta: B) Atuar como camada intermediária, com load balancer e connection pool, entre a aplicação e o PostgreSQL.
Ele fica entre a aplicação e o banco, cuidando de conexões, distribuição de consultas e reação a falhas.
2. No desenho do artigo, para onde vão as escritas (INSERT, UPDATE, DELETE)?
Resposta correta: C) Para o nó primário.
Somente o nó primário aceita escritas; a réplica serve para leituras.
3. O que significa o primário estar com SELECT (0%) e a réplica com SELECT (100%)?
Resposta correta: A) Todas as leituras são direcionadas à réplica, e o primário fica reservado para escritas.
Isso é controlado pelo backend_weight no pgpool.conf: peso 0 no primário e peso 1 na réplica.
4. Qual é a função da replicação por streaming?
Resposta correta: D) Manter a réplica atualizada enviando continuamente as mudanças do primário.
O primário envia o log de transações (WAL) para a réplica, que o aplica.
5. Qual é o principal ganho do connection pool?
Resposta correta: B) Reaproveitar conexões já abertas, reduzindo latência e consumo de recursos.
Abrir conexões é custoso; reutilizá-las deixa o banco mais eficiente.