Spark: RDD e DataFrames na prática
Resolva o mesmo relatório com duas APIs, entenda transformações e ações e aprenda a conferir resultados, planos e limites do Driver.
19/11/2026 Engenharia de Dados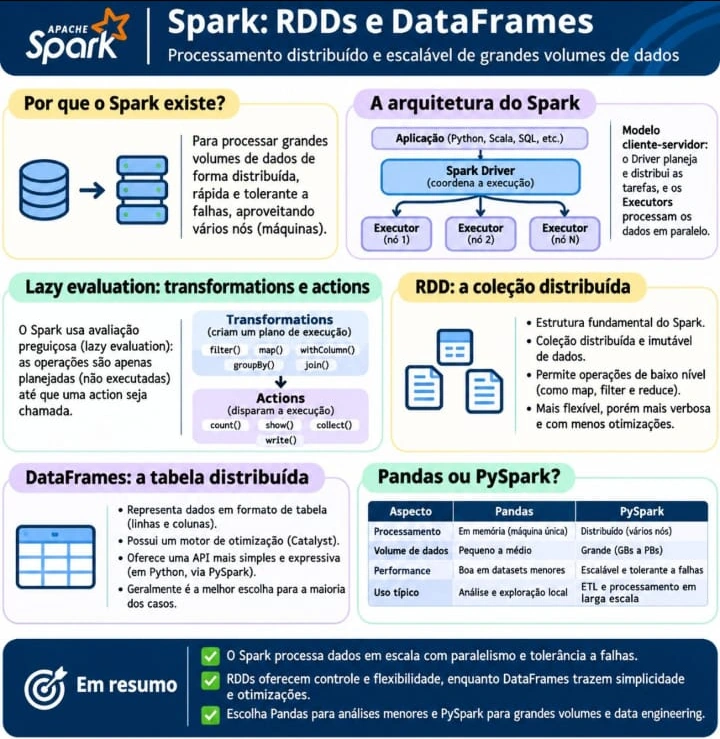
Uma loja precisa somar as vendas aprovadas por região. O problema parece pequeno, mas permite enxergar duas formas de trabalhar com o Apache Spark: manipular registros com RDD ou expressar uma consulta com DataFrame. Vamos usar os mesmos dados nas duas versões e conferir se elas chegam ao mesmo relatório.
Este artigo aprofunda a comparação prática. Para uma primeira apresentação, leia RDD no Apache Spark. A arquitetura do Spark complementa a explicação sobre quem coordena e quem executa o trabalho.
RDD: uma coleção dividida em partições
RDD significa Resilient Distributed Dataset. É uma coleção de elementos distribuída em partições, sobre a qual o Spark pode executar operações em paralelo. Um elemento pode ser, por exemplo, uma tupla com o identificador da venda, a região, o status e o valor em centavos. A API de RDD permite escrever funções que recebem esses elementos e produzem novos resultados. [1]
As operações não alteram o RDD original: uma transformação produz outro RDD, com dependências em relação aos anteriores. Esse histórico permite recomputar partições perdidas em situações previstas pelo sistema. Resiliência não significa que qualquer falha será resolvida, nem substitui armazenamento durável e uma estratégia de recuperação. [1]
Há bastante liberdade para descrever o processamento, mas também mais decisões explícitas no código. Para somar vendas por região, precisamos filtrar as aprovadas, criar pares de região e valor e combinar os valores de cada chave. O Spark não recebe dessas funções Python a mesma informação estruturada que recebe das expressões de uma consulta DataFrame. [1][2]
DataFrame: colunas, tipos e expressões
Um DataFrame do Spark organiza os dados em colunas com nomes e tipos, definidos por um schema. No nosso relatório, região e status são textos; valor em centavos é um inteiro. Podemos pedir ao Spark que filtre uma coluna, agrupe por outra e calcule uma soma, sem escrever uma função Python que manipule cada linha da agregação. [2][6]
Essa estrutura ajuda o mecanismo Spark SQL a analisar a consulta e planejar sua execução. O otimizador trabalha sobre planos de consulta. Isso abre possibilidades de otimização que não são equivalentes a tratar uma função Python arbitrária como uma expressão SQL. Prefira funções nativas para operações tabulares que elas já resolvem. [2][8]
Isso não torna todo DataFrame automaticamente mais rápido ou menor na memória que qualquer RDD. Os dados, as operações, a distribuição das chaves, a serialização e o ambiente influenciam o custo. DataFrame é uma boa escolha inicial para este relatório tabular; a escolha ainda precisa ser avaliada no contexto do trabalho. [1][2][8]
Quem coordena e quem executa
O Driver é o programa que coordena a aplicação. Em um cluster, um gerenciador de recursos permite obter executores, que realizam tarefas e podem manter dados da aplicação. As partições são unidades dos dados; as tarefas executam trabalho sobre elas. O Driver não deve ser apresentado como um servidor HTTP comum que recebe toda a tabela de cada executor. [3]
Também não é necessário ter várias máquinas para experimentar Spark. Nosso laboratório usa o modo local com dois threads de trabalho. Ele demonstra as APIs, mas não comprova desempenho em cluster, tolerância a falhas entre máquinas ou economia de memória em produção. O modelo de implantação e os recursos disponíveis precisam ficar explícitos na avaliação. [3]
Transformações, ações e movimentação de dados
No RDD, filter e map constroem transformações. No DataFrame, o filtro e a agregação compõem uma consulta. A avaliação dessas transformações é adiada: definir a sequência não é o mesmo que materializar o relatório final. Uma ação, como collect, solicita resultados. Isso não quer dizer que criar uma sessão, inferir um schema ou acessar metadados nunca faça trabalho antes. [1][2]
Ao agrupar valores que estão em partições diferentes, pode haver redistribuição de dados, chamada shuffle. Ler menos colunas, reduzir o volume antes de agregações quando a lógica permitir e observar chaves muito concentradas ajuda a investigar o custo. A quantidade ideal de partições não é um número fixo que serve para qualquer aplicação. [1][8]
Collect traz todos os elementos do resultado solicitado para a memória do Driver. Aqui ele é usado somente no resumo de duas regiões. Em uma aplicação real, trazer milhões de linhas para o Driver pode esgotar sua memória; prefira gravar o resultado por meio dos mecanismos distribuídos adequados. [4]
O mesmo relatório de vendas, duas versões
Usaremos cinco vendas fictícias, com valores inteiros em centavos. Duas estão canceladas e não entram no relatório. As vendas aprovadas de São Paulo somam cento e oitenta reais; a do Rio de Janeiro soma noventa reais. O total aprovado é duzentos e setenta reais. Trabalhar com centavos evita introduzir ponto flutuante nesta soma didática.
O código define o schema explicitamente, cria um RDD com duas partições e um DataFrame com os mesmos registros. Na versão RDD, filter mantém o status aprovado. Depois, map produz os pares de região e valor, e reduceByKey soma os valores por região. Só então collect retorna o pequeno resumo para conferência. [1]
Na versão DataFrame, usamos col para acessar o status, groupBy para definir a chave da agregação e sum para somar os centavos. OrderBy organiza a apresentação das regiões. O código compara os resultados das duas APIs, pois executar sem erro não basta para assegurar que a regra de negócio foi preservada. [2][6]
Como reproduzir o exemplo
O ambiente verificado usa Python 3.11, Java 17 e PySpark 3.5.7, em modo local. Prepare o Java 17, configure JAVA_HOME e verifique que o comando java está disponível. Em Linux ou macOS, os comandos abaixo criam um ambiente Python isolado e instalam a versão usada. Salve o código como exemplo_spark.py numa pasta em que você possa gravar o arquivo de plano. No Windows, a ativação do ambiente virtual usa o script Activate.ps1 dentro da pasta Scripts.
java -version
python3 -m venv .venv
. .venv/bin/activate
python -m pip install pyspark==3.5.7
python exemplo_spark.py
"""Mesmo resumo em centavos: RDD e DataFrame, somente execução local."""
import contextlib
import json
from pathlib import Path

from pyspark.sql import SparkSession, functions as F, types as T

DADOS = [
    (1, 'SP', 'aprovado', 12000), (2, 'SP', 'cancelado', 5000),
    (3, 'RJ', 'aprovado', 9000), (4, 'SP', 'aprovado', 6000),
    (5, 'RJ', 'cancelado', 3000),
]
SCHEMA = T.StructType([
    T.StructField('id', T.LongType(), False),
    T.StructField('regiao', T.StringType(), False),
    T.StructField('status', T.StringType(), False),
    T.StructField('valor_centavos', T.LongType(), False),
])


def criar_spark():
    return (SparkSession.builder.master('local[2]').appName('RDD-vs-DataFrame')
            .config('spark.sql.shuffle.partitions', '2')
            .config('spark.ui.enabled', 'false').getOrCreate())


def comparar(spark, dados, plano=None):
    # collect recebe apenas o resumo por região, não as vendas originais.
    origem = spark.sparkContext.parallelize(dados, 2)
    resumo_rdd = (origem.filter(lambda venda: venda[2] == 'aprovado')
                  .map(lambda venda: (venda[1], venda[3]))
                  .reduceByKey(lambda a, b: a + b).collect())
    vendas = spark.createDataFrame(dados, SCHEMA)
    resumo_df = (vendas.filter(F.col('status') == 'aprovado')
                 .groupBy('regiao').agg(F.sum('valor_centavos').alias('total'))
                 .orderBy('regiao'))
    if plano is not None:
        with Path(plano).open('w', encoding='utf-8') as arquivo:
            with contextlib.redirect_stdout(arquivo):
                resumo_df.explain(mode='formatted')
    coletado_df = resumo_df.collect()
    return dict(sorted(resumo_rdd)), {linha.regiao: linha.total for linha in coletado_df}


def main():
    spark = criar_spark()
    try:
        spark.sparkContext.setLogLevel('WARN')
        rdd, dataframe = comparar(spark, DADOS, Path(__file__).with_name('planos_spark.txt'))
        assert rdd == dataframe == {'RJ': 9000, 'SP': 18000}
        assert sum(rdd.values()) == 27000
        print(json.dumps({'rdd': rdd, 'dataframe': dataframe,
                          'total_centavos': sum(rdd.values()),
                          'spark_version': spark.version,
                          'master': spark.sparkContext.master}, ensure_ascii=False))
    finally:
        spark.stop()


if __name__ == '__main__':
    main()
Saída real de verificação, não benchmark: PySpark 3.5.7, modo local[2], cinco registros fictícios e resumo de duas regiões. Não mede desempenho de cluster nem testa falhas de máquinas. As duas APIs devolveram os mesmos valores.
{
  "spark_version": "3.5.7",
  "python_version": "3.11.16",
  "java_version": "openjdk version \"17.0.21.1\" 2026-11-17\nOpenJDK Runtime Environment Temurin-17.0.21.1+2 (build 17.0.21.1+2)\nOpenJDK 64-Bit Server VM Temurin-17.0.21.1+2 (build 17.0.21.1+2, mixed mode, sharing)",
  "master": "local[2]",
  "rdd": {
    "RJ": 9000,
    "SP": 18000
  },
  "dataframe": {
    "RJ": 9000,
    "SP": 18000
  },
  "total_centavos": 27000
}
Leia o plano antes de concluir que algo ficou mais rápido
Explain, no formato formatted, mostra o plano físico e detalhes dos operadores. No relatório, procure o filtro do status, a agregação e as trocas de dados entre partições. Os nomes e a organização dos operadores podem variar com a versão e com decisões do mecanismo de execução. A saída registrada acompanha este laboratório. [5][8]
Ver um operador no plano não mede sua duração. Para comparar desempenho, mantenha dados e resultados equivalentes, registre versões e recursos, considere a inicialização, faça repetições e observe métricas. Cinco vendas servem para entender a lógica; não sustentam uma promessa sobre qual API vence em cargas grandes.
Laboratório: altere uma regra por vez
Primeiro, acrescente uma venda aprovada de vinte reais para São Paulo. Antes de executar, preveja o novo resultado. A região deve chegar a duzentos reais e o total aprovado, a duzentos e noventa. Confira as duas APIs, não apenas uma delas.
Ao alterar os registros, atualize também os resultados esperados nas asserções do programa principal. Para a entrada vazia, use listas e dicionários vazios como expectativa. A função comparar continua executando as duas APIs; a asserção é que precisa refletir a nova regra do exercício.
Depois, mude uma venda cancelada para aprovada e acompanhe qual região muda. Por fim, experimente uma entrada vazia mantendo o schema explícito. O relatório deve ficar vazio nas duas versões. Esses exercícios ajudam a separar uma regra de filtragem correta de uma coincidência nos dados iniciais.
Em dados reais, defina também o tratamento de valores ausentes, status inesperados e registros duplicados. O exemplo usa dados controlados; ele não implementa uma rotina completa de validação financeira. A ordem retornada por um RDD agregado não é um contrato de apresentação: ordene ou compare estruturas por chave quando isso for necessário. [1]
Pandas, PySpark e as simplificações do infográfico
O infográfico organiza os conceitos, mas algumas comparações precisam de contexto. Pandas trabalha principalmente com análise em memória em uma máquina, e operações podem criar cópias intermediárias. Ele também oferece estratégias como seleção de colunas e leitura em partes. PySpark pode executar localmente ou em cluster. Não existe um limite universal em gigabytes que determine sozinho a troca entre as ferramentas. [7][3]
Spark não mantém obrigatoriamente tudo na memória. Persistência depende do nível de armazenamento, e o processamento pode envolver disco. Cache deve ser usado quando houver uma razão para reutilizar resultados, com avaliação do consumo de recursos; não é um botão que acelera qualquer consulta. [1][8]
Por fim, uma coluna com schema não transforma qualquer dado em uma tabela pronta. Mesmo arquivos JSON exigem decisões de leitura, tipos e campos. RDD oferece uma API de menor nível; DataFrame expressa operações estruturadas. Para o relatório que construímos, começar pelo DataFrame facilita escrever a intenção da consulta e inspecionar seu plano. [1][2]
Revisão: resultado, plano e cuidado com o Driver
As duas versões resolvem a mesma regra: considerar somente vendas aprovadas e somar centavos por região. A diferença está em como descrevemos o trabalho e na informação que oferecemos ao Spark para planejá-lo. Confira a equivalência, investigue o plano e limite o que traz para o Driver. Depois, use o jogo e o quiz para praticar essas decisões.
Jogo: construa o relatório Spark
Simulação didática em JavaScript; não executa Spark nem mede desempenho.
Quiz: RDD, DataFrame e decisões de execução
Responda às seis questões e confira as explicações.
1. Por que começar com DataFrame neste relatório de vendas?
Resposta correta: A) As colunas e expressões estruturadas ajudam a descrever e planejar a consulta.
Schema e expressões dão informação ao mecanismo SQL; o desempenho depende da carga e do ambiente.
2. Qual sequência calcula o relatório pedido?
Resposta correta: B) Filtrar vendas aprovadas, agrupar por região e somar centavos.
O filtro deve preservar a regra de negócio: vendas canceladas não entram no faturamento aprovado.
3. O que collect faz?
Resposta correta: C) Retorna todos os elementos do resultado solicitado para o Driver.
Aqui collect recebe só o resumo de duas regiões. Um resultado grande pode esgotar a memória do Driver.
4. Qual é o total aprovado dos cinco registros iniciais?
Resposta correta: D) R$ 270,00.
São Paulo soma 18000 centavos; Rio de Janeiro, 9000. O total é 27000 centavos.
5. O que explain no formato formatted oferece?
Resposta correta: A) Plano físico e detalhes dos operadores.
O plano ajuda a investigar a execução; medir tempo e recursos exige outra avaliação.
6. Como interpretar as comparações de memória e velocidade do infográfico?
Resposta correta: B) Como resumo didático que precisa de contexto sobre carga, ambiente e estratégia.
Spark pode usar disco; Pandas tem estratégias de leitura parcial. Não existe ganho ou limiar de tamanho universal.
Referências oficiais
Consultadas em 19/11/2026. O laboratório fixa Spark 3.5.7 para reprodução; não presume que seja a versão mais recente. A documentação Pandas complementa a comparação. O infográfico original foi preservado; a imagem exibida remove somente as barras da captura de tela. As explicações contextualizam generalizações de velocidade, memória e arquitetura.
- Spark 3.5.7: RDD Programming Guide
- Spark 3.5.7: Spark SQL e DataFrames
- Spark 3.5.7: visão geral do cluster
- PySpark 3.5.7: RDD.collect e memória do Driver
- PySpark 3.5.7: DataFrame.explain
- PySpark 3.5.7: DataFrame.groupBy
- Pandas: escalabilidade para conjuntos de dados maiores
- Spark 3.5.7: ajustes de desempenho SQL