Streaming em três partes: origem, transformação e destino
Entenda readStream, DataFrames e writeStream. Acompanhe pedidos do Kafka até uma tabela Silver em Delta Lake e veja como o checkpoint participa da recuperação.
19/10/2026 Engenharia de Dados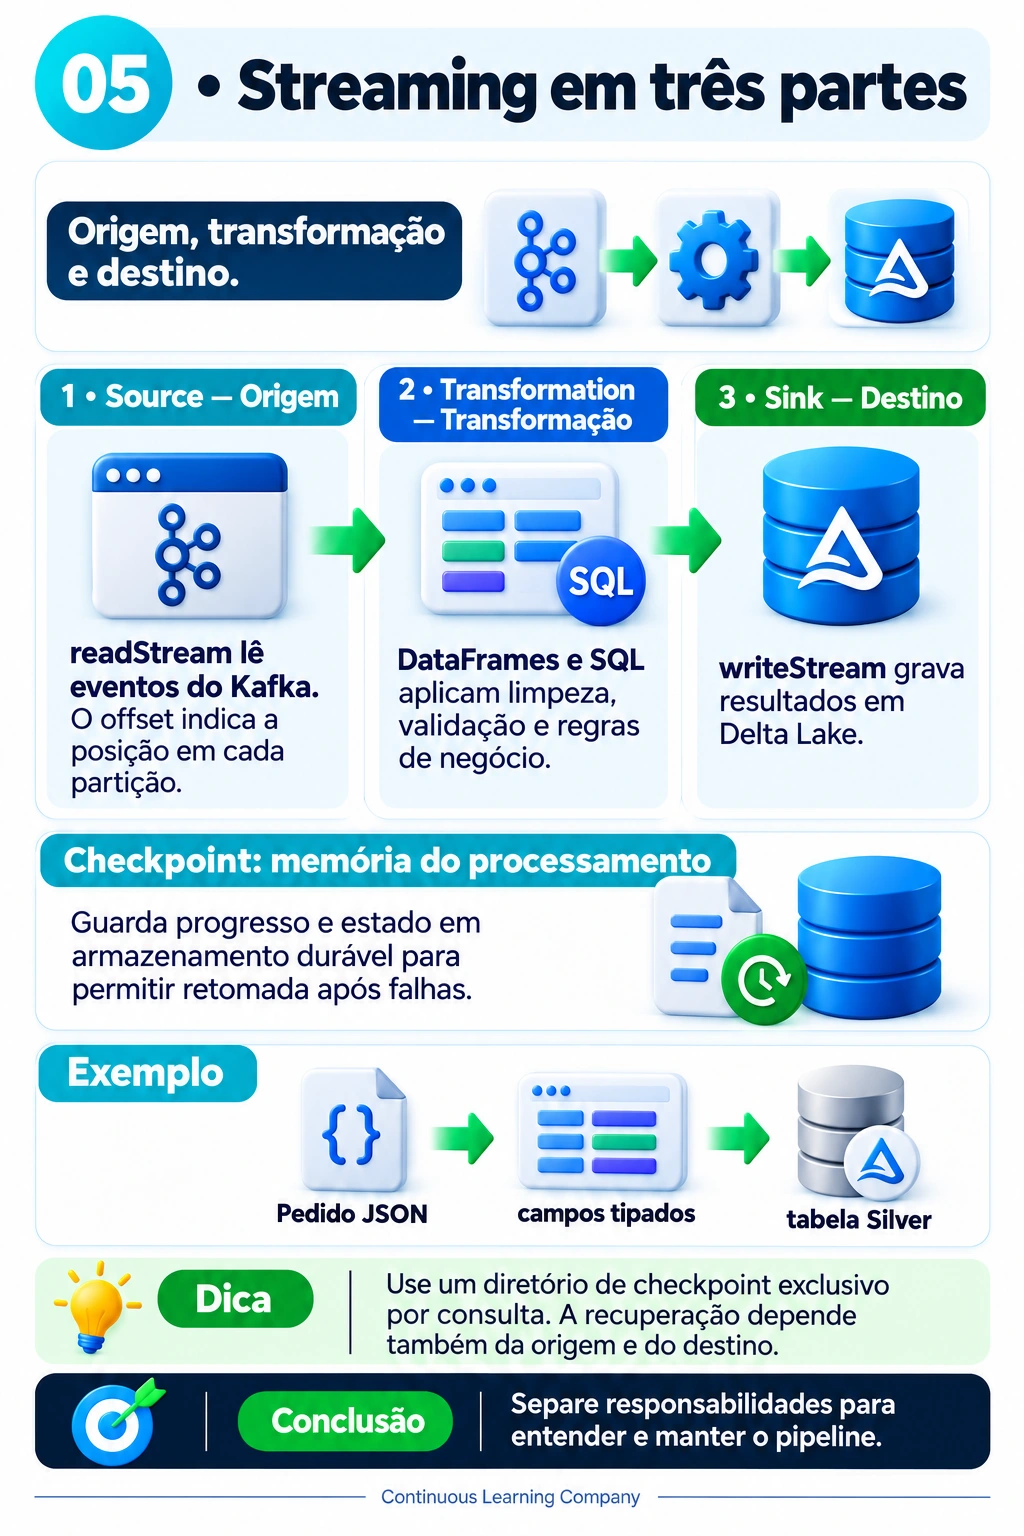
Uma pergunta simples para cada responsabilidade
Uma loja recebe pedidos continuamente. Para transformar essas mensagens em dados utilizáveis, separe três perguntas: de onde os eventos vêm, o que precisa mudar e onde o resultado será gravado? Essa separação ajuda a explicar o pipeline e a localizar problemas sem misturar leitura, regras de negócio e armazenamento.
Este conteúdo aprofunda a divisão de responsabilidades. Para uma visão mais ampla do motor, veja Spark Structured Streaming; para a organização das tabelas em camadas, consulte Lakehouse com Delta. Aqui o foco é ligar origem, transformação e destino em um exemplo de pedidos.
Kafka + readStream: leia eventos e metadados.
DataFrames ou SQL: interprete e valide.
writeStream + Delta: grave os pedidos válidos.
1. Source: leia eventos e reconheça sua posição
Kafka organiza eventos em tópicos divididos em partições. O offset identifica uma posição dentro de uma partição; não é um número global do tópico. Duas partições podem ter o mesmo offset. Para rastrear um registro, mantenha tópico, partição e offset juntos.[1][2]
No Spark, readStream.format("kafka") configura a entrada. A mensagem chega em value como bytes; converter para texto não valida o JSON nem aplica o contrato da loja. A opção startingOffsets define a posição inicial de uma consulta nova. Ao retomar um checkpoint válido, o progresso salvo é que orienta a continuação.[2]
2. Transformation: dê significado e qualidade aos campos
DataFrames e SQL descrevem as transformações: interpretar o JSON, selecionar colunas, converter tipos e aplicar regras. Neste exemplo, o contrato espera identificador, valor decimal e horário do evento. A função from_json interpreta a mensagem com um esquema explícito; mensagens ou campos inválidos precisam de tratamento.[3][4]
A loja aceita apenas identificador preenchido, valor maior que zero e horário interpretável. Um número negativo pode ser um decimal perfeitamente válido e, mesmo assim, violar a regra do pedido. Por isso, tipagem e validação de negócio são verificações diferentes. Planeje preservar a entrada e investigar rejeitados; filtrar não é corrigir o dado.
3. Sink: materialize os resultados
O destino é configurado com writeStream. Aqui usamos Delta Lake, modo append e uma tabela de pedidos válidos chamada Silver. A transformação é sem agregação: cada pedido aprovado mantém seu nível de detalhe. Uma tabela Silver é uma decisão de organização da arquitetura, não um modo especial de escrita do Spark.[3][5]
Descrever a leitura e as transformações ainda não inicia a consulta. O método start cria a execução em streaming. O exemplo permanece ativo para acompanhar novas mensagens; awaitTermination mantém o programa aguardando seu término.[3]
Checkpoint: progresso durável, não uma quarta camada de dados
O checkpoint registra o progresso e os commits dos micro-lotes. Quando existem operações com estado, como agregações, participa também da recuperação desse estado. O exemplo de filtro não mantém uma soma entre lotes. Use um diretório durável e exclusivo por consulta, separado do destino dos dados; não o compartilhe com outra execução independente.[3][6]
Na retomada, mantenha a identidade da consulta e o checkpoint compatível. Mudanças de fontes, destinos ou operações com estado podem impedir a reutilização. Não apague a pasta para tentar resolver uma falha sem planejar o reprocessamento.[6]
A recuperação depende também da origem e do destino: os eventos necessários precisam continuar disponíveis no Kafka, e o destino deve suportar as garantias pretendidas. Delta oferece integração transacional com streaming, mas isso não remove duplicidades de negócio publicadas como novos eventos. Evite prometer processamento exatamente uma vez para qualquer combinação de componentes.[2][3][5]
Exemplo prático: pedido JSON até a Silver
O código abaixo é um modelo para executar no seu ambiente, não um cluster executado por este site. É necessário ter Spark com conectores Kafka e Delta compatíveis, acesso ao broker, tópico de teste e armazenamento durável. Configure autenticação e permissões pelo mecanismo seguro do ambiente; não coloque credenciais no código publicado. Substitua broker e caminhos antes de executar.
Passo A — Configure a origem
from pyspark.sql import functions as F
from pyspark.sql.types import (
    StructType, StructField, StringType,
    DecimalType, TimestampType,
)

# A sessão spark já precisa de Kafka e Delta configurados.
spark.conf.set("spark.sql.session.timeZone", "UTC")
broker = "SEU_BROKER:9092"
destino = "/dados/demo_streaming/silver/pedidos"
checkpoint = "/dados/checkpoints/demo_streaming/pedidos_silver"

# 1. ORIGEM: use um tópico exclusivo de teste.
entrada = (
    spark.readStream.format("kafka")
    .option("kafka.bootstrap.servers", broker)
    .option("subscribe", "pedidos")
    .option("startingOffsets", "earliest")
    .load()
    .select(
        F.col("value").cast("string").alias("payload"),
        "topic", "partition", "offset",
    )
)
Em uma consulta nova, earliest considera os eventos ainda retidos, não recupera mensagens já removidas do Kafka. Na retomada, não use essa opção como substituta do checkpoint.[2]
Passo B — Interprete e valide
# 2. TRANSFORMAÇÃO: contrato e regras do pedido.
schema = StructType([
    StructField("pedido_id", StringType()),
    StructField("valor", DecimalType(12, 2)),
    StructField("event_time", TimestampType()),
])

interpretados = entrada.select(
    "payload", "topic", "partition", "offset",
    F.from_json("payload", schema).alias("pedido"),
).select("payload", "topic", "partition", "offset", "pedido.*")

validos = interpretados.filter(
    F.col("pedido_id").isNotNull()
    & (F.length(F.trim(F.col("pedido_id"))) > 0)
    & F.col("valor").isNotNull()
    & (F.col("valor") > 0)
    & F.col("event_time").isNotNull()
)
Passo C — Inicie a escrita em Delta
# 3. DESTINO: checkpoint exclusivo desta consulta.
consulta = (
    validos.writeStream.format("delta")
    .outputMode("append")
    .option("checkpointLocation", checkpoint)
    .queryName("pedidos_silver_demo")
    .start(destino)
)

consulta.awaitTermination()
O programa aguarda no último comando. Em notebook, monitore e pare a consulta de forma controlada em outra célula, por exemplo com consulta.stop(). Reutilizar o mesmo checkpoint compatível permite retomar; este exemplo não implementa deduplicação, atualizações de pedidos nem saída de quarentena.[3][6]
Laboratório guiado: acompanhe quatro mensagens
Publique em um tópico isolado os três objetos abaixo e uma mensagem com o texto json-invalido. Este laboratório é guiado: o navegador não se conecta ao Kafka.
{"pedido_id": "P001", "valor": 99.9, "event_time": "2026-10-19T10:00:00Z"}
{"pedido_id": "P002", "valor": -10.0, "event_time": "2026-10-19T10:00:01Z"}
{"pedido_id": "P003", "valor": 40.1, "event_time": "2026-10-19T10:00:02Z"}
json-invalido
Resultado esperado pelas regras: P001 e P003 seguem para a Silver. P002 é rejeitado pelo valor negativo; a mensagem inválida não produz os campos obrigatórios. São dois registros aprovados, sem agregação. Isso é uma expectativa derivada da amostra, não uma saída observada de um cluster.
Confirme as linhas no destino em outra sessão com suporte Delta. Depois, interrompa e reinicie a mesma consulta com o checkpoint preservado, publique um novo pedido e observe o progresso. Registre falhas e rejeições. Não apague o checkpoint nem reutilize o diretório em outra consulta durante o teste.
Conclusão
Separar responsabilidades facilita a manutenção: Source explica a leitura e a posição dos eventos; Transformation define o significado e a qualidade; Sink materializa o resultado. O checkpoint sustenta a retomada da consulta, em conjunto com as condições da origem e do destino. Pratique a identificação desses papéis no jogo abaixo e revise os conceitos no quiz.
Continue sua trilha
Trilha de Engenharia de Dados · 0% concluído · 0 de 24 conteúdos concluídos
Você concluiu: ✓ Streaming em três partes: origem, transformação e destino
Jogo: quem resolve esta missão?
Leia o desafio e escolha a responsabilidade correta. Você pode tentar novamente após um erro. A pontuação considera os acertos na primeira tentativa. Não há cronômetro.
Quiz: revise as três responsabilidades
Responda às seis questões e confira as explicações.
1. Qual é a responsabilidade da origem?
Resposta correta: A) Ler os eventos e seus metadados.
Source define a leitura; transformação e destino têm outros papéis.
2. O que um offset identifica no Kafka?
Resposta correta: B) Uma posição dentro de uma partição.
Para rastrear um registro, considere tópico, partição e offset juntos.
3. Qual operação pertence à transformação?
Resposta correta: C) Interpretar o JSON e validar o valor do pedido.
Tipagem, limpeza e regras de negócio são responsabilidade da transformação.
4. Qual configuração corresponde ao destino deste exemplo?
Resposta correta: D) writeStream com formato delta e modo append.
A escrita em Delta materializa os pedidos válidos e é iniciada com start.
5. Qual é o uso correto do checkpoint?
Resposta correta: A) Diretório durável e exclusivo por consulta, com retomada compatível.
Progresso durável não dispensa origem disponível, destino compatível ou regras de deduplicação.
6. O que esperamos das quatro mensagens do laboratório?
Resposta correta: B) P001 e P003 aprovados; os outros dois rejeitados.
O filtro aprova os pedidos com ID preenchido, valor positivo e horário válido; não faz agregação.
Referências oficiais
Documentação consultada em 19/10/2026. Confira a compatibilidade de Spark, Kafka e Delta no seu ambiente.